
起因很具体:手上有一堆埋点数据要做分析,Excel 已经拉不动了,同事甩过来一句「用 Python 吧,pandas 十行搞定」。我平时写前端,JavaScript 用得熟,本以为换个语言就是换套语法,结果第一天就被缩进、元组和 is 这几个东西绊住了好几次。
这篇是我边学边记的整理稿。它不是教程,更像是一份「JavaScript 写多了的人来学 Python 会在哪里卡住」的对照笔记,每个知识点后面尽量补一句为什么这么设计、什么时候会翻车。代码能跑的都跑过一遍,跑不通的地方我也标出来了。
在本篇文章中,我们将从浅入深,和大家一起学习以下知识:
- Python 的定位和特点,以及它为什么慢却还是数据分析首选
- 注释、命名、保留字这些语法地基,和
input/eval/print三个入门函数 - 基本类型的分类,以及类型判断为什么推荐
isinstance而不是type - 序列的共性,可变类型与不可变类型的分界线在哪
- 运算符里最容易记混的
is与== - 循环、条件、枚举的写法
- 闭包、
lambda、map/reduce/filter与装饰器 - 面向对象的类变量、实例变量、私有成员和继承
- 正则、内建函数、标准库全景
- 异常处理与 JSON 序列化
- 一个能跑的原生爬虫例子
datetime和random两个高频库的用法- 列表推导式等日常提效技巧
这篇偏细节和代码,配套的Python基础小结(二)是一整套思维导图,负责把知识结构串起来,两篇搭配着看会顺一些。
# 一、导语
先说 Python 是个什么语言。它是解释型语言,源码不需要提前编译成机器码,交给解释器逐行执行。改完就能跑,跨平台成本很低,代价是执行速度比 C、Java 这类编译型语言慢。
那它能做什么:
- 大数据分析
- 自动化运维与自动化测试
- web 开发,常用框架有
flask、django - 机器学习,比如
TensorFlow - 胶水语言,比如混合 C++、Java 编程,把其他语言编写的模块连接在一起
最后那条「胶水语言」值得多说一句。Python 自己跑得不快,但它能很轻松地把 C 写的高性能库包起来调用。所以做数据分析时你写的是 Python,真正干活的是 NumPy 里的 C 代码。这就解释了那个常见的疑问,既然慢为什么大家还都用它?因为慢的那部分早就被换掉了,留给你的是开发效率。
Python 语言的特点
- 语法简洁
- 可跨平台
- 应用广泛
- 支持中文
- 强制可读:通过强制缩进体现语句间的逻辑关系,提高了程序的可读性
- 模式多样:语法层面同时支持面向过程和面向对象两种编程方式
- 粘性扩展:通过接口和函数集成其他语言编写的代码
- 开源理念
- 库类丰富
「强制可读」这条是从 JavaScript 转过来最不习惯的地方。别的语言用花括号划分代码块,缩进只是风格;Python 把缩进写进了语法,缩进错了直接是语法错误。适应之后其实挺好,团队里再也不会有人为大括号换不换行吵架。这里有个坑要注意,Tab 和空格混用会报 TabError,官方推荐统一用 4 个空格,编辑器里配好自动转换。
Python 语言开发环境配置
Python解释器IDLE开发环境- 交互式启动
- 文件式启动
Python语言集成开发环境PyCharm
刚入门用自带的 IDLE 或者命令行的交互式解释器就够了,写一行看一行结果,学语法最快。项目大起来再换 PyCharm 或者 VS Code 配 Python 插件。
# 二、基本知识
这一节是语法地基,看着枯燥,但后面每一处报错基本都能追回到这里。
# 注释
注释是辅助性文字,不被执行。单行注释以 # 开头:
# 这是注释
多行注释以 '''(3 个单引号)开头和结尾:
'''
这是注释
这也是注释
这还是注释
'''
三引号那种严格来说不是注释语法,它是一个没有赋值给任何变量的字符串字面量,解释器算出来之后就丢掉了,效果上等同于注释。写在函数或类的第一行时它有正式身份,叫文档字符串,help() 和 IDE 的提示都读它。
# 命名
命名是为变量关联标识符的过程,用于确保程序元素的唯一性。规则有四条:
- 标识符由字母、数字、下划线(和汉字)等字符及其组合构成
- 标识符的首字符不能是数字,且中间不能出现空格
- 标识符对大小写敏感
- 不能和保留字重名
汉字确实能当变量名,但除了写演示代码没什么实用价值,团队协作里别这么干。命名风格上,Python 社区用下划线分隔的 user_name 而不是驼峰的 userName,这一点和 JavaScript 相反,PEP 8 里写得很明确。
# 保留字
保留字(Keyword)也被称为关键字,是被编程语言内部定义并保留使用的标识符,不能拿来当变量名。
Python 的标准库提供了一个 keyword 模块,可以输出当前版本的所有关键字:
>>> import keyword
>>> ls = keyword.kwlist
>>> ls
>>> len(ls)
33
Python 3 早期版本有 33 个保留字
TrueFalseNoneandasassertbreakclasscontinuedefdelelifelseexceptfinallyforfromglobalifimportinislambdanonlocalnotorpassraisereturntrywhilewithyield
这个 33 是当时跑出来的数字,现在得改一下。从 Python 3.7 开始 async 和 await 正式成为关键字,keyword.kwlist 的长度变成了 35。3.10 之后又引入了 match、case、_ 这三个软关键字,它们不在 kwlist 里,而是单独放在 keyword.softkwlist,仍然可以当变量名用。所以别背数字,直接在你自己的解释器里跑一次 len(keyword.kwlist) 最靠谱。
# input() 函数
使用 input() 函数从控制台获得用户输入,它以字符串类型返回结果。
这里有个新手必踩的坑:不管用户输入的是不是数字,input() 拿到的永远是 str。想做加法得先 int() 转一次,否则 '1' + '2' 会得到 '12' 而不是 3。
# eval() 函数
eval(<字符串>) 函数的作用是把输入的字符串当成 Python 表达式来求值并执行。
x = eval(input("请输入:"))
这样写确实省事,用户输入 1+2 直接得到 3。但生产代码里别用它接用户输入,因为 eval 会执行任意表达式,输入里塞一句删文件的代码它也照跑。只需要把字符串转成数字或者列表字典,用 int()、float() 或者 ast.literal_eval(),后者只解析字面量,不执行代码。
# print() 函数
print() 函数可以输出字符信息,也可以用字符的形式输出变量。输出字符信息时,直接把待输出内容传给它;输出变量值时,用槽格式配合 format() 方法将变量和字符串结合到一起输出。
print('{}今年{}岁'.format('poetries', 22))
Python 3.6 之后有了更短的 f-string 写法,print(f'{name}今年{age}岁'),直接把变量写进大括号里,可读性好很多,现在基本是首选。原来的 % 格式化和 format() 仍然能用,读老代码时会遇到。
# 函数
函数可以理解为对一组表达特定功能的表达式的封装,把特定功能的代码写在一个函数里,程序的模块化更好,也便于阅读和复用。通过保留字 def 自定义函数。
# 文件操作
文件读写是最容易忘记收尾的一类操作。
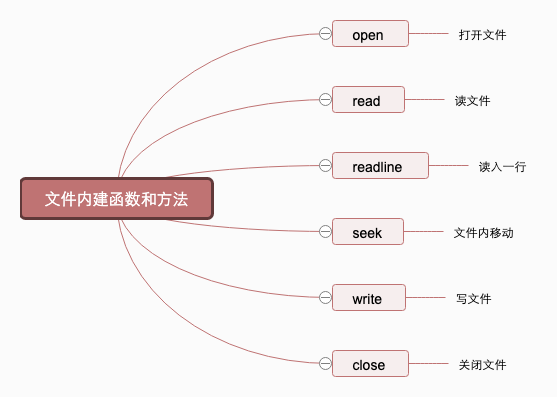
图里 r、w、a、b、+ 这几个模式要分清。w 是写入并清空原有内容,a 是追加,用错一个字母就是把文件清空了。带 b 的是二进制模式,读图片、压缩包必须用它。
# 使用with操作文件
with open(os.path.dirname(__file__) + '/blog.text','w') as f:
    f.write(json.dumps(data))
这段用的是 with 语句。它的价值在于不管代码块里发生什么,哪怕中间抛异常,退出时都会自动帮你关闭文件句柄。手写 f = open(...) 加 f.close() 也能跑,但只要中间抛了异常,close 就执行不到,句柄一直被占着。所以文件操作一律用 with,这条没有例外。
顺带补一个坑,open() 在不同系统上的默认编码不一样,读中文文本时最好显式写 encoding='utf-8',不然在 Windows 上很容易撞上 UnicodeDecodeError。
除了纯文本,日常还会碰到路径、图片、Excel 这几类操作,标准库和常用第三方库的分工是这样的。
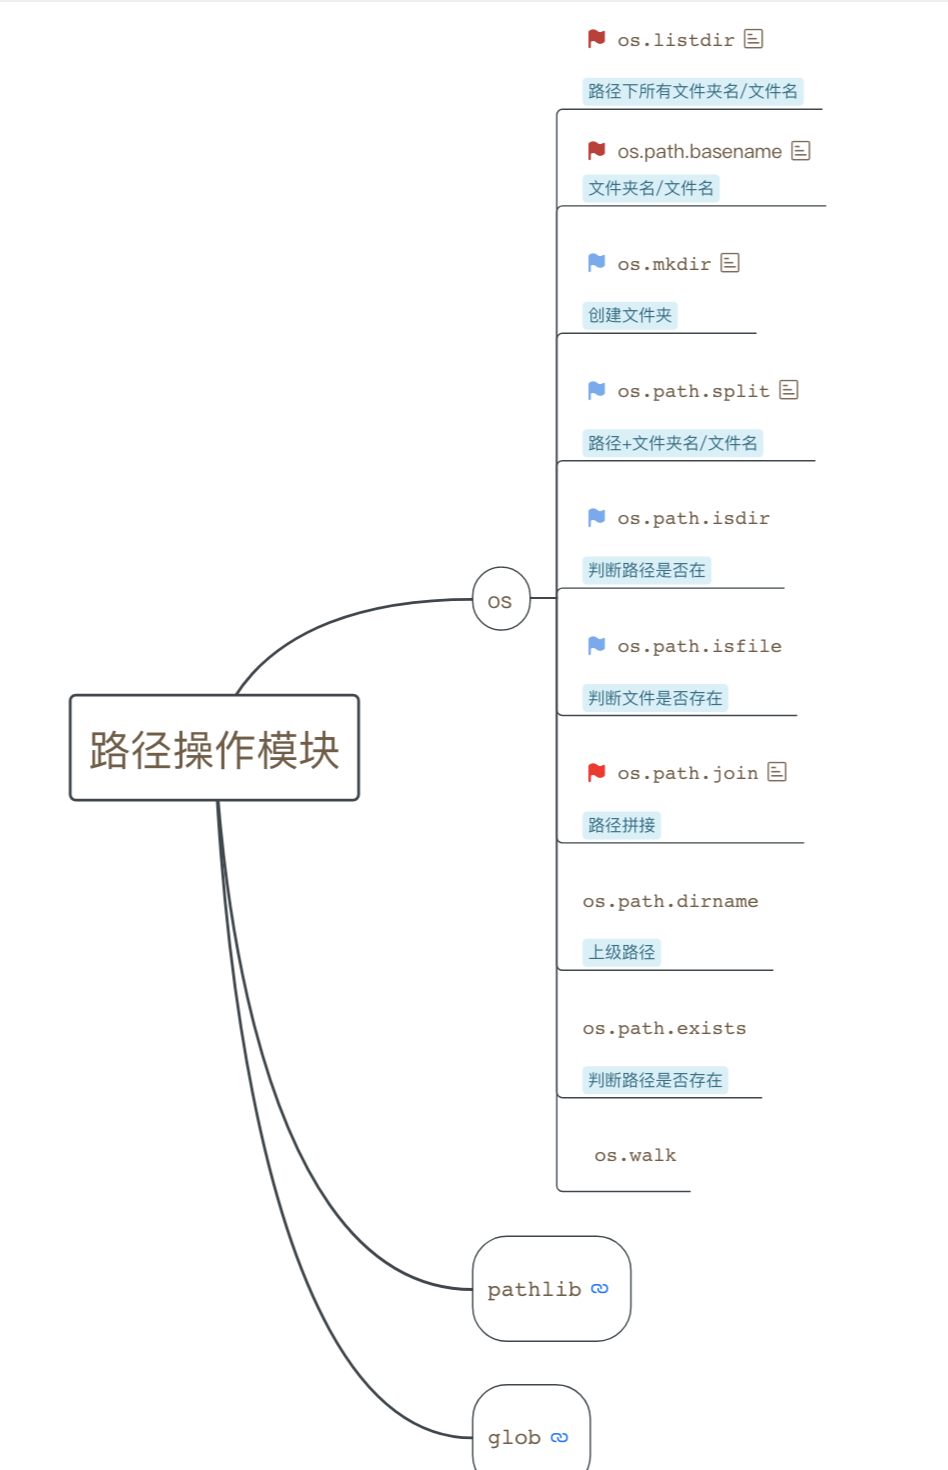
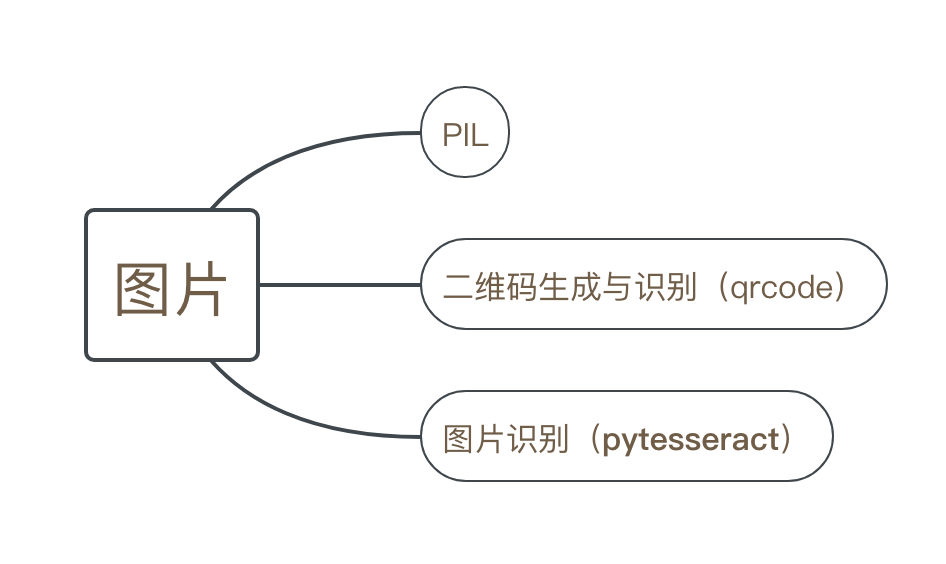
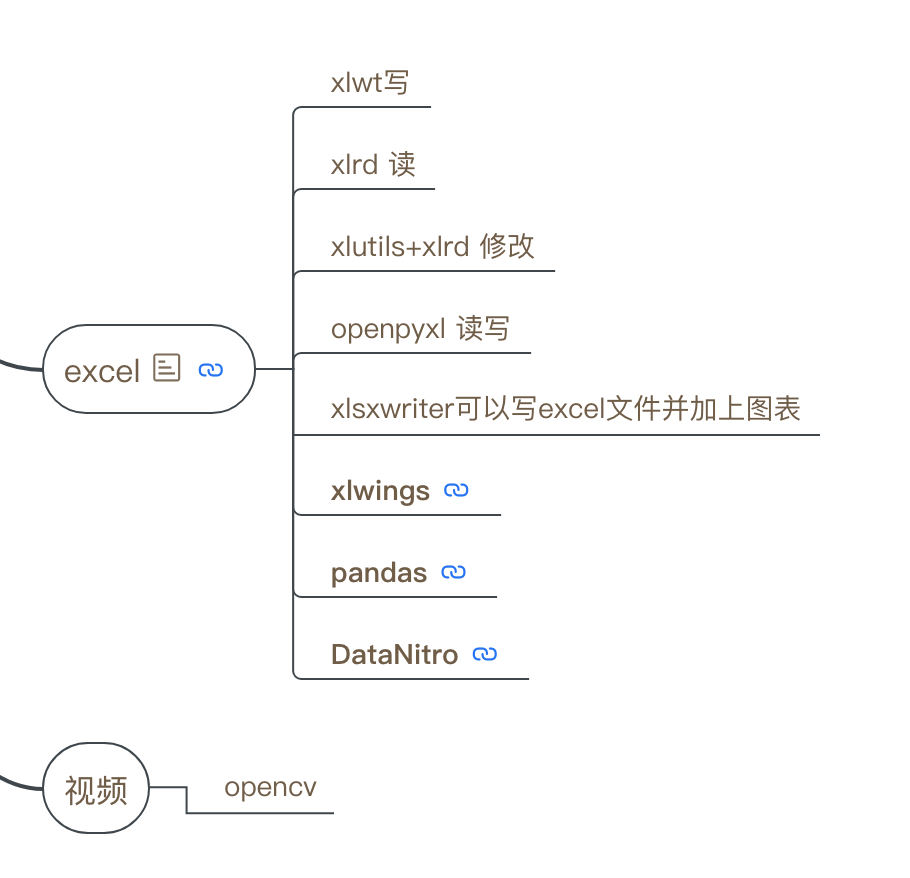
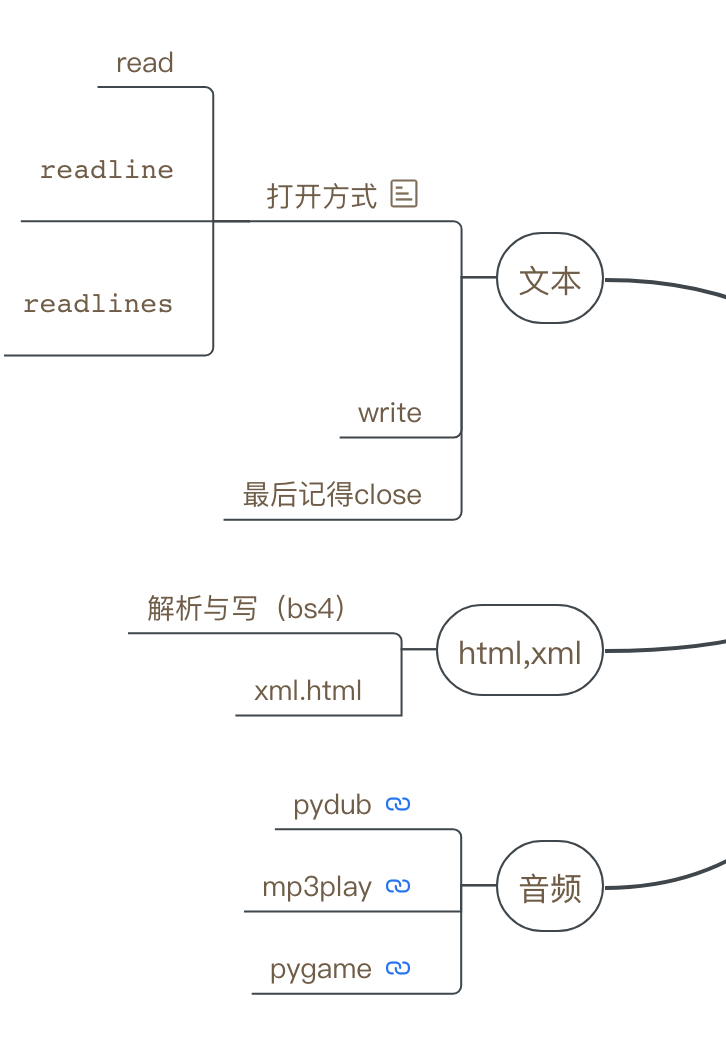
路径这块推荐直接上 pathlib。它把路径当对象处理,拼接用 / 运算符,Path('a') / 'b' / 'c.txt' 比 os.path.join 直观,而且天然跨平台,不用操心 Windows 的反斜杠。老代码里 os.path 更常见,新写的建议换。
# 三、基本类型
先看全景。
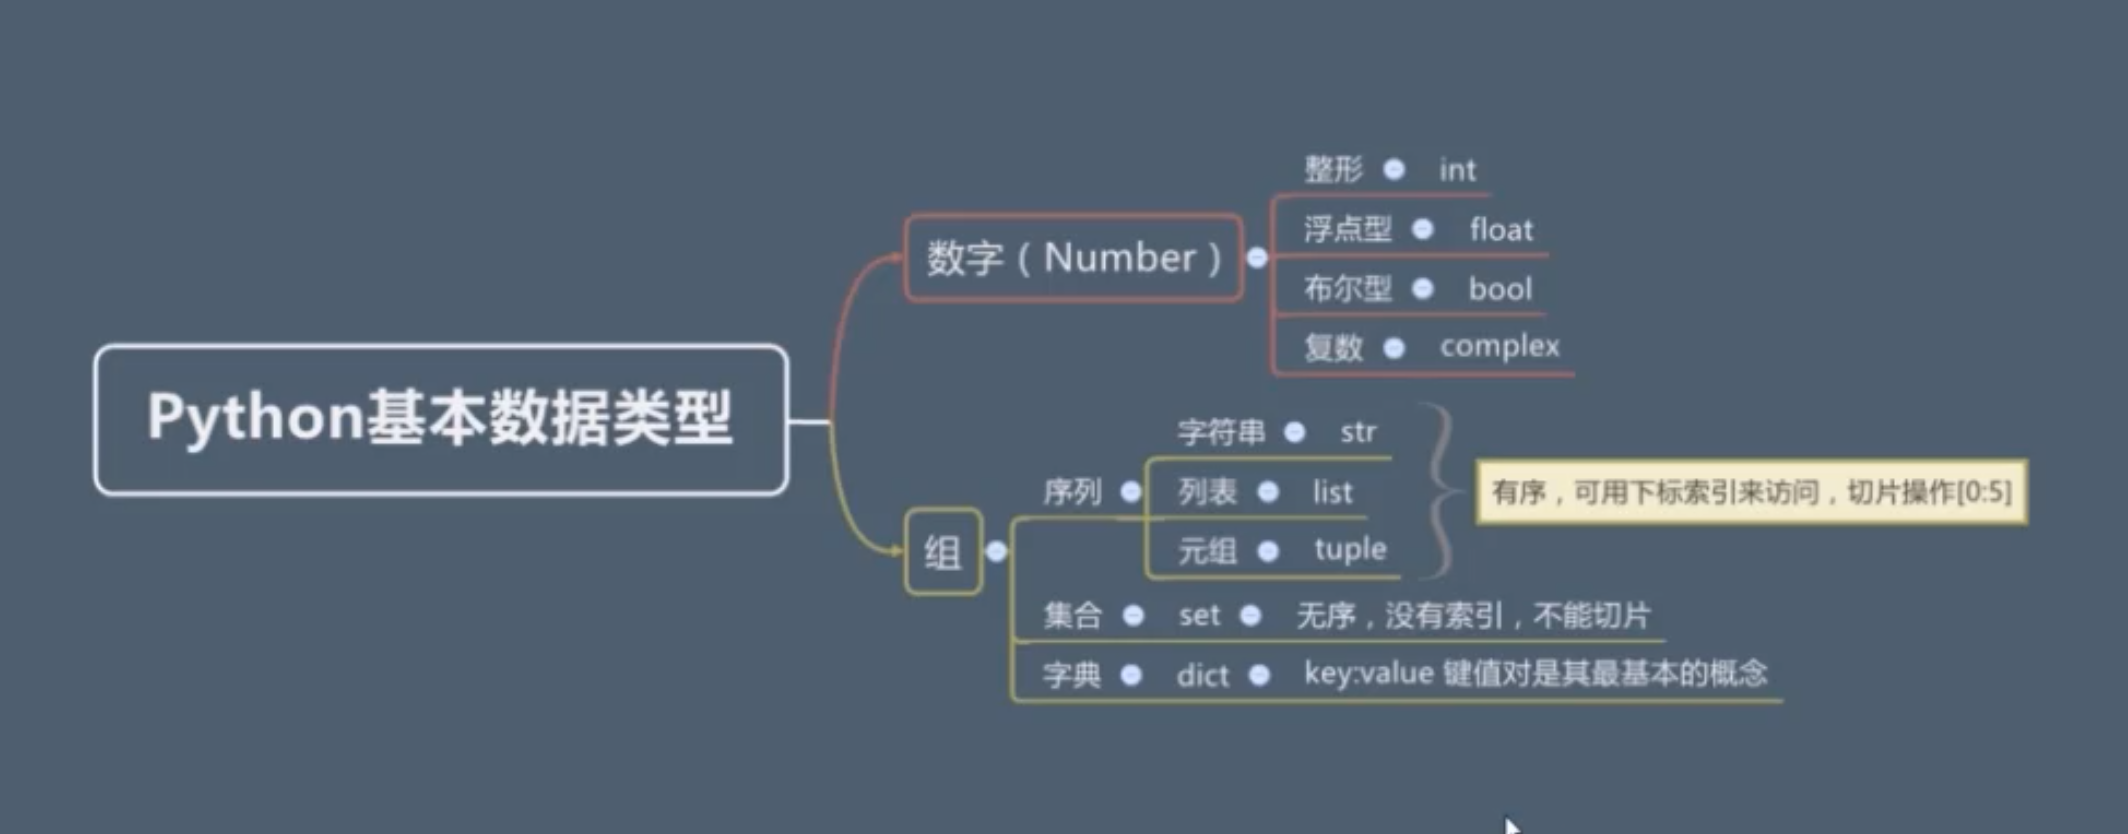
类型判断的两个方式
type判断基本类型,如type(10) == int,不推荐isinstance(值, 类型),也可以传一个元组一次判断多种,如isinstance(值, (int, float, str))- 例:
isinstance(1, int)
- 例:
为什么不推荐 type?因为它做的是精确相等比较,不认继承关系。一个继承自 int 的子类实例,type(x) == int 是 False,而 isinstance(x, int) 是 True。面向对象里子类应该能当父类用,isinstance 才符合这个预期。
下面是各个类型的细节:
Numberintfloatcomplex复数,如36j
Boolbool('')/bool([])/bool({})/bool(0)/bool(None)- 都会转化为
False
- 字符串
str(序列)- 单引号
- 双引号
- 三引号(可以换行写多行字符串,和 ES6 的反引号类似)
- 在字符串前面加一个
r,它就不是普通字符串而是原始字符串,会原样输出,print(r'\n88fafa')里的\n不会被转义
list列表(序列)tuple元组(序列)- 集合
set(无序,没有索引,不能切片,元素唯一不能重复,只有value没有key),写法如{1,2,3,4}1 in {1,2,3}1 not in {1,2,3,4}- 两个集合求差集
{1,2,3} - {4,5} - 两个集合求交集
{1,2,3,4} & {2,3} - 并集
{1,2,3,4,5,6} | {3,4,7} - 定义一个空的集合用
set()
- 字典
dict(key-value 成对出现,这是它和只有 value 的集合最大的差别)- 由很多
key-value组成,不能有相同的键 key必须是不可变类型,可以是int/str/tuplevalue可以是int/str/float/list/set/dict- 定义一个空的字典用
{}
- 由很多
原文这里把字典写成了「有 key 无 value」,是笔误,字典当然是键值成对的,我按实际行为改过来了。倒是空集合那条要记牢,{} 得到的是空字典不是空集合,想要空集合只能写 set()。
那为什么字典的 key 必须用不可变类型呢?因为字典靠 key 的哈希值决定数据存在哪个槽位。如果 key 存进去之后还能被修改,哈希值就变了,之前存的那条数据再也定位不到。列表可变,所以不能当 key;元组不可变,可以。


