
用户在群里甩来一张截图,说点了提交按钮没反应。你问他什么机型、什么网络、报了什么错,对面回一句「就是没反应啊」。然后你打开自己的 Chrome,一切正常。
这种对话我经历过太多次了。没有监控的时候,线上对前端来说就是一个黑盒,能不能复现全看运气。这篇是我把前端监控这套东西从指标定义、采集、上报、存储一直到告警和看板整个走了一遍之后的笔记合集,里面有能直接抄走的采集代码,也有踩过的坑。读完你至少能自己搭出一个跑得起来的最小监控系统,而不是只会说「我们接了 Sentry」。
在本篇文章中,我们将从浅入深,和大家一起学习以下知识:
- 一套完整前端监控系统的骨架长什么样,从采集到看板一共几层
- 首屏时间(FMP)在 SPA 场景下怎么算,包含图片的页面为什么会算错
- 白屏、卡顿、网络环境这三类指标各自的采集口径和代码
- 性能 SDK 怎么设计才好接入,抽样、过滤、上报时机怎么定
- 数据接入层为什么必须过一层 Kafka,清洗和计算分别做什么
- 告警规则怎么配,什么样的问题值得叫醒人
- JS 错误、接口异常、资源加载失败三条线的捕获方式
- 用 Node.js + Logstash + Elasticsearch 手搭一套监控后端的完整流程
- 首屏秒开的四重保障和白屏 300ms 的具体优化手段
- 上线前该过一遍的 checklist
# 一、先把整套系统的骨架摆出来
很多人一上来就问「用什么 SDK」,这个问题问早了。前端监控不是一个 SDK 的事,它是一条从浏览器一直通到告警群的链路,任何一环断了,前面做得再精细都白搭。
先看这块,把整条链路画出来大概是这样:
                     浏览器 / WebView 里跑的那段 JS
 ┌────────────────────────────────────────────────────────────┐
 │ 采集层 SDK                                                  │
 │  ├─ 性能:FP / FMP / 瀑布流各阶段耗时 / FPS                  │
 │  ├─ 错误:onerror / unhandledrejection / resource error      │
 │  ├─ 接口:XMLHttpRequest 与 fetch 劫持                       │
 │  └─ 自定义:业务手动调用 report()                            │
 └───────────────┬────────────────────────────────────────────┘
                 │ 校验 → 过滤异常值 → 抽样 → 按网络状况决定时机
                 ▼
 ┌────────────────────────────────────────────────────────────┐
 │ 上报层    1x1 gif(GET) / POST / sendBeacon                 │
 └───────────────┬────────────────────────────────────────────┘
                 ▼
 ┌────────────────────────────────────────────────────────────┐
 │ 接入层    Node.js 服务,解参数、校验站点 id、写本地日志       │
 └───────────────┬────────────────────────────────────────────┘
                 ▼
 ┌──────────────────────────┐     ┌──────────────────────────┐
 │ 清洗计算                 │────▶│ 存储                      │
 │ Kafka / Logstash 接数据  │     │ ES(明细查询)            │
 │ Spark 离线 + Flink 实时  │     │ Hive / MongoDB(聚合结果)│
 └──────────────────────────┘     └──────────┬───────────────┘
                 ┌──────────────────────────┬─┘
                 ▼                          ▼
        ┌──────────────────┐      ┌────────────────────────┐
        │ 告警              │      │ 看板                    │
        │ 定时任务扫规则表  │      │ 大盘页 + 详情页         │
        │ 企微 / 邮件 / 短信│      │ React + AntdPro + AntV  │
        └──────────────────┘      └────────────────────────┘
这五层的落地顺序,我的建议是这样排:
- Step 1:先定指标口径。首屏算到哪一刻、白屏用哪两个时间点相减、卡顿的阈值是多少,这些不定死,后面所有数据都没法横向比。
- Step 2:写采集 SDK,先只做错误捕获这一条线。错误是最容易看到收益的,接上去当天就能捞到线上问题。
- Step 3:搭接入层。一个 Node 服务 + 落本地日志就够了,先别想着上大数据。
- Step 4:接存储和查询。日志用 Logstash 送进 ES,配个 Kibana 或者 es-head 就能开始查。
- Step 5:补性能采集。等错误这条线跑顺了再加性能,因为性能指标的口径争议远比错误多。
- Step 6:最后做告警和看板。有了稳定的数据才谈得上定阈值。
我一开始也是反过来做的,先花两周做了一个很漂亮的大盘,结果数据口径改了三次,图表全部返工。回到这个顺序上,先有数据,再有展示,返工成本会低很多。
后面的章节就按这条链路一层一层往下拆。
# 二、性能优化方法论
在动手写采集代码之前,得先想清楚一件事:我们到底在优化什么。性能不是一个数,它是一串可以拆开的时间段,只有拆开了才知道该在哪一段下手。
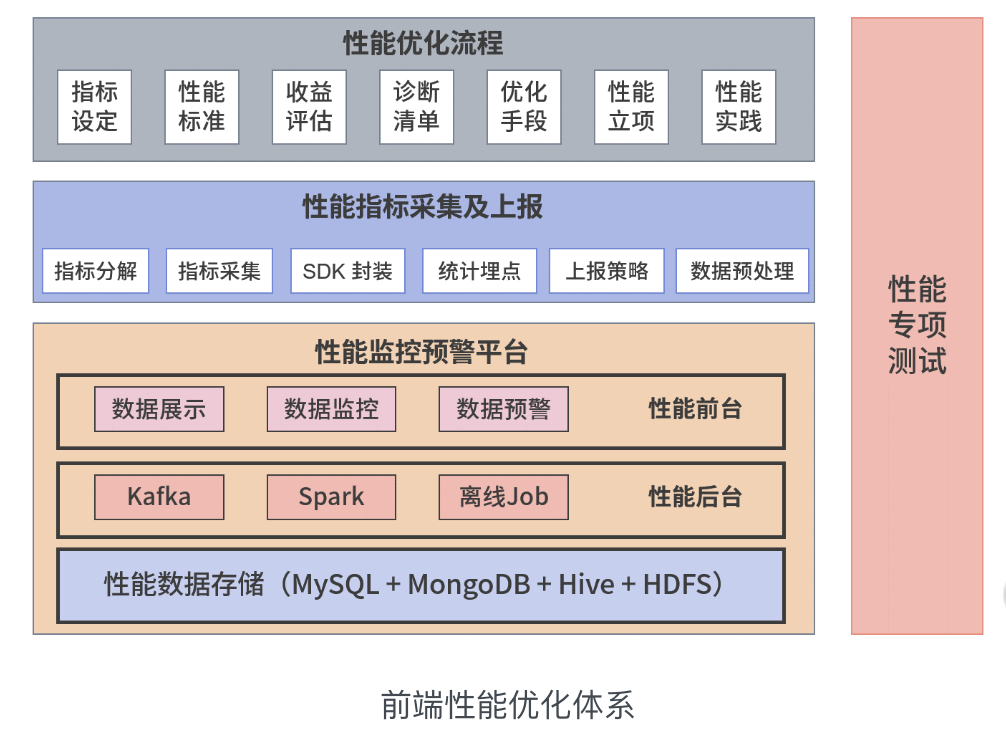
首屏时间可以拆分为白屏时间、数据接口响应时间、图片加载资源等
这句话是整篇的地基。用户抱怨「慢」的时候,慢在哪一段是完全不同的问题:白屏长通常是 DNS、连接和首字节的问题;接口响应慢要找后端;图片加载慢那是资源体积和 CDN 的事。拿不到分段数据,优化就只能靠猜。
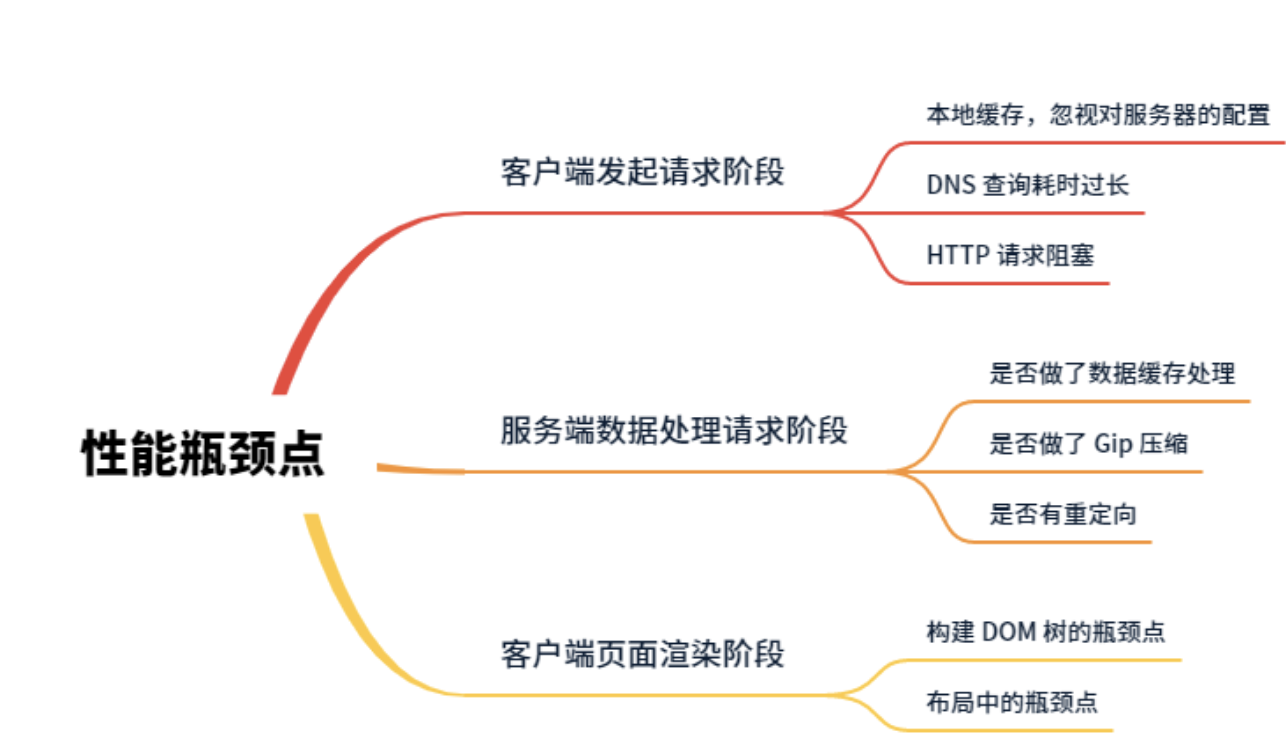
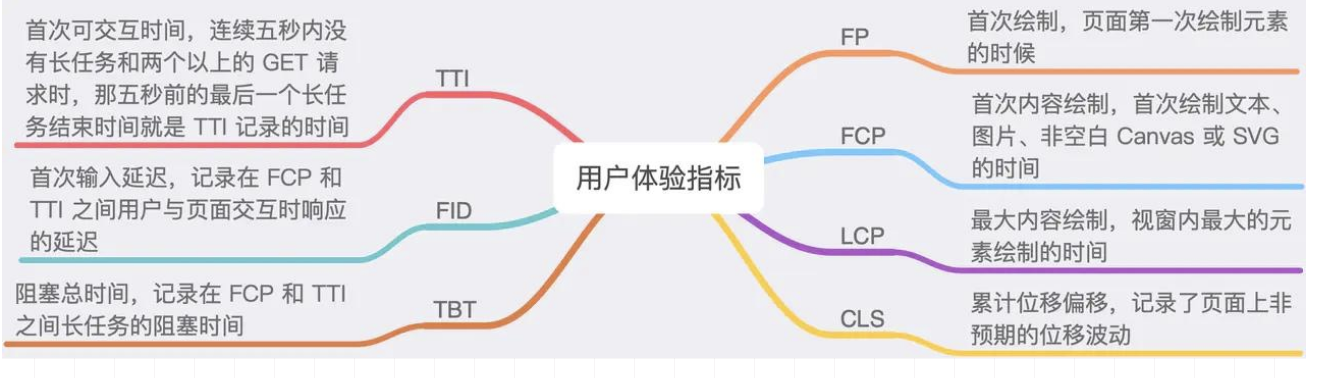
这两张图把「指标 → 归因 → 手段」串了起来。看图的时候重点不是记住每个格子,而是记住这个链条本身:任何一个优化动作,都应该能回答「它改善的是哪个指标的哪一段」。答不上来的优化,多半是在做无用功。
顺着上面聊,指标从哪儿来?这就到采集环节了。
# 三、指标采集:首屏时间指标采集具体办法
首屏时间(FMP,First Meaningful Paint)是所有性能指标里最难算准的一个,因为「有意义的内容出现了」这句话本身就没有统一定义。业界的做法分两派,手动打点和自动化采集,各有各的问题。
# 手动采集办法及优缺点
所谓手动采集,一般是通过埋点的方式进行,比如在页面开始位置打上 FMP.Start(),在首屏结束位置打上 FMP.End(),利用 FMP.End()-FMP.Start() 获取到首屏时间。
听起来很直观,做起来全是麻烦。手动采集的统计结果并不精确,因为它依赖于人,每个人对首屏的理解有偏差,经常打错或者忘记打点。更麻烦的是页面改版之后,那个 FMP.End() 常常还留在原来的组件里,数据看着挺稳定,其实早就量错了地方。
这个我踩过,一个列表页改成了骨架屏方案,结算点还挂在旧的 loading 隐藏逻辑上,数据一夜之间「优化」了 400ms,实际用户体验一点没变。
# 自动化采集优势及办法
所谓自动化采集,即引入一段通用的代码来做首屏时间自动化采集,引入过程中,除了必要的配置不需要做其他事情。
自动化采集的好处是独立性更强,接入过程更自动化。具体的自动化采集代码,可以由一个公共团队来开发,试点后,推广到各个业务团队。而且统计结果更标准化,同一段统计代码,标准更统一,业务侧同学也更认可这个统计结果。
标准统一这一点特别重要。监控数据的价值不在绝对值,而在可比较:A 页面 1.2s、B 页面 2.8s,这个对比成立的前提是两边用同一把尺子。手动埋点做不到这件事。
当然,它也有缺点,最明显的是,有些个性化需求无法满足,毕竟在工作中,总会有一些特殊业务场景。所以,采用自动化采集方案必须做一些取舍。我的取舍是:主指标一律走自动化,个别页面确实需要精确到某个业务节点的,再额外开一个自定义埋点,两套数据分开存,不要混在一起算平均。
# 单页面(SPA)应用业务下的采集办法
SPA 页面因为无法基于 DOMContentLoaded 做首屏指标采集,可以使用 MutationObserver 采集首屏时间。
MutationObserver接口提供了监视对 DOM 树所做更改的能力。它被设计为旧的Mutation Events功能的替代品,该功能是 DOM3 Events 规范的一部分。
简单来说, 使用 MutationObserver 能监控页面信息的变化,当页面 body 变化最剧烈的时候,我们拿到的时间数据,就是首屏时间。
首先,在用户进入页面时,我们可以使用 MutationObserver 监控 DOM 元素 (Document Object Model,文档对象模型)。当 DOM 元素发生变化时,程序会标记变化的元素,记录时间点和分数,存储到数组中。数据的格式类似于 [200ms,18.5]。
为了提升计算的效率,我们认为首屏指标采集到某些条件时,首屏渲染已经结束,我们需要考虑首屏采集终止的条件,即计算时间超过 30 秒还没有结束;计算了 4 轮且 1 秒内分数不再变化;计算了 9 次且分数不再变化。
接下来,设定元素权重计算分数。
递归遍历 DOM 元素及其子元素,根据子元素所在层数设定元素权重,比如第一层元素权重是 1,当它被渲染时得 1 分,每增加一层权重增加 0.5,比如第五层元素权重是 3.5,渲染时给出对应分数。
为什么需要权重呢?
因为页面中每个 DOM 元素对于首屏的意义是不同的,越往内层越接近真实的首屏内容,如图片和文字,越往外层越接近 body 等框架层。
最后,根据前面的得分,计算元素的分数变化率,获取变化率最大点对应的分数。然后找到该分数对应的时间,即为首屏时间。
这套打分法的思路,说到底是用 DOM 结构的复杂度变化来近似「内容出现了」这件事。它不完美,但比人肉打点稳定得多。
下面这段是分数部分的核心计算逻辑,做三件事:把 SCRIPT、STYLE、META、HEAD 这类不产生视觉的标签排除掉;用 getBoundingClientRect().top < WH 判断元素是否在首屏可视范围内,超出的直接返回 0 分;每往下一层,权重加 0.5。
function calculateScore(el, tiers, parentScore) {
    let score = 0;
    const tagName = el.tagName;
    if ("SCRIPT" !== tagName && "STYLE" !== tagName && "META" !== tagName && "HEAD" !== tagName) {
      const childrenLen = el.children ? el.children.length : 0;
      if (childrenLen > 0) for (let childs = el.children, len = childrenLen - 1; len >= 0; len--) {
        score += calculateScore(childs[len], tiers + 1, score > 0);
      }
      if (score <= 0 && !parentScore) {
        if (!(el.getBoundingClientRect && el.getBoundingClientRect().top < WH)) return 0;
      }
      score += 1 + .5 * tiers;
    }
    return score;
  }
这里有个细节容易被忽略:parentScore 这个参数是用来做剪枝的。如果父节点已经拿到了分数,子节点即便超出可视区也不再单独判断,避免整棵子树被误判成 0 分。


