
文章首发于: https://feinterview.poetries.top/blog/ai-agent-harness-engineering
某个客服 Agent 每天跑 10 万次对话,一直好好的。某天工程师为了让它知道当前时间,在系统提示词里塞了一行实时注入的时间戳。第二天监控告警,首 token 延迟从 0.5 秒涨到 3-5 秒,月度推理账单差不多翻了一倍。
代码没报错,模型也没换。
这篇是我这段时间的一份系统性整理,按「一个 Agent 从 Demo 走到生产要依次补上哪些东西」排的顺序,每一节都配了能跑的 JavaScript。这个领域的资料大多是 Python 视角的,这里的代码全部是我用 Node 重写过的。
先说这篇最想传达的那个判断:当各家模型能力越来越接近,Agent 的竞争力就从模型本身转移到了模型之外那一层工程实践上。
本文会依次回答这些问题:
- Agent 这个词拆开之后,工程师真正能动的是哪几块?
- 不用任何框架,最少多少行代码能跑起一个 Agent?
- 上下文窗口里到底装了什么,各部分的成本和寿命有什么区别?
- 一行时间戳为什么能让账单翻倍,怎么写才不炸缓存?
- 工具返回的结果,为什么不能当成普通 user 消息塞回去?
- Agent 老是数不清自己干过几次同样的事,怎么办?
- ReAct 循环之外,生产级 Agent 还缺哪三件事?
- 上下文快满了要压缩,压缩会不会把 KV Cache 全打掉?
- 怎么让 Agent 跨会话记住用户,RAG 要做到什么程度?
- Agent 老选错工具,该换个更强的模型还是改工具描述?
- 怎么用数据证明你改的东西真的有效,而不是感觉上有效?
- 什么时候才真的需要上多 Agent?
- 线上出了问题,怎么从轨迹里把它捞回来?
- 新踩到的经验,该进知识库、提示词、代码还是模型参数?
- 选模型时除了准确率,还有哪几个维度会决定成败?
- Agent 读回来的内容也能是攻击面,怎么防?
- 任务要跑几小时、用户随时打断,架构该怎么改?
全文大概两万字,十八个小节,建议按顺序读,后面的每一节都依赖前面建立的概念。赶时间的话可以先看第一节和总结。
# 一、先把 Agent 这个词拆开
「Agent」现在被用得太宽,从一个套了提示词的聊天框,到能自己跑一周的编程系统,都叫 Agent。要讨论工程,得先有个能落到代码上的拆法。
我见过的各种拆法里,这组等式最实用:
Agent = Model + Harness
Harness = 上下文管理 + 工具接口 + 约束 + 验证 + 纠正
Agent ↔ Environment
Harness 直译是「马具」,套在马身上让人能驾驭它。放到这里,指的是 Agent 边界内、模型之外那一层运行与治理代码。
边界要划清楚,不然后面全是糊涂账。工具定义、调用适配器、沙箱的权限与重置机制,属于 Harness;沙箱里那些随行动变化的文件和进程、外部数据库、网页、用户、物理世界,属于 Environment。有一条容易搞混:部署位置不决定归属。哪怕仿真环境和 Agent 跑在同一个 Node 进程里,它依然是 Environment。
五个要素各管一段,我把它们摊平成一张表:
| 要素 | 它在解决什么 | 落到代码里是什么 |
|---|---|---|
| 上下文管理 | 让模型在每个决策点都有足够信息 | 系统提示词、状态栏、历史裁剪、压缩 |
| 工具接口 | 给模型观察和行动的手段 | tool schema、调用适配器、结果序列化 |
| 约束 | 限定它能做什么 | 权限白名单、参数上限、审批开关 |
| 验证 | 判断这一步做得对不对 | 结构化字段校验、测试执行、linter |
| 纠正 | 做错了怎么补救 | 静默重试、回退、熔断、转人工 |
前两项让 Agent「能做事」,后三项让它「不做错事」。
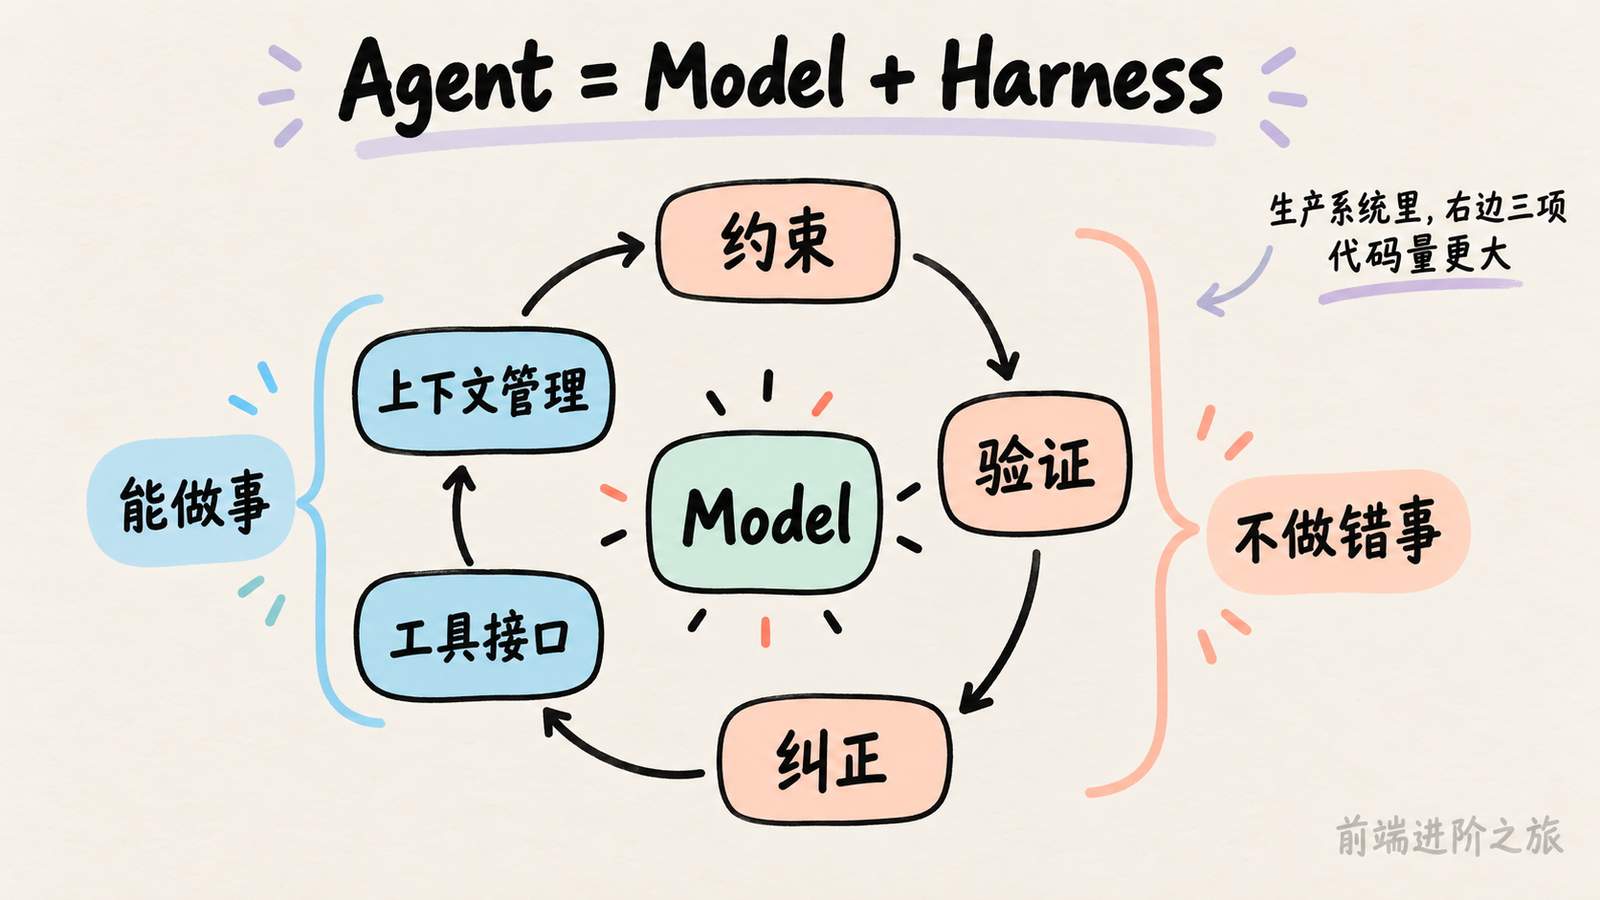
这两类的重要性是不对称的,而且随着产品成熟度在迁移。早期框架基本都在卷前两项,给模型工具、给模型上下文。到了生产阶段,重心全在后三项。Claude Code 这类成熟产品的 Harness 里,绝大部分代码是约束、验证和纠正,工具本身反而只占一小部分。
有个数字很能说明问题。LangChain 在 Terminal Bench 2.0 上把自己的 Coding Agent 从 52.8% 提到 66.5%,排名从 30 名开外冲进前 5,改的不是模型,是 harness:让 Agent 自动检查执行结果、检测是否陷在重复循环里、调整思考策略。
# 从提示工程到 Graph 工程,工程师的手能伸多远
把视角拉远一点,这几年 AI 应用工程有一条很清晰的扩张弧线:
- 提示工程,优化喂给模型的那段自然语言
- 上下文工程,系统性管理模型能看到的所有信息,包括系统指令、工具定义、历史、外部知识
- Harness 工程,进一步管「Agent 怎么组织模型运行、怎么跟环境交互」
- Loop 工程,从单次运行扩展到跨轮次的持续运转,谁来发现下一件该做的事、何时才算真正完成
- Graph 工程,2026 年开始被提起的说法,把 Agent 循环、确定性程序和人工审批组织成显式的执行图,节点承担能力,边规定路由,状态沿边传递并在关键边界持久化
这五层不是互相替代,是层层包含的。提示工程是上下文工程的子集,上下文工程是 Harness 工程的子集,一直往外套,单个 Agent 循环最后只是执行图里的一个节点。
我自己的感受是,每往外一层,工程师能影响的部分就多一块,而这块恰恰是模型厂商不会替你做的。这是这篇后面所有章节的立足点。
# 三条容易被跳过的原则
Anthropic 总结过三条,看着朴素,踩过坑之后回头看会觉得每条都在点上。
保持简单。 从最简单的方案开始,只在确实必要时加复杂度。直接调 API 优于套一层框架,清晰的代码优于聪明的抽象。理由很实际,每多一层抽象,以后调试时就多一个盲区。我见过不少团队一上来就上编排框架,结果 Agent 行为不对时,要先花半天搞清楚框架在中间替你改了哪些消息。
保持透明。 明确显示规划步骤、执行日志和决策轨迹。这不只是方便调试,更是让用户建立信任的前提。黑箱里出的错,外部观察者既定位不了也纠正不了。
按 Agent 的视角设计工具接口。 传统 API 是从程序员视角设计的,而 ACI(Agent-Computer Interface)强调的是让模型容易理解和正确使用。这条第十节展开。
先把整体骨架放这儿,后面所有代码都按这个结构组织:
┌──────────────────────── Agent ─────────────────────────┐
│  ┌────────────── Harness ──────────────┐               │
│  │  buildContext  ← 状态 + 轨迹 + 压缩  │               │
│  │        ↓                             │   观察        │
│  │     Model(推理 / 选工具)            │ ←──────────┐  │
│  │        ↓                             │            │  │
│  │  constrain → 权限与参数校验           │            │  │
│  │        ↓                             │   行动      │  │
│  │  工具接口 ─────────────────────────────────────────┼──┼→ Environment
│  │        ↓                             │            │  │
│  │  verify  → 看结构化字段,不看自由文本  │            │  │
│  │        ↓ 失败                         │            │  │
│  │  correct → 静默重试 / 回退 / 熔断     │ ───────────┘  │
│  └──────────────────────────────────────┘               │
└─────────────────────────────────────────────────────────┘
# 二、不用框架,最少多少行能跑起一个 Agent
概念讲完,先把东西跑起来。后面十几节都是在这个骨架上往里补,所以这一节的代码值得你真的敲一遍。
需要的只有 Node 18+ 和一个兼容 OpenAI 协议的 API Key。不装任何依赖,fetch 是内置的。
Step 1:建目录、配环境变量。
mkdir mini-agent && cd mini-agent && npm init -y && npm pkg set type=module
export LLM_BASE_URL="https://api.deepseek.com/v1"
export LLM_API_KEY="sk-..."
export LLM_MODEL="deepseek-chat"
Step 2:定义一个工具和它的 schema。描述里直接把触发时机和边界写清楚,这是第十节要展开的东西,先按对的写:
// tools.js
export const TOOL_SCHEMAS = [
  {
    type: 'function',
    function: {
      name: 'read_order',
      description: [
        '按订单号查询订单状态与金额。当用户提到具体订单号时使用。',
        '边界:只查单个订单,不支持按时间范围或用户 ID 批量查询。'
      ].join('\n'),
      parameters: {
        type: 'object',
        properties: { orderId: { type: 'string', description: '订单号,例如 A-1024' } },
        required: ['orderId']
      }
    }
  }
]

const ORDERS = { 'A-1024': { status: 'delivered', amount: 800 } }

export const REGISTRY = {
  async read_order({ orderId }) {
    const found = ORDERS[orderId]
    // 查不到就明说,别返回 null 让模型自己猜它是「没有」还是「出错了」
    return found ? { ok: true, orderId, ...found } : { ok: false, error: `订单 ${orderId} 不存在` }
  }
}
Step 3:把循环拼起来。这一版还没有约束和验证,第七节补:


