精简测试输出,减少编程代理上下文浪费
文章指出,通过测试的日志可能淹没失败堆栈,输出截断还可能丢失关键诊断信息。内容围绕九个测试输出选项展开,旨在减少代理读取的无关日志及后续上下文负担。
AI 深度解读
AI 编程助手跑完测试,真正需要的可能只有一段失败堆栈,读到的却是几百条通过记录、进度提示和调试日志。原文的核心建议很直接:先减少测试命令的输出,再考虑压缩上下文。
作者整理了 JavaScript、Python、Go 等测试工具的安静模式,并把「修复时尽早停下」和「交付前完整验证」分开。对经常让 Agent 改代码、跑测试的开发者,这是一组容易落地的调整。但它能省多少,原文没有实测数据,需要在自己的项目里量。
测试通过的消息,为什么也会影响修复
测试报告通常面向盯着终端的人:进度告诉你程序没卡住,通过列表方便确认覆盖范围。Agent 接收到的是命令输出,这些辅助信息也会占据上下文。
原文引用 Claude Code 的行为说明:失败命令的内联输出大约限制在 10,000 个字符,超过后会保留头尾摘录,且不提供剩余内容的文件路径。测试失败通常返回非零退出码,恰好可能触发这种处理。如果关键错误在中间,Agent 就可能缺少定位依据。
这应当作为原文描述的 Claude Code 行为理解,不能直接推广到所有工具和版本。
另一个成本来自后续请求。原文称 Claude Code 会随请求发送完整对话,因此已经进入对话的通过记录,也可能持续占据上下文,直到清空或压缩。减少无用输出,同时是在减少当前阅读负担和后续携带的信息。
作者没有给出统一的节省比例,而是建议先按非交互方式运行,合并标准错误与标准输出,再计数:
npx vitest run 2>&1 | wc -c
npx vitest run --reporter=minimal 2>&1 | wc -c
这里要看的是 2>&1,否则错误输出可能没有被统计进去。wc -c 数的是字节,只有纯 ASCII 输出才能直接对应字符数,也不能把它当作 token 计数器。
测量还应在自己的终端里进行。Vitest 可能自动识别 AI Agent 并切换报告器,在 Agent 会话里测,默认组可能已经被优化过。
安静模式要保留失败证据,不能只追求输出少
前端项目最值得先检查 Vitest 和 Jest。
Vitest 4.1 增加了面向 AI 使用场景的报告器,当前名称是 minimal,agent 是别名。--reporter=minimal 只输出失败测试及错误消息,隐藏通过测试的 console 日志和汇总。没有配置 reporter 且识别到 AI Agent 时,它会自动启用;项目已经配置 reporter,或识别失败时,则需要显式指定。
需要进度反馈,可以考虑 --reporter=dot,每完成一个测试输出一个点,同时保留失败详情与汇总。--silent=passed-only 则只保留失败测试的 console 输出。
Jest 的 --silent 会禁止测试通过 console 打印消息。它还有一个容易被忽略的默认行为:verbose 通常为 false,但只运行一个测试文件时会变成 true。Agent 修复后反复重跑单文件,可能正好撞上逐条报告测试的模式。原文没有继续给出关闭这一行为的命令,不宜把 --silent 理解成能消除所有冗余输出。
其他语言可以按同一原则检查:
- pytest 用
-q降低详细程度,用--tb=short缩短回溯,同时保留文件、行号和失败断言。默认--tb=auto会为首尾条目展示长回溯,--tb=line又可能信息不足。还要检查配置里的-v、-vv和--showlocals,后者可用--no-showlocals覆盖。 go test ./...对通过的包已经比较安静。-v会打印测试过程,连成功测试的Log、Logf内容也会出现。gotestsum 包装go test -json,默认pkgname每包一行,dots每测试一个字符,哪个更少取决于仓库结构。- Cargo 要分别控制构建工具和测试框架:前面的
-q隐藏 Cargo 日志,--后的--quiet传给 libtest,它是--format=terse的别名;默认pretty每个测试一行。 - PHPUnit 的
--no-progress隐藏进度,保留失败和汇总。--testdox会展开测试名称,--no-output则连失败信息一起隐藏。 - RSpec 默认的
--format progress用.、F、*表示通过、失败和待处理。如果.rspec配了--format documentation,每个describe和it的文本都会进入输出。
真正要优化的是无关信息,而不是错误证据。
修复时尽早停止,完成前必须跑完整套测试
原文第九项建议是快速失败:Agent 正在处理一个问题时,后续失败暂时未必能转化成行动,却会继续增加输出。作者给出的修复循环如下:
npx vitest run --reporter=minimal --bail=1
npx jest --silent --bail
pytest -q --tb=short -x
go test -failfast ./...
cargo test -q -- --quiet
vendor/bin/phpunit --no-progress --stop-on-failure
bundle exec rspec --format progress --fail-fast
要特别看 Cargo 那一行:它没有实现与其他命令完全相同的逐测试快速失败。原文说明,Cargo 默认在首个失败的测试可执行文件之后停止,但该可执行文件内部的 libtest 仍会跑完测试;libtest 自己的 --fail-fast 需要 -Z unstable-options。
快速失败也只适合修复过程。完成前应取消提前停止,让完整测试集安静地跑完,并读取所有失败。
为了让 Agent 持续使用这些命令,作者建议写进启动时读取的说明文件。Claude Code 使用 CLAUDE.md,原文也提到 Codex、Gemini CLI、Cursor、Aider 等工具读取的 AGENTS.md。关键是分别写清「修复时运行什么」和「宣布完成前运行什么」。
更重的方案包括用 PreToolUse hook 改写测试命令,或让子 Agent 执行测试,只返回摘要。它们能集中管理输出,但增加了一层处理逻辑,摘要也可能丢失定位信息。
我的判断
这组建议最有价值的地方,是把上下文优化落到了每天都会执行的测试命令上。相比频繁提醒 Agent「回答简短一点」,控制工具输出更直接,因为大量噪声来自命令本身。
但原文没有提供优化前后的输出量、token 消耗、修复成功率或耗时对照。因此,「能减少部分输出」有明确机制支持,「能省多少钱、提升多少成功率」仍需项目实测,不能替作者补结论。
不同参数也有不同代价。Jest 的 --silent 会同时关闭失败测试的 console 消息;缩短回溯可能隐藏需要继续追踪的调用链;快速失败会延后其他问题的暴露。合理做法是默认简洁,证据不足时扩大输出。
作者还推广了自己开发的 Hermes IDE,利益关系已明确披露。Hermes 2.3.4 增加上下文仪表,可以查看会话占用、token 总量和估算成本,下图展示了相关界面。
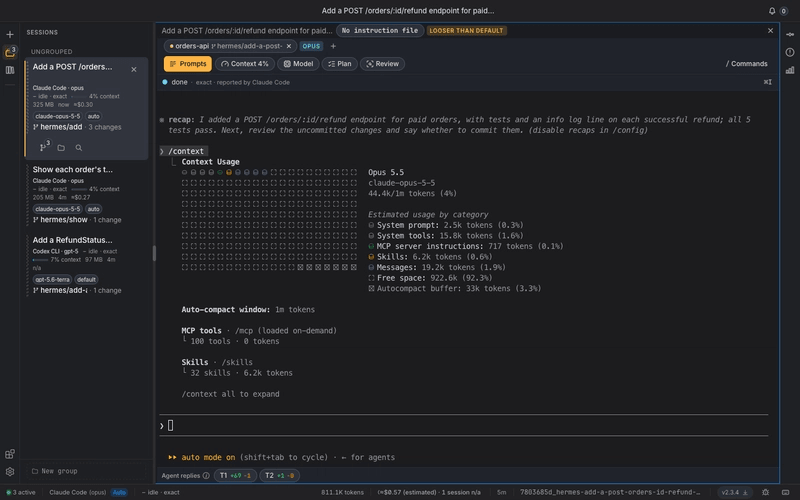
这些展示有助于观察变化,但不构成性能对照实验。原文称 Hermes 免费、采用 BSL 1.1 源码可用许可,支持 macOS、Windows、Linux;不能把「源码可用」直接等同于开源。
作者提到的 /compact 也有成本,因为它需要读取待总结的对话。我的取舍是先从源头减少噪声,再用压缩处理累积上下文。至于末尾推广的 LLM Observability Pocket Guide,原文没有展开工具比较,无法据此评价其效果。
能拿来做什么
- 在前端或 Node 项目里,先对比默认测试命令与安静模式的输出字节数,同时确认失败断言、文件位置和必要日志仍然可见。
- 检查
package.json、测试配置和已有脚本,找出详细报告、通过测试日志等输出来源,再决定哪些参数适合长期保留。 - 在
CLAUDE.md或AGENTS.md中明确两组命令:修复阶段使用局部测试和快速失败,交付阶段运行完整测试集。 - 当 Agent 无法定位失败时,恢复相关测试的日志或完整回溯,补齐证据后继续修复,不要把最短输出当成固定目标。