把需求和决策写进仓库,延续Agent上下文
Agent Runway将规格、架构决策、检查点和运行日志与代码共同保存,缓解编程Agent跨会话丢失上下文的问题。项目采用MIT许可证,重点解决重复说明、需求偏移和执行难追溯。
AI 深度解读
AI 编程助手能接着写代码,却未必记得上次为什么这样设计。Agent Runway 的作者在使用 Cursor 和 Claude Code 数月后发现,反复解释架构、纠正同类错误、从 diff 里还原决策,才是持续开发中的主要消耗。他给出的方案,是把仓库变成跨会话的记忆载体。
这个 MIT 许可的开源工具,把规格、规则、决策和交接记录放在代码旁边。值得借鉴的是它如何组织上下文;需要打问号的是,文件写进仓库之后,Agent 是否真的能持续读对、用对。
为什么有了 CLAUDE.md,还是会反复解释需求
作者列出的痛点都发生在长期维护中:会话之间丢失上下文,架构决策做完就忘,同类错误在不同功能里重现,自动执行缺少记录,实现逐渐偏离需求。
这些问题不能全靠一份规则文件解决。
CLAUDE.md、.cursor/rules、.github/copilot-instructions.md 适合说明编码规范,但一个项目还需要回答:要做什么,怎样算完成,任务按什么顺序推进,上次为什么这样选,以及当前停在哪里。
规范告诉 Agent 怎么做事,项目记忆还要告诉它为什么做、做到哪里。
Agent Runway 将这些信息拆成四层:Spec 定义意图与行为,Workflow 编排执行和质量关卡,Rules 约束各个步骤,Memory 保存决策与经验。生成的 AGENTS.md、CLAUDE.md 和 Copilot instructions 只承担轻量入口的职责,长期知识集中放在 .agent-runway/。
作者展示了 Lite 初始化后的实际目录,使用的查看命令是 tree -a -L 2 .agent-runway。里面除了 specs、workflows、rules、logs,还有按架构、业务、契约、测试等分类的 docs,以及专门的 memory。
记忆也进一步拆分:project-decisions.md 保存项目决策,common-failures.md 记录常见失败,另有执行、推理、重复模式、审查发现、测试和工单质量记录。目的不是堆文档,而是让后续会话更容易找到对应信息。
文件跟着仓库走,可以提交、共享,也便于在 Cursor、Claude Code 和 VS Code Copilot 之间迁移。不过,原文没有详细解释这些客户端如何检索和筛选记忆,不能把「文件可迁移」直接理解成「使用效果完全一致」。
从 Lite 开始,先把暂停和纠错留下来
Agent Runway 提供 Vibe/Lite 预设,面向原型、个人开发和流程较轻的任务,要求 Node.js 22 或更新版本。
下面这条命令用于初始化 Lite,并通过 --target all 生成面向各支持工具的配置:
npx @adonai-labs/agent-runway init --preset vibe-lite --target all
重点看 --preset vibe-lite:它安装少量技能,以及工程原则、安全和测试规则,不包含斜杠命令、agents 或重型工作流。
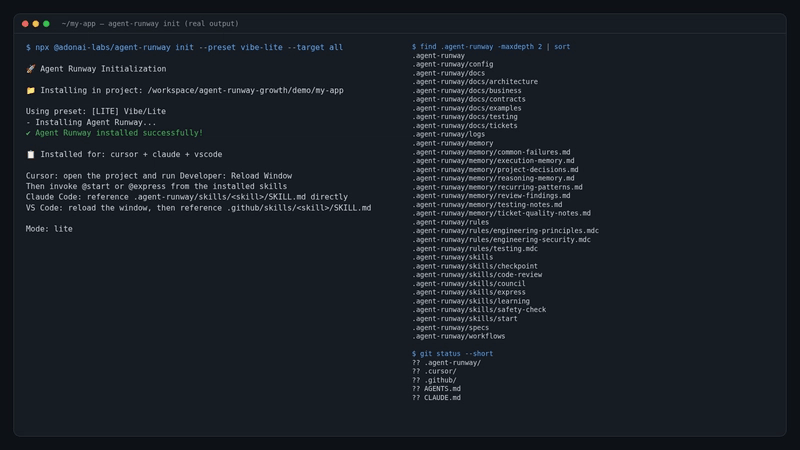
作者给出的使用习惯很直接:通过 @express 完成小范围修改;当天结束或交接时运行 @checkpoint,把当前状态写入日志;发现值得保留的错误、决策或约定时,用 @learning 写入 .agent-runway/memory/。
三者没有强制顺序。作者最推荐的是 @learning,因为修好当前错误只解决一次问题,留下可复用的经验,才可能减少后续重复纠错。
这套做法对日常 AI 编程的价值,在于把「聊天里说过」变成「仓库里找得到」。例如一个跨会话任务,下次接手时需要知道剩余工作和未解决问题,而不只是看到一份改动中的代码。
但「下一次不再犯」仍是目标。原文没有给出重复错误率、恢复任务耗时或上下文消耗的前后对照。
任务变复杂后,怎样把需求和审查接起来
Lite 不够用时,可以运行 npx agent-runway upgrade --to structured 原地升级,保留记忆、日志、检查点和文档。也可以用 npx @adonai-labs/agent-runway init --preset node-typescript --target all 直接开始。
Structured 的主路径是 /spec-creator 定义意图与行为,/ticket-creator 拆成可开发工单,/lead 推进带质量关卡的实现,最后由 /review 做工程、安全和性能审查。
其他入口按需使用:/architect 处理设计取舍与架构决策记录(ADR),/contrarian 挑战选定方案,/validate 和 /po-eval 检查工单及产品准备情况,/refactor 处理保持行为的重构,/iac 处理基础设施即代码。
支撑这些流程的有两个原则。
Test-Driven Delivery 要求先理解问题、定义预期行为、选择验证证据,再实现。如果严格测试先行不实际,就记录原因,并采用最小可信替代方案。它比「每次都必须先写测试」更强调证据是否足以支持这次改动。
Narrative Delivery 要求工单、提交、PR、检查点和记忆串起简短的技术说明:为什么改、改了什么、凭什么认为安全、还有什么没解决。这样接手的人不必只靠 diff 猜意图。
技术栈通过 agent-runway add <stack> 单独添加,支持 .NET、TypeScript、Node.js、React、Python、Go、Rust,安装规则、审查集成和栈技能,不额外提供斜杠命令。
审查则有两档。默认的 compact 对 diff 审查一次,将发现标为 CR、SEC、SNR,分别对应常规审查、安全、资深架构及运行层面的视角。高风险修改可以显式选择隔离审查:
/review
Files changed: [list of files]
Lens: all
Mode: isolated
关键是 Mode: isolated:它针对同一份 diff 分别执行 CR、SEC、SNR 审查,再汇总去重,适用于认证、个人身份信息(PII)、公共契约、数据迁移、并发及大型跨层改动等场景。可选的反方视角 CTR 不属于默认关卡。@code-review 和 /review 都会输出合并式 PR 报告,两种模式都将既有技术债与本次引入的问题分开。
无人值守入口 /autonomous-lead 沿用 /lead 的质量要求,并明确要求破坏性操作前获得人工批准。原文说额外增加「三件事」,实际只列出了这一项,另外两项没有交代,不能自行补齐。
我的判断
我认同它对问题的定位:长期 AI 编程的成本,不只来自代码质量,也来自意图和决策不断流失。把这些信息纳入版本管理,能让它们进入团队已有的审查与协作流程。
但「仓库就是记忆」有前提。记录需要准确、及时,还得让 Agent 在合适的时候读到。过期决策、重复条目和相互冲突的规则,也可能让文件越积越多、判断越来越乱。原文没有提供充分细节来证明这些问题已经解决。
作者提供了实际目录和个人使用经验,没有提供足以证明效率提升的对照数据。
与现有的规则文件、ADR、issue 和 PR 模板相比,Agent Runway 的吸引力是把入口和流程组织好了。已有成熟约定的团队,是否值得迁移,要看它能否减少维护负担;个人项目则更适合先验证 Lite 是否有用。
agent-runway metrics 能根据关卡结论和运行日志生成交付评分卡,但这些指标不能直接证明软件质量更高。agent-runway ci-check 仍是预览功能,需要主动启用,默认提供建议,也可通过 --profile strict 收紧检查;@council 同样处于预览阶段,行为及 ci-check 的 JSON 输出可能变化。
原文将 v1.7 列为下一步,计划拆分 CLI、增加产物与安装更新回归测试、改善本地测试和发布文档,并用真实案例稳定 @council。Shared Workspace 仍是后续实验设想,不能当成已有能力。
能拿来做什么
- 如果你经常用 Cursor 或 Claude Code 跨天修改同一个项目,可以先试 Lite,重点验证
@checkpoint留下的信息是否足以让下一次会话继续推进。 - 对 React、TypeScript 或 Node.js 项目中反复出现的错误,可以通过
@learning保存具体原因和约定,并人工检查记录是否准确、是否已经过期。 - 对验收条件容易含糊的任务,可以借用 Spec 到工单再到实现的顺序,先写清预期行为和验证证据,再决定是否采用完整 Structured 流程。
- 对认证、公共接口、数据迁移等高风险修改,可以尝试
isolated审查,同时保留人工判断;普通 PR 则先从compact开始,避免让流程成本超过改动收益。