从破坏性变更清单评估推理引擎升级风险
文章统计 vLLM 近一年发布节奏,并将五个版本的30项破坏性变更转化为升级风险数据,其中8项可能在启动和健康检查正常时改变行为。建议通过自动提取变更、对比生效配置和回放基准请求设置升级门禁,但未实际运行推理引擎验证。
AI 深度解读
vLLM 的升级风险,不能只看版本号,也不能靠进程启动成功来判断。作者统计了截至 2026-10-31 的一年发布记录:vLLM 新次版本的发布间隔中位数只有 13.5 天,而部分破坏性变更会让同一条启动命令继续运行,却悄悄改变服务行为。
这份分析值得读,在于它把升级讨论落到了可检查的东西上:发布说明、实际生效的配置、请求回放和回滚条件。不过,作者没有运行推理引擎,文中的统计与测试建议要分开看。
每隔两周发版,版本号还能代表兼容性吗
作者从 PyPI JSON API 获取版本记录,以每个版本最早上传文件的时间为准,剔除候选版、开发版和 post releases。统计窗口是 2025-10-31 至 2026-10-31,共 365 天。
结果是:
- vLLM 发布 33 个稳定版本,其中 12 个补丁版本,覆盖 0.12 至 0.32 共 21 个次版本系列。
- SGLang 发布 19 个版本,全部位于 0.5.x,发布间隔中位数为 14.6 天。
- LMDeploy 发布 12 个版本,发布间隔中位数为 26.5 天。
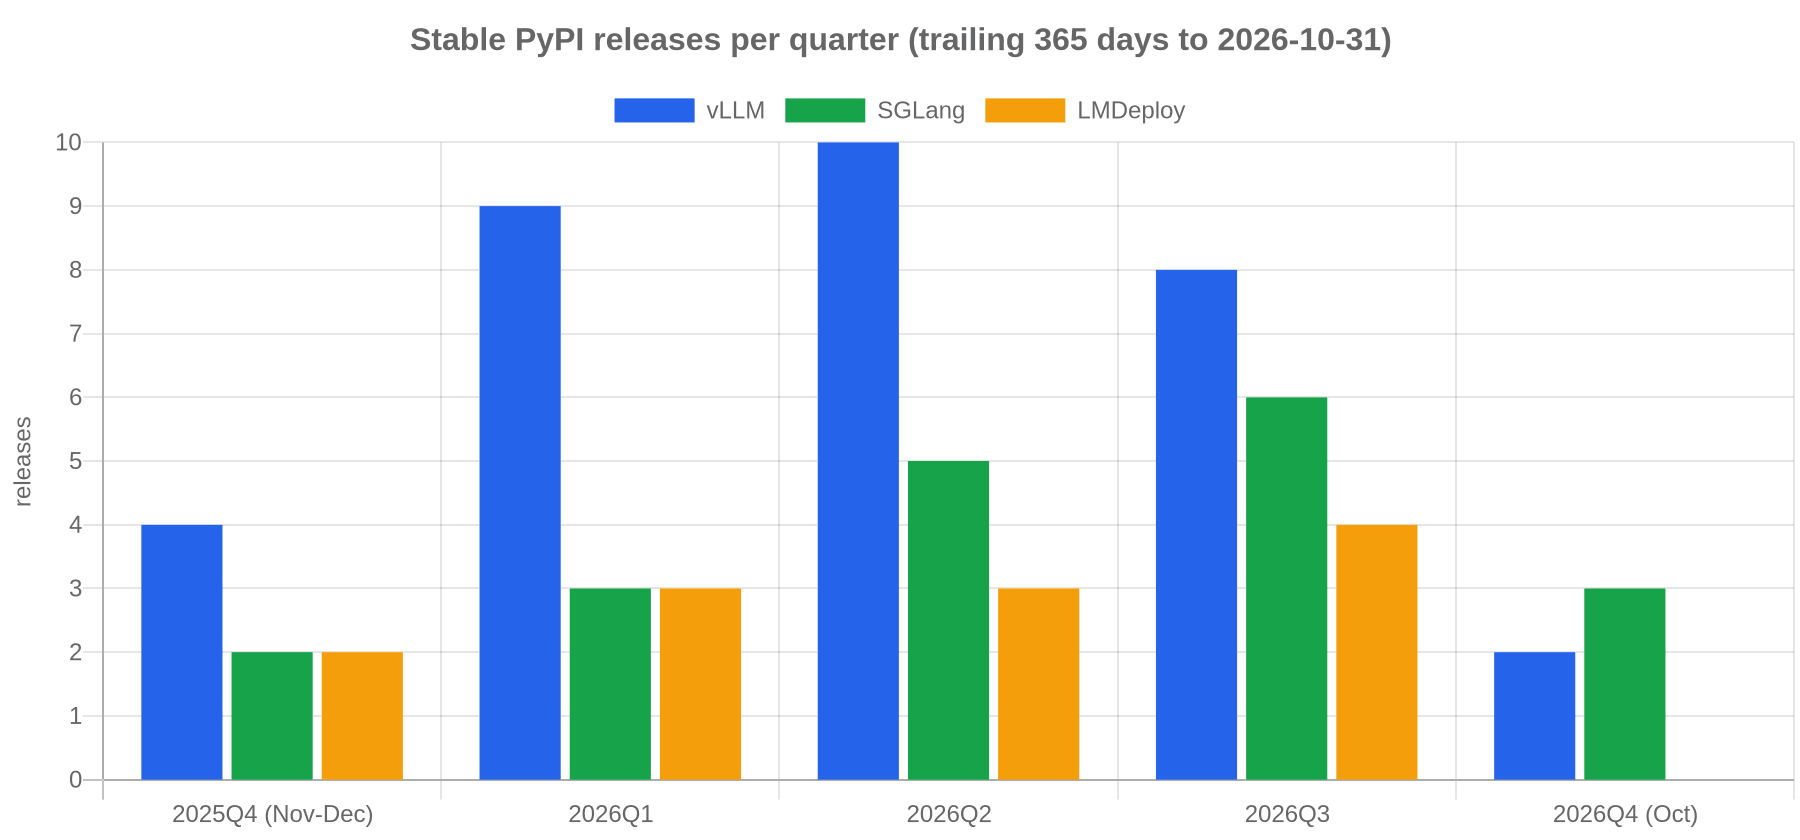
vLLM 的 13.5 天指相邻次版本系列首次发布的间隔中位数,最短 9 天,最长 32 天。最近四次间隔分别为 13、12、13、13 天,从 0.28 到 0.32 只过了 52 天。
作者没有把 TensorRT-LLM 放进比较表。虽然它的 PyPI 页面显示 24 个版本,最后上传的是 2026-04-20 的 1.2.1,但作者无法确认 PyPI 是否为其主要发布渠道。这种排除是合理的:渠道覆盖不完整,数字就可能失去可比性。
更影响升级判断的是两个项目的编号习惯。vLLM 每次常规发布都会推进中间一位,SGLang 的 19 次发布却全部留在 0.5.x。一个项目的补丁升级,可能对应另一个项目的次版本升级。
版本号能告诉你发布顺序,却不足以证明这次升级兼容。
最难发现的变化,是健康检查仍然返回 200
作者只统计 vLLM 0.28 至 0.32 发布说明中专门列出的「Breaking changes」,按分号拆分条目,得到每版 4、5、6、7、8 条,共 30 条。
这个口径有边界。0.27.0 曾把 PyTorch 升级写在亮点中的「breaking environment change」,没有独立栏目,因此不在统计内;一条记录也可能包含删除两个环境变量之类的多个变化。条目数量只是维护者如何记录变更的信号,不是风险分数。
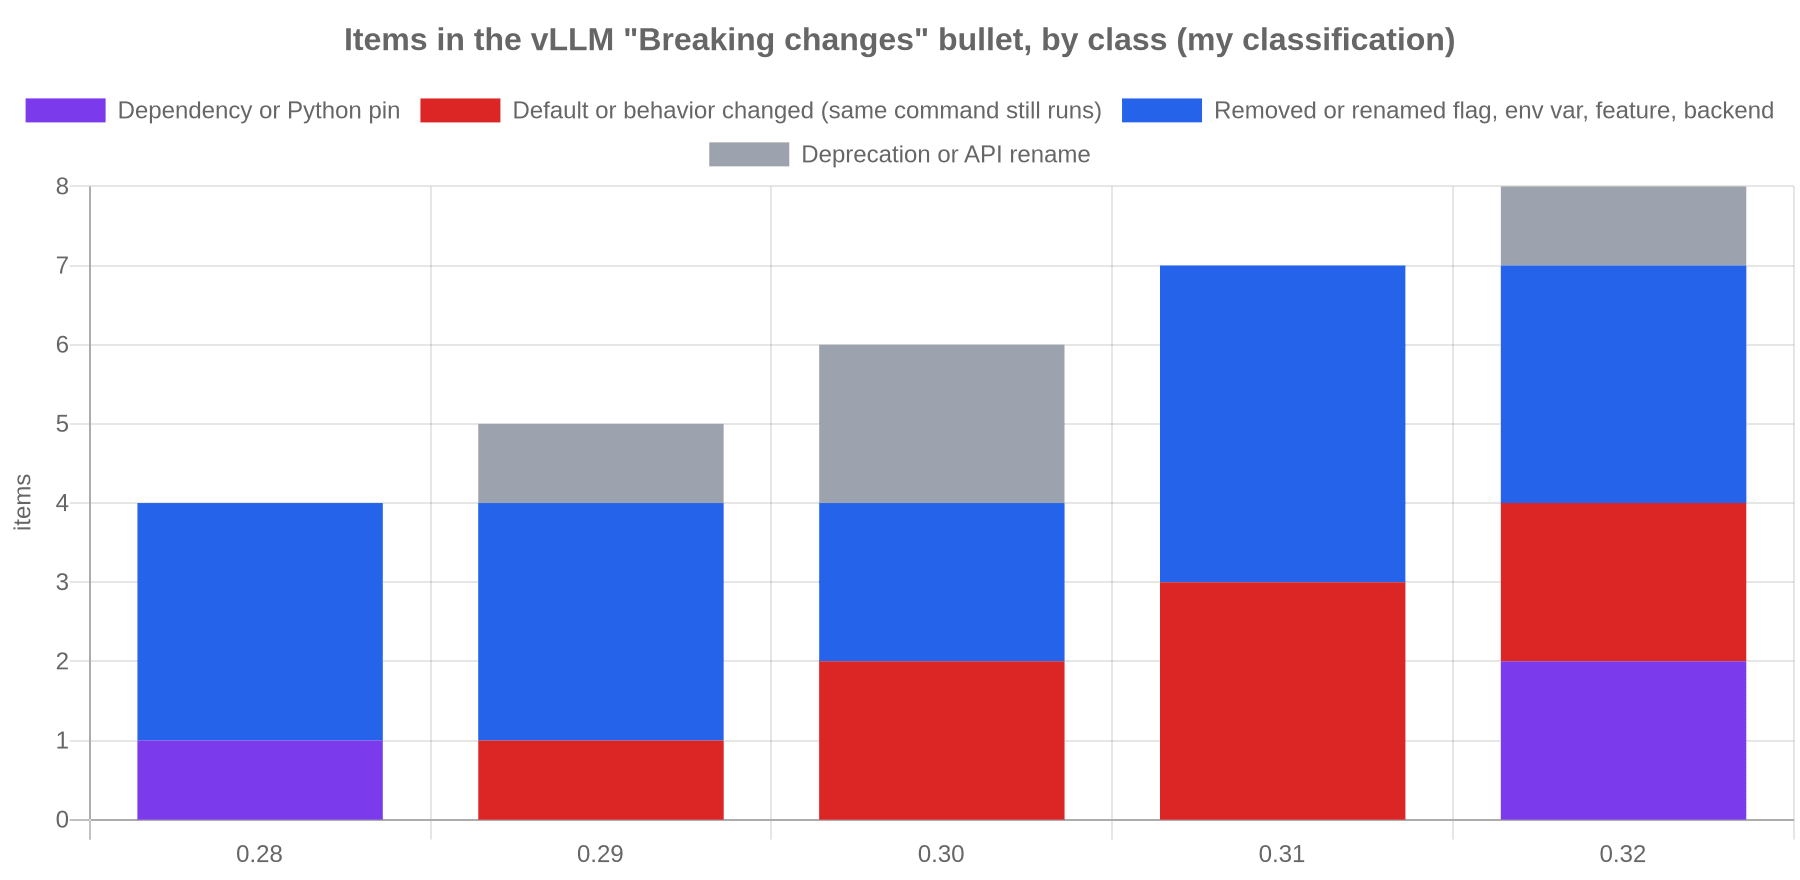
作者自行分为四类,数量为 3、8、15、4。其中 8 条,占约 27%,属于默认值或行为变化:命令不变,服务启动,健康检查通过,但请求处理方式发生变化。
原文给了四个具体例子:
- **0.32 改变
max_tokens的处理方式。**它不再从上下文窗口中预留。旧容量规划若依赖这种预留方式,就需要重测;原文没有证明并发承载能力会升还是降。 - 0.31 中,
--enforce-eager还会禁用 JIT kernel warmup。作者预期首个请求的表现可能变化,但没有测量,建议比较冷启动 p99。 - 0.30 将 YaRN 行为与 Transformers 对齐。依赖 YaRN 扩展长上下文的模型,实际
max_model_len可能不同,应比较新旧版本启动时报告的上下文长度。 - 0.32 收紧默认 CORS origins。这有安全价值,但浏览器直接连接推理服务的应用可能因此无法访问。
删除参数通常更容易暴露问题;删除环境变量则未必,因为程序可能忽略不认识的变量。这里也不能凭经验断言,必须检查具体版本。
对前端团队来说,CORS 最直观:服务健康不代表浏览器能调用。对负责部署的全栈团队来说,上下文长度和预热行为同样说明,启动命令只是输入,真正需要核对的是服务最终采用的配置。
升级门禁该检查什么
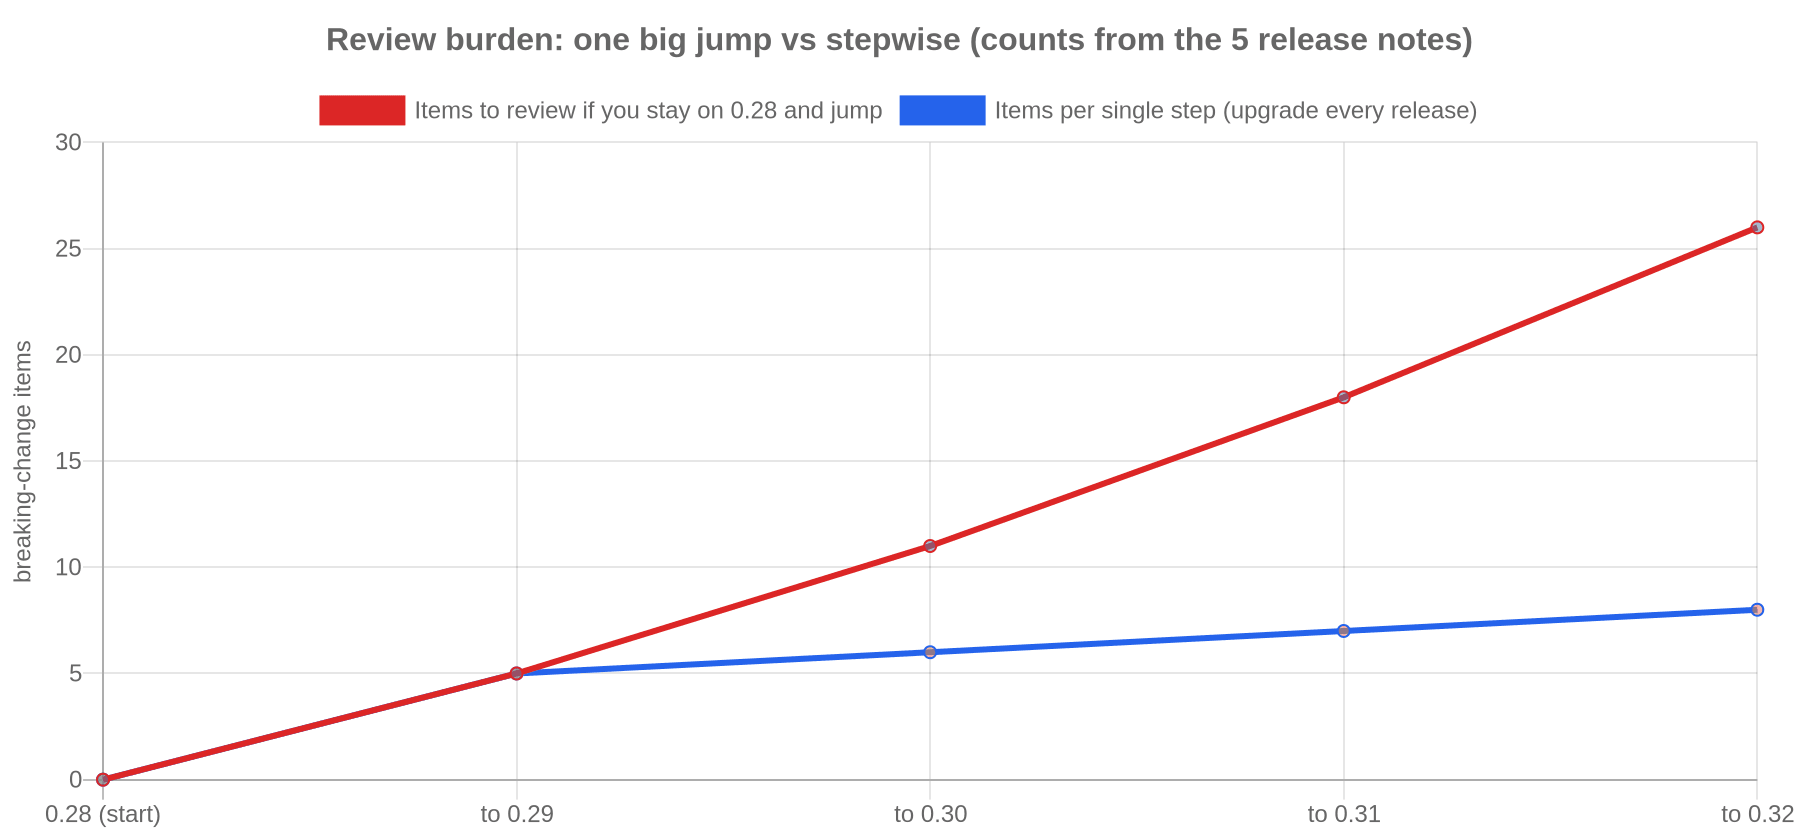
一直固定旧版,也会累积工作量。从 0.28 逐步升到 0.32,每次分别审查 5、6、7、8 条;直接跨过去,则要在一个变更窗口审查 26 条。故障定位也更难,通常需要再切换中间版本来缩小范围。
安全修复也是考虑因素。0.32.0 的说明列出三个已修复公告:GHSA-4hhp-h66f-j5j7 涉及 chat template 资源耗尽,GHSA-q97c-p368-75c4 涉及 tokenizer max_token_id,GHSA-frvg-qw88-hww9 涉及 P2P ZMQ socket 耗尽。
0.28 至 0.31 的说明中搜不到「GHSA」,但不能据此认定它们没有安全修复,也不能证明所有旧版都受影响;原文没有说明修复是否回移。
作者建议建立四层门禁。
第一层是自动提取破坏性变更。下面是原文脚本,用来把指定版本的条目汇总出来:
import json, re, sys, urllib.request

def breaking_items(tag, repo="vllm-project/vllm"):
    url = f"https://api.github.com/repos/{repo}/releases/tags/{tag}"
    body = json.load(urllib.request.urlopen(url, timeout=30))["body"] or ""
    m = re.search(r"\* \*\*Breaking changes?\*\*:(.*?)\n", body)
    return [s.strip() for s in m.group(1).split(";")] if m else []

if __name__ == "__main__":
    total = 0
    for tag in sys.argv[1:]:
        items = breaking_items(tag)
        total += len(items)
        print(f"## {tag}: {len(items)} items")
        for it in items:
            print("  -", it)
    print("total:", total)
要盯住的是 re.search 那一行:它依赖固定栏目格式。作者对 v0.29.0 至 v0.32.0 运行过,得到 5、6、7、8 条,共 26 条;返回空列表时,应人工读说明,不能判为没有破坏性变更。运行方式是 python breaking.py v0.30.0 v0.31.0 v0.32.0。
第二层是在预发布环境使用生产参数启动候选版本,保存新旧启动日志和模型列表响应,比较上下文长度、默认 dtype、端点与预热行为。日志未必暴露全部内部状态,但比只比较命令更有用。
第三层是回放固定请求集。原文示意代码调用 /v1/chat/completions,设置 temperature: 0、默认 max_tokens=256,比较文本、finish_reason、completion_tokens 和延迟,汇总文本一致率、结束原因变化率及新旧 p50。作者没有运行这段回放,它需要两个在线端点。
temperature 0 也不保证跨版本逐字一致,内核、调度和浮点归约顺序都可能影响结果。文本一致率适合观察趋势,验收还应看任务正确率或通过率。
第四层是灰度。先写明错误率、p99 延迟和一个质量指标的回滚阈值,再导入少量真实流量。
我的判断
这篇最有价值的判断,是把「能启动」和「业务行为正常」拆开了。尤其是默认配置变化,常规健康检查确实覆盖不到,配置对比加请求回放比单纯查看部署状态更有针对性。
但它没有证明频繁升级一定成本更低。30 条变更、8 条行为变化来自发布说明和作者分类,没有性能、准确率或故障率对照。每季度升级按 13.5 天间隔估算会跨过约 6 至 7 个次版本系列;小步升级更易定位问题,是有依据的工程建议,仍不是实测收益。
频繁升级还依赖预发布资源、代表性请求集和可靠回滚。团队若缺少这些条件,先补门禁,比照搬两周一升级更现实。SGLang 与 LMDeploy 在文中也只比较了发布频率,不能据此判断谁更稳定。
能拿来做什么
- 如果团队自建 vLLM,在升级单里记录当前版本、目标版本和跨过的全部发布说明,自动提取条目后再人工确认格式与遗漏。
- 给预发布部署保存启动日志和模型列表响应,重点核对
max_model_len、dtype 与显式参数之外的默认值变化。 - 浏览器直连服务的前端应用,应把真实来源下的 CORS 请求加入验收;调用
/v1/chat/completions的 Node 服务,应回放包含不同max_tokens和上下文长度的代表性请求。 - 灰度前写好错误率、p99 和任务质量的回滚阈值,保留旧版本及其配置;不要把逐字一致当成唯一通过条件。