用非交互配置和钩子阻断编程代理死循环
文章将代理重复执行命令的常见原因归为等待输入、输出不可见及缺少停止规则,并提供命令实验。方案结合非交互环境配置、AGENTS.md规则和重复结果检测钩子,第三次警告、第四次阻断。
AI 深度解读
AI 编程助手反复执行同一条命令,未必是模型能力不够。命令在等输入、关键报错被截断、没有明确的停止条件,都可能把一次普通失败变成循环。作者给出的处理顺序是:先检查运行环境,再补停止规则,最后用 hook 拦住重复调用。
这篇值得读的地方,是把「模型卡住了」拆成了能检查的工程问题。不过,命令实验和 hook 测试的覆盖范围不同,不能把「脚本测试通过」直接当成「三个产品里都验证过」。
先看命令在等什么,再考虑换模型
原文提到,一名 OpenCode 用户在三个供应商的三个模型上遇到相同问题,而且大多发生在新会话里。这支持优先排查共同的执行环境,但还不足以证明模型完全没有责任。
作者把问题分成三类。
第一类是命令等待交互。git log 可能打开分页器,git commit 不带 -m 会启动编辑器,npm init 会提问。开发服务器和 watcher 则按设计持续运行,把它们当前台任务等待,当然等不到结束。
第二类是模型没看全结果。按原文引用的实现,Codex 单次调用默认输出预算为 10,000 tokens,截断时显示 Warning: truncated output;Claude Code 会把长输出保存到文件,只展示预览。真正的错误如果不在已读部分里,后续修改就可能一直偏离问题。
超时提示也可能误导。OpenCode 会建议预期耗时较长的命令增加 timeout,但编辑器等待输入时,加长 timeout 只是多等一会儿。
第三类是没有退出规则。任务要求「完成实现」,却没规定相同失败出现几次就该停,助手便可能继续尝试。
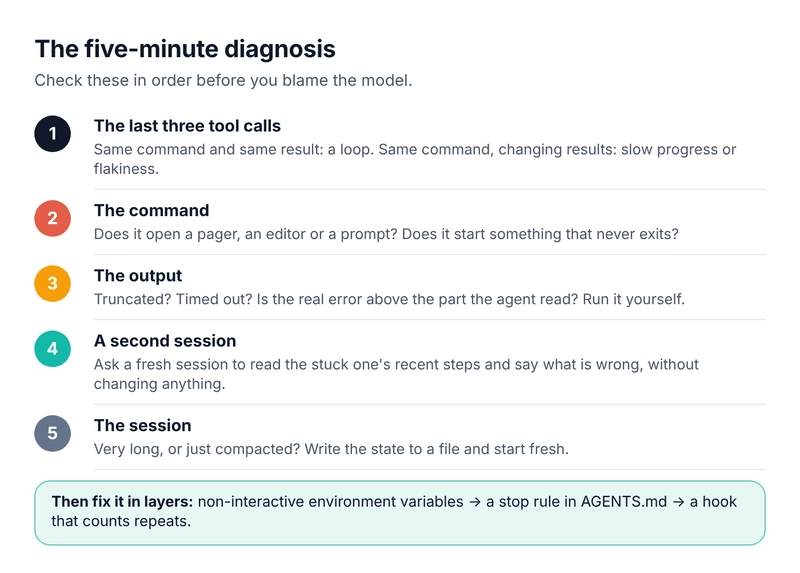
作者在 Debian 13、git 2.47、npm 11 上,用干净环境测试了 10 条日常命令,再加修复变体,每种模式各运行 17 次,单次限制 8 秒。两种模式分别是普通管道,以及伪终端(PTY)。
结果很有解释力:有终端但没人输入时,10 条命令里有 9 条会一直等到被终止;没有终端时,多数交互命令迅速失败,却留下 EOFError、could not read Username 等错误。前者容易诱发延长等待,后者容易诱发重复执行。
快速失败也可能形成循环,关键看助手是否理解失败原因。
循环还会放大会话成本。原文引用的 Cursor 案例总用量为 450 万 tokens,其中 420 万是缓存读取;那个案例本身并非循环。回复中的估算是,约 80,000 tokens 的上下文乘以约 50 次工具调用,就接近 400 万缓存读取 tokens。它解释了重复调用为什么贵,但不能直接换算成固定账单,原文没有提供计费对照。
先消除交互,再把停止条件写清楚
作者建议用五分钟依次检查:最近三次工具调用、命令是否等待输入或持续运行、输出是否截断或超时、让另一个会话只读诊断、当前会话是否过长或刚压缩过。
判断重复时,要同时看命令和结果。同一命令的错误数量持续减少,可能是在推进;命令和结果都没变化,才更像空转。
环境修复先解决分页器、认证提示和编辑器。下面是原文给出的 Claude Code 配置:
{
  "env": {
    "GIT_PAGER": "cat",
    "PAGER": "cat",
    "GIT_TERMINAL_PROMPT": "0",
    "GIT_EDITOR": "true"
  }
}
重点看 GIT_EDITOR:它不会替你生成提交说明,只让编辑器立即退出。作者实测中,缺少 -m 的提交随后以 Aborting commit due to empty commit message 结束。
GIT_PAGER=cat 和 PAGER=cat 关闭相应分页行为,GIT_TERMINAL_PROMPT=0 禁止 Git 在终端询问认证信息。Git 也有 --no-pager。原文指出,Codex 已为 shell 命令设置分页器相关变量,其他环境仍需检查。
npm 则要区分命令。原文引用文档称,npm exec、npx 在标准输入不是 TTY,或检测到 CI 环境时,会假定 --yes;npm init 应使用自己的 -y。不要把一个命令的默认行为推广到所有 npm 操作。
接着,把重复失败的处理方式写进 AGENTS.md。这段规则规定何时停下来,以及哪些命令不该直接运行:
## When something fails
- If a command fails the same way twice, stop and say why before trying anything else.
- Never retry the same command a third time without changing something (the command, the code, or the environment).
- Never run pagers, editors or prompts (less, vi, git commit without -m, npm init without -y). Never run servers or watchers in the foreground.
重点看第二条:第三次尝试之前,必须改变命令、代码或环境。第一条要求相同失败两次后先解释,二者并不冲突。
原文称 Codex、Cursor、OpenCode 会读取 AGENTS.md;Claude Code 在没有 CLAUDE.md 时也会读取,已有后者则在顶部加入 @AGENTS.md。这类加载行为需要结合实际工具版本核对,规则被保存不等于它一定进入了当前上下文。
hook 拦的是「同命令、同结果」
文字规则仍可能被忽略,因此作者提供了一个 142 行、无第三方依赖的 Python 脚本 loop-guard.py。
它在命令结束后,对命令与结果做比较,并去掉颜色码、时间戳、耗时、内存地址等变化噪声。相同命令产生相同结果才累计;任一发生变化,就重置计数。
默认行为是第三次相同结果出现后提醒,第四次之后阻止下一次执行,也就是第五次尝试被拦截。两个参数分别为 LOOP_GUARD_WARN=3、LOOP_GUARD_BLOCK=4。
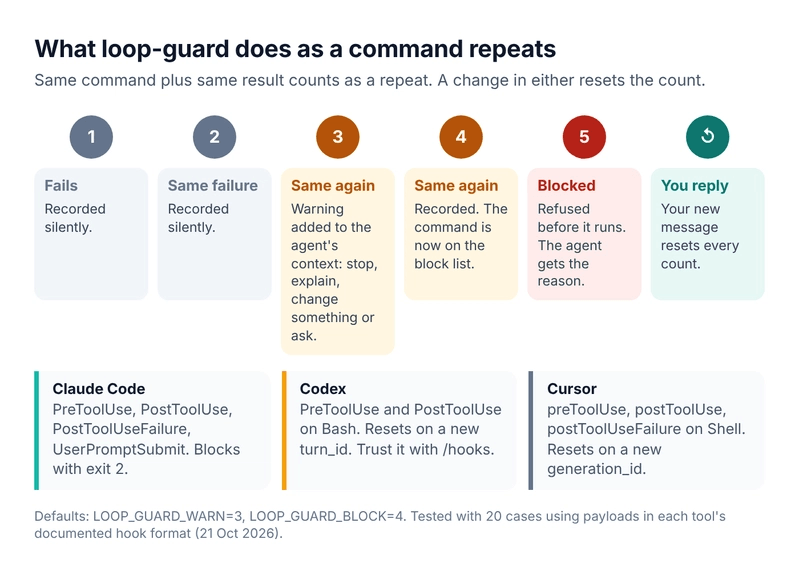
脚本放在 .agents/hooks/loop-guard.py,再分别配置 .claude/settings.json、.codex/hooks.json 或 .cursor/hooks.json;Codex 还需通过 /hooks 审阅并信任配置。提供的原文没有附脚本正文,仅复制配置无法完成安装。
适配也不只是换一个事件名。Claude Code 使用 PreToolUse、PostToolUse、PostToolUseFailure 和 UserPromptSubmit;Codex 的 PostToolUse 也接收非零退出结果,通过新 turn_id 重置;Cursor 使用 preToolUse、postToolUse、postToolUseFailure,通过新 generation_id 重置。脚本借助 cursor_version、turn_id 等字段辨别来源。
Cursor 权限 hook 的无效输出可能导致阻止,所以前置事件必须返回有效 JSON。脚本自身异常则放行调用,避免防护程序故障挡住全部工作。这个取舍也表示:它不是失效时仍保证拦截的硬边界。
OpenCode 没有被这个脚本覆盖。其 V1 的 doom_loop 会在相同输入的工具调用重复 3 次时触发,但 V2 文档明确排除了 doom_loop、lsp 这两个当前 Core 权限动作。Cursor 的 loop_limit 限制的是 stop hook 自动续跑,也不是同一种防护。
我的判断
我认同先排查命令、输出和退出条件。这些问题有明确的检查入口,也能跨模型复用修复,比遇到重复就换模型更容易积累团队经验。
但作者「跨模型、新会话都出现,就不是模型原因」的表述过强。共同环境很可疑,多个模型也可能犯相似的判断错误。现有证据支持调整排查顺序,不能完成因果排除。
hook 的验证边界尤其要讲清:作者运行了 20 个测试用例,输入按三款工具文档中的载荷结构构造,并经过真实脚本处理;作者没有在 Claude Code、Codex、Cursor 三个应用内实际运行验证。它证明了一部分脚本逻辑,不等于产品集成已经验收。
与单纯设重试次数上限相比,比较结果更能容纳持续改善的测试过程;但原文没有给出误报、漏报对照。两个默认阈值属于经验选择。清洗输出还可能抹掉有用差异,动态噪声未清理干净也可能逃过检测。
最值得采用的是分层处理思路,具体脚本仍要在自己的环境里验收。
能拿来做什么
- 给前端和 Node 仓库补齐非交互执行约定,明确
git commit -m、npm init -y等写法;启动 dev server、watcher 时放到后台,再用一次阻塞等待检查预期产物或就绪状态。 - 遇到重复执行,先并排查看最近三次命令和完整结果;发现输出截断,就读取保存的文件或缩小输出范围,别直接再跑一次。
- 在仓库说明中加入重复失败停止规则;接入 hook 后,亲自检查第一次提醒、后续拦截和新消息重置,确认工具实际传入的数据符合预期。
- 长实现任务先把计划、当前状态和关键错误写入文件,再交给新会话继续,减少关键信息丢失和无进展调用带来的上下文读取成本。