Agent 记忆评测不能只看召回率
Memora 聚焦长期记忆的修订、遗忘与冲突问题,指出现有基准多数只需少量历史会话就能作答。高召回分数未必能反映 Agent 在偏好和项目状态持续变化时的可靠性。
AI 深度解读
AI 助手记得你用过什么框架、正在做什么项目,听起来很贴心。但如果项目已经结束、偏好已经改变,它还拿旧信息给建议,记性好反而会添乱。围绕 Memora 基准的这篇文章,讨论的就是这个问题:长期记忆不能只考「记住多少」,还得考「能否停用过期信息」。
研究结果有个反直觉之处:专用记忆系统确实更擅长回忆,但历史积累越多,它们调用失效事实的问题也越明显。对正在给 Agent 加记忆的程序员,这比单纯比较召回率更有参考价值。
记得住旧事,为什么还不算好记忆
作者引用的论文是 Uddin 等人的《From Recall to Forgetting》,发表于 Findings of ACL 2026。论文认为,现有长期记忆评测偏重事实检索,对持续修订关注不足。
这个判断有具体依据。LoCoMo 中,94% 的评测问题最多依赖两次历史会话;LongMemEval 中,这个比例是 85%。主要基准里的问题平均只需要约一次会话的信息。即使涉及变更,LongMemEval 在评测前最多允许两次知识更新,PersonaMem 处理的变化也不超过三次会话。
这样的测试更接近「从聊天记录里找答案」。但真实用户会修改计划、完成目标、撤回要求。同一条信息,昨天正确,今天就可能失效。
原文还提到,OpenAI 的 memory FAQ 承认,之前的 saved-memories 系统经常出现信息陈旧,也可能同时保存相互矛盾的记忆。这是产品文档中的描述,不能直接当成对当前所有产品版本的测评结论,但它说明问题并非只存在于论文设定里。
长期记忆的难点,是在保留历史的同时,分清哪些事实现在仍然有效。
Memora 怎样把「该忘没忘」测出来
Memora 模拟了 10 种职业角色,包括工程师、研究员、设计师和管理者。它设置 weekly、monthly、quarterly 三档历史跨度,每个角色分别约有 155、615、1,991 次会话,每次约 16 轮。这些标签表示模拟历史的跨度,不是每周、每月或每季度只聊一次。
quarterly 档平均包含约 1,171 次记忆操作,其中新增占 63%,更新占 18%,删除占 19%。评测覆盖偏好、活动、目标三类记忆,并用显式记忆轨迹记录变化,因此能判断答题时哪些事实已经过期。
任务分为三种:Remembering 检查事实回忆;Reasoning 要求组合多条记忆推导答案;Recommending 检查建议是否符合用户当前偏好。
评分采用 FAMA,即 Forgetting-Aware Memory Accuracy。普通准确率侧重答案有没有包含正确信息,FAMA 还检查有没有混入失效信息。每道题都设置「必须包含」和「必须排除」的条件,由三个 LLM 裁判逐项投票,研究报告其与人工标注的平均一致率为 88.3%。
例如,用户先喜欢非虚构作品,后来改为偏好当代小说。系统再推荐历史人物传记,即使能追溯到真实的旧聊天,也不该得分。
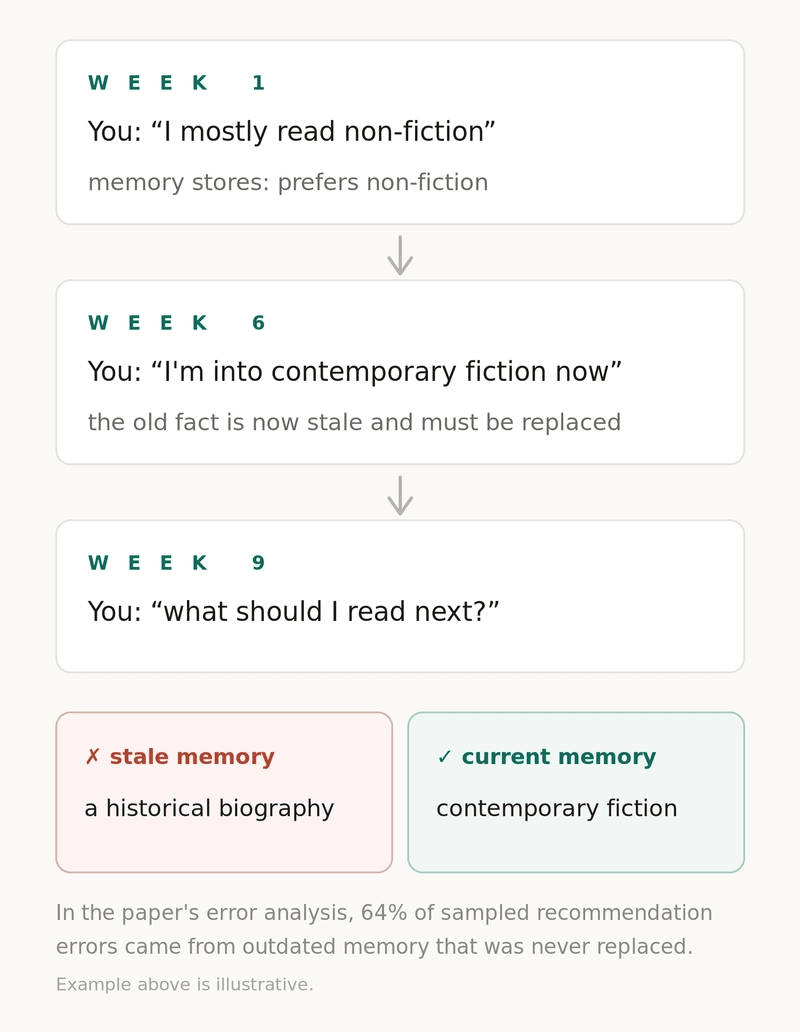
这里的「忘记」首先是让旧事实退出当前答案,不一定要求把历史记录物理删除。保留变更经过,与停止使用旧版本,可以同时做到。
记忆系统赢了回忆,却没解决推理
研究测试了两组系统。一组是直接读取聊天历史的 GPT-5.2、Claude Sonnet 4.5、Gemini 3 Pro Preview、Qwen3-32B,并比较启用和不启用 reasoning tokens 的表现。
另一组是六个专用记忆 Agent:A-Mem、LangMem、Mem0、MemoBase、MemoryOS、Nemori。它们负责跨会话存储和检索,统一通过 GPT-4o-mini 回答。因此,这不是同等模型能力下的「有记忆与无记忆」对照。
以下汇总分数将三档时间设置相加,满分是 300,不能当成百分比。
回忆任务上,记忆 Agent 的汇总 FAMA 为 119.5,直接读历史的 LLM 为 65.7,前者接近后者两倍。显式存储确实能帮助系统找到过去说过的事。
推荐任务却没有拉开优势:普通 LLM 为 144.7 至 153.3,记忆 Agent 为 138.4。论文作者的解释是,推荐允许一定程度的模糊匹配,模型可能仅凭角色线索就猜出看起来合理的偏好。这是对结果的解释,不能据此认定推荐不需要记忆。
推理任务则普遍较弱。记忆 Agent 的最佳平均表现为 27.6,LLM 为 12.4 至 13.9,reasoning tokens 带来的差异很小。研究者人工分析的推理错误样本,都涉及只检索到部分信息就作答。例如记录了多笔月度支出后,系统只回答「预算内」,没有计算剩余额度。这里的结论限于抽样分析,不能扩大成所有推理错误都由检索造成。
历史变长后,两组系统还有相反走势。直接读历史的 LLM,过期记忆扣分从 weekly 的 32.6 降到 quarterly 的 17.8;原文解释,旧对话掉出了上下文窗口,模型无法再引用它们。记忆 Agent 的扣分却从 18.2 升到 29.5,积累的信息越多,失效事实越容易进入答案。
评价标准甚至会改变排名。monthly 档里,MemoryOS、A-Mem 的普通记忆准确率分别为 112.8、112.0,高于 Nemori 的 105.4。但它们的过期记忆扣分分别是 28.4、29.5,Nemori 只有 15.4。计入 FAMA 后,Nemori 反而领先。
在抽样分析的推荐错误中,64% 来自没有被作废的旧记忆。系统不是没记住,而是选错了应该生效的版本。
我的判断
我认同这项研究对评测方式的修正。只检查「答对了什么」,会漏掉「不该再提什么」。对于保存用户偏好和项目状态的 Agent,这两类检查应该同时存在。
但它还不足以证明某套记忆框架普遍更好。对话由 LLM 模拟,只有 10 种角色和三类记忆;评分依赖 LLM 裁判,88.3% 的人工一致率也不代表判断完全可靠。六个 Agent 使用 GPT-4o-mini,而直接读历史的一组使用其他模型,结果更适合观察各自的错误模式,不能用来单独衡量记忆层带来的净收益。
论文作者认为,真实交流更含糊、更矛盾,因此模拟基准可能只是难度下界。这个推断有道理,但原文没有提供真实用户实验来确认。
与不断追加聊天摘要相比,维护当前状态更符合这项评测暴露的问题。不过,原文没有给出版本化存储、状态表、检索过滤等实现之间的对照数据,也没有说明成本。它提供了评测方向,尚未给出可直接照搬的最佳架构。
更长的上下文和更大的记忆库,都不能自动替代信息更新机制。
能拿来做什么
- 给日常 AI 编程助手保存项目约束时,把「当前使用的框架、部署目标、代码规范」与历史变更区分开。用户明确修改要求后,让新记录取代旧记录的生效位置,检索时优先返回当前状态。
- 给 Agent 补一组包含纠正和撤回的评测。先告诉它某个项目约定,再修改或取消约定,最后检查生成的建议是否仍引用旧要求。只测试首次写入后的回忆,会漏掉这里最关键的问题。
- 为每个评测样例同时写出必须包含和必须排除的内容。正确答案里夹带过期约束,也应计为错误;这比只看回答是否提到目标关键词更能发现问题。
- 遇到需要汇总多条历史记录的任务,先检查检索材料是否齐全。Memora 的推理样本提示,拿到几个相关片段就开始计算,可能比模型是否开启 reasoning tokens 更影响结果。