编程模型选型:交付速度之外看什么
同一仪表盘任务中,Muse Spark Open 用 16 秒交付却存在空白图表,DeepSeek V4.1 Flash 用时 2 分 29 秒并通过浏览器检查交付可用页面。案例显示,文本搜索式验证会漏掉 CSS 结构造成的视觉故障。
AI 深度解读
16 秒交付一个看起来完整、实际没有柱条的仪表盘,和花 2 分 29 秒交付一个经过浏览器检查的页面,你会选哪个?作者把 Muse Spark Open 和 DeepSeek V4.1 Flash 接入 Claude Code,发现速度、单价和「已验证」都可能误导选型。
这组测试更有用的结论是:要比较模型在你的配置下完成任务的质量、耗时和成本,尤其要检查它如何证明自己做对了。不过,测试规模很小,两个模型的推理配置也不一致,结果需要带着前提看。
16 秒的「完成」,为什么没有交付价值
据作者介绍,Meta 在 10 月 15 日公开 Muse Spark Open 权重,他们在 16 日对两个模型进行了相同的编程测试。
仪表盘任务中,Muse 在 16 秒后宣称,已经确认实时获取 data.json,并展示了全部四项指标。它的验证方式却只是搜索文件中是否出现预期文本,没有实际渲染页面。
问题出在 HTML 层级和 CSS 选择器不匹配。下面这段原文代码展示了故障原因:
<div class="row c0">...</div>
<div class="bar"><div class="fill"></div></div>
<style>.c0 .fill { background: ... } /* matches nothing */</style>
要看最后一行:.c0 .fill 只匹配 .c0 内部的 .fill,但这里柱条和 .row.c0 是兄弟元素。宽度动画仍然执行,填充元素却没有背景色,页面上所有柱条都不可见。
DeepSeek 用了 2 分 29 秒,通过无界面 Chrome 打开页面、检查截图,最终交付了可用的仪表盘。它也有错误:一张卡片页脚把两个任务的合计写成了「各自」,数字正确,措辞不准确。
「已验证」是否可信,要看它执行了什么检查。
搜索文本能确认文件里写了什么,无法确认浏览器最终画出了什么。这正是前端任务里容易被「完成速度」掩盖的差别。
每秒输出多少 token,为什么会得出相反排名
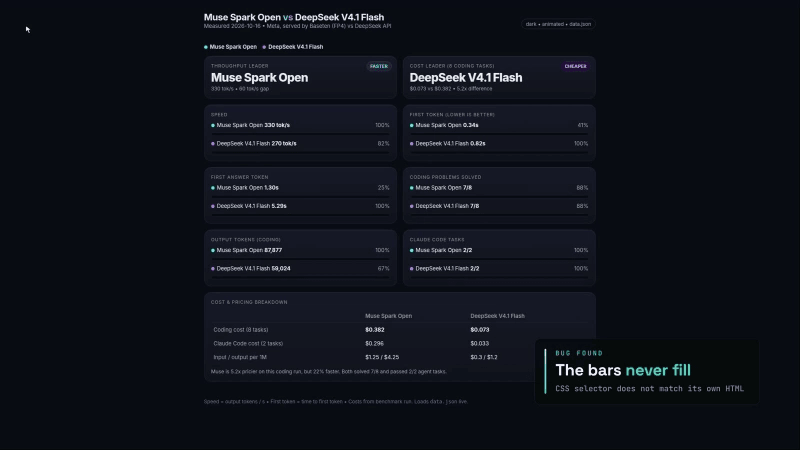
在速度测试中,Baseten 托管的 Muse 用 2.5 秒开始展示代码,输出速度达到每秒 455 tokens。DeepSeek 为每秒 197 tokens,却把全部 1,500-token 预算耗在内部推理上,最终没有输出代码。
但 Artificial Analysis 汇总各供应商的中位数后,排名反过来了:DeepSeek 为每秒 179 tokens,Muse 为每秒 102 tokens。
原因之一是,测试对象包含了服务商的部署方案。Baseten 使用 Muse 的 NVFP4 版本,把权重压缩为 4 位数值,减少存储和数据搬运开销。其用量数据还显示使用了推测解码(speculative decoding):先低成本猜测后续 token,再由大模型批量核验。
作者认为两者可能都贡献了速度优势,但实验没有分离各自的影响。因此,每秒 455 tokens 描述的是这次 Baseten 服务的表现,不能直接推广到所有 Muse 部署。
计时起点也会改变体验判断。常见的首 token 延迟可能包含用户看不到的推理 token。在另一轮上午测试中,DeepSeek 不到 1 秒就产生了首 token,但首段可读内容要等 3 至 6 秒;Muse 约需 1 秒。
对交互式编程助手,应该单独记录「首个回答 token」的时间。后台已经开始思考,不代表开发者已经看到回应。
便宜多少,要把推理和代理配置一起算进去
作者使用 LiveBench 提供的 8 道 AtCoder 编程题测试,两者都解出 7 道,也都栽在同一道题上。
相同通过数下,Muse 产生约 88,000 个输出 tokens,DeepSeek 约 59,000 个。按标价计算,8 道题分别花费 0.38 USD 和 0.07 USD。对一个玩具银行库执行 Claude Code 小任务时,两者都通过全部隐藏测试,平均每任务成本分别为 0.148 USD 和 0.016 USD。
这些 DeepSeek 费用按高峰价格计算,作者建议将其视作本次用量对应的费用上限。推理也按输出收费,所以只比较每百万 token 单价,还不足以预测完成任务需要多少钱。
不过,仪表盘结果存在一个明显的配置变量。
Claude Code 发送 Anthropic 格式请求,Baseten 只接受 OpenAI 格式,作者通过 LiteLLM 代理转换,并把 Muse 的 reasoning effort 设为 medium。DeepSeek 使用自有的 Anthropic 兼容端点,保持默认的 high。
这是控制推理投入的设置。Muse 如果同样使用 high,会不会主动打开页面检查?作者没有测试,答案未知。
模型、托管服务和代理配置,共同构成了这次实验对象。
我的判断
我赞同作者把验收行为和单任务成本放到选型中心。对于前端交付,实际打开页面通常比检查几个字符串更接近用户结果;对于 AI 编程预算,完成一道题花多少钱,也比 token 单价更有参考价值。
但这组结果不足以证明某个模型普遍更可靠。全部测试只在一天内各跑一次,样本是 8 道题和 3 个 Claude Code 任务,而且题目公开,两个模型都可能在训练中见过。仪表盘的推理投入还不一致。它提供了值得复测的线索,没有给出稳定的胜率。
比起单看公开榜单,这种完整任务测试更贴近工作;比起同配置、多次重复的对照实验,它又缺少控制变量和重复性证据。不能把一次会用浏览器的表现,直接当作模型的固定习惯。
开放权重也不等于普通团队能轻松本地部署。作者给出的 Muse FP4 权重体积约为 408 GB,且没有亲自尝试部署;他们此前在两张显卡上运行过 DeepSeek V4.1 Flash,但本文没有交代硬件型号和具体表现,不能据此推算自己的部署成本。
能拿来做什么
- 给前端 AI 编程任务补上浏览器验收要求,让代理实际打开页面,并检查图表、布局和交互;交付时要求它说明执行了哪些检查。
- 用同一批真实小任务比较候选模型,同时记录成功数、包含推理的输出 tokens、实际账单和首个可读回答的等待时间。
- 在 Claude Code 接入第三方模型时,保存 LiteLLM 等代理的配置,明确记录
reasoning effort,避免把配置差异算成模型能力差异。 - 在决定长期使用前,对关键任务重复测试,并按实际供应商和使用时段计算费用,不直接套用单次测试里的速度与价格。