推理拆分部署,瓶颈可能在交接调度
文章分析预填充与解码分离后的性能问题:缓存交接的开销可能主要来自解码端的准备工作,而非网络传输。共享循环被频繁打断,会拖慢生成、延长槽位占用并引发排队。
AI 深度解读
把大模型的提示词处理和答案生成拆到两组 GPU,首个 token 反而慢了一秒,问题就一定出在网络吗?原文借 vLLM 的测试提出另一种解释:KV cache 搬运只需约 10 ms,真正拖慢请求的是交接时的准备工作,以及它引发的排队。
这件事值得程序员读,因为它和 Node.js 事件循环、数据库连接池是同一类问题:每次多占用一点时间,低负载时看不出来,接近容量上限后,等待就会迅速放大。
缓存传输只要 10 ms,首个 token 为什么等了一秒
Prefill 负责读完整个提示词,建立 KV cache;Decode 利用这些缓存逐个生成 token。前者主要受计算能力限制,后者主要受内存读取限制。把两者拆开,可以减少长提示词对其他请求生成过程的干扰,分别调整首 token 延迟和每 token 耗时。
代价是请求必须跨两组 GPU 交接缓存。原文强调,拆分的主要收益是延迟更稳定,不能把它当成增加吞吐量的保证。
文中引用的 vLLM 测试使用 Qwen3-32B,部署在两台各有 8 张 H200 的服务器上。提示词长 16,000 token、请求速率为每秒 8 次时,默认交接方式的首 token 延迟约为 1,744 ms,另一种交接方式将其降到约 540 ms。
这段差距很难单靠传输解释。按文中的模型配置,每个 token 的 KV cache 占 256 KiB,16,000 token 约为 4.2 GB。使用 8 路张量并行时,每张 GPU 通过自己的链路发送对应分片;按每张 GPU 50 GB/s 计算,搬运约需 10 ms。
这是带宽条件成立时的估算,不是所有部署都能达到的实测结果。但它提供了排查方向:秒级延迟不能只盯着网络字节数。
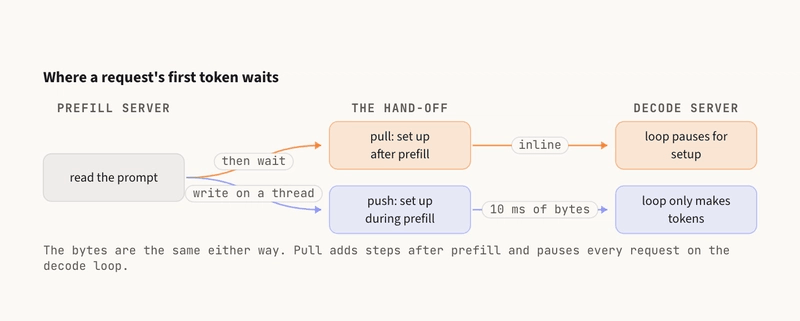
原文把额外时间拆成两部分。首先,pull 在 prefill 完成后依次传递缓存位置、分配 decode 空间、读取缓存,步骤串行发生。其次,部分准备工作运行在 decode 主循环上,而这个循环还要推进所有正在生成的请求。它忙于提交传输任务时,其他请求的 token 也会被耽搁。
每个 token 慢几毫秒,为什么会变成排队一秒
可以把 decode 主循环类比成 Node.js 事件循环:上传接口每次同步解析一小段数据,单次耗时不长,但所有连接共享的循环都会受影响。
文中引用的 vLLM PR 45211 测量显示,在 2,000-token 提示词下,每个请求提交传输工作的耗时为 14.7 ms。每秒 8 个请求,累计约占主循环时间的 12%。把这项工作移到独立线程后,每 token 耗时从 6.14 ms 降到 5.52 ms。
接下来还有容量放大效应。请求生成结束前,会一直占用一个 decode slot,也就是服务器允许同时生成的请求名额。按照 Little's law:
平均占用槽位数 = 每秒请求数 × 输出 token 数 × 每 token 耗时。
下面这段原文代码把缓存大小、理想传输时间和槽位需求放到一起计算:
def kv_bytes(tokens, layers, kv_heads, head_dim, dtype_bytes=2):
    return tokens * layers * 2 * kv_heads * head_dim * dtype_bytes

def transfer_ms(nbytes, link_gb_s, tp=1):
    return nbytes / tp / (link_gb_s * 1e9) * 1000   # 每张 GPU 发送自己的分片

def slots_held(qps, out_tokens, tpot_ms):
    return qps * out_tokens * tpot_ms / 1000         # Little's law

transfer_ms(kv_bytes(16_000, 64, 8, 128), 50, tp=8)  # 10.5 ms
slots_held(8, 128, 10.4)                             # 10.6,实际只有 8 个槽位
重点看最后一行:平均需求已经超过配置的容量,请求就需要等待。
在前面的 16,000-token 测试里,push 的每 token 耗时为 7.0 ms,pull 为 10.4 ms。输出长度为 128 token 时,每秒 8 个请求分别需要约 7.2 和 10.6 个槽位,而服务器设置的是 --max-num-seqs 8。
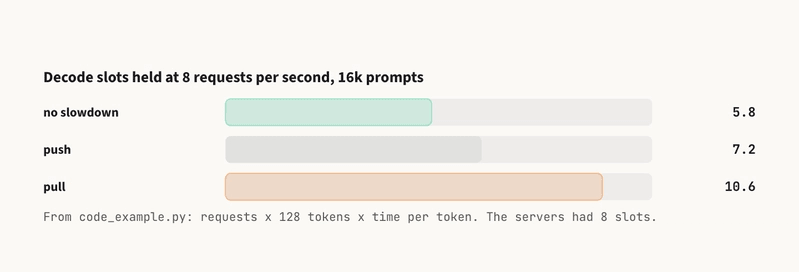
于是,每 token 多出的几毫秒,延长了槽位占用时间,最终让新请求排队。每秒只有 1 个请求时,pull 平均只占约一个槽位,两种方式的差距就不明显。
输出长度同样关键。原文把 2,000-token 的 Agent 回答与 128-token 聊天回复比较,前者占用槽位的时间约为后者的 16 倍。请求数一样,容量需求也可能相差很大。
Push 能缩短交接,但要提前决定谁来生成
文中描述的 push 路径,会在请求到达时让 decode 注册空闲缓存块,再由 prefill 的后台线程直接写入。它将准备工作提前,并移出 decode 主循环,减少 prefill 完成后的串行等待。
原文给出的 prefill 启动配置如下:
vllm serve Qwen/Qwen3-32B --tensor-parallel-size 8 --max-num-seqs 8 --port 8100 \
  --kv-transfer-config '{"kv_connector":"NixlPushConnector","kv_buffer_device":"cuda",
    "kv_role":"kv_producer","engine_id":"prefill-engine-001","kv_rank":0,
    "kv_parallel_size":2,"kv_connector_extra_config":{"backends":["LIBFABRIC"]}}'
重点是 NixlPushConnector 和角色配置。Decode 端需要使用相同 connector,并设为 "kv_role":"kv_consumer"。原文提醒,混用模式会在第一个请求后导致服务器崩溃;但没有交代适用版本,不能把这条命令当成跨版本通用配置。
Push 还需要提前掌握 prefill 地址的代理,示例使用 disagg_proxy_pushconnector_demo.py。它也提前选定 decode 服务器,放弃了 prefill 完成后再按负载选择目标的灵活性。如果各 decode 实例负载不均,pull 的晚决策可能更有价值。
验证时要同时改变请求速率和提示词长度。原文用 vllm bench serve,设置 --model Qwen/Qwen3-32B,让 --request-rate 遍历 1 2 4 8,--random-input-len 遍历 1024 16384,固定 --random-output-len 128 --num-prompts 400。
观察重点包括每 token 耗时,以及 decode 端的 vllm:num_requests_waiting。再比较 prefill 服务自身与代理侧的首 token 延迟,两者差值可用于观察交接和槽位等待。只有高负载下的等待下降,才能说明改动解决了目标问题。
我的判断
作者最有价值的地方,是把「网络慢」拆成了传输、主循环阻塞和容量排队三个可验证的问题。线程迁移前后的数据,以及 push、pull 在指定负载下的差距,都支持这条分析路径。
但这些证据不能证明所有拆分部署都该改成 push。文中的数字来自特定模型、硬件和配置;SGLang、Dynamo、llm-d 被列为相关系统,却没有各自的对照数据。其他实现是否存在同样的主循环开销,需要单独测量。
作者建议把平均槽位占用控制在 --max-num-seqs 的约 80% 以下,这是容量经验,原文没有提供足以证明该阈值普遍有效的对照实验。Little's law 算的是平均占用,也不能直接保证突发流量下的尾延迟。
短提示词场景可以先考虑单服务的 chunked prefill。只有一个 GPU 节点时,拆分仍要承担两个资源池和代理的成本;decode 已经满载时,换交接方式也不能替代扩容。
先定位时间花在哪里,再决定是否拆分、是否换 push。
能拿来做什么
- 如果你维护 LLM 服务,先用生产高峰的请求速率、真实输出长度和每 token 耗时估算槽位需求。增加
--max-num-seqs前,要确认每张 decode GPU 都有足够的 KV cache 显存。 - 如果你维护 Node.js AI 网关,把代理侧与推理服务侧的首 token 延迟分别记录下来,结合服务端等待请求数,区分模型处理、交接与排队。
- 如果你准备切换 push,先确认能否提前选择 decode 实例,再用相同负载比较两种模式。既测短提示词和低请求速率,也测长提示词与生产峰值附近的组合。
- 如果你的 Agent 经常输出长答案,就单独统计这类请求的输出长度和槽位占用,避免直接沿用短聊天回复的容量估算。