AI 生成的数据库表能跑,还要核对业务需求
作者复盘了真实项目中修改 AI 数据库设计的五个案例。其中一个案例删除了用不到的历史统计表,另一个发现字段注释引用了产品中根本不存在的发布规则。
AI 深度解读
AI 生成的数据库结构,能让前端页面正常显示、后端顺利写入,照样可能把业务做偏。作者在开发一项 YouTube 频道分析和视频推广服务时,改掉了五处能跑的设计。问题有的出在多存了一份数据,有的出在把用户没用过的功能当成了前置条件。
这五个例子可以直接拿来审 AI 生成的 schema。看字段类型和表关系之外,还要问谁会填这个值、什么时候填,以及数据缺失时,用户手头的操作能不能继续。
建历史表之前,先问业务会怎么查
服务需要 YouTube 频道的订阅数、视频数和总观看量。这些数字会变,AI 给出的方案也很自然,单独建一张统计表,每个日期存一行。作者后来发现,按指定日期查询订阅数变化,外部 API 已经能满足当前分析需求,于是删掉了这张表。原文只明确说 API 能查订阅数变化,视频数和总观看量能否按日期查询,文中没交代。
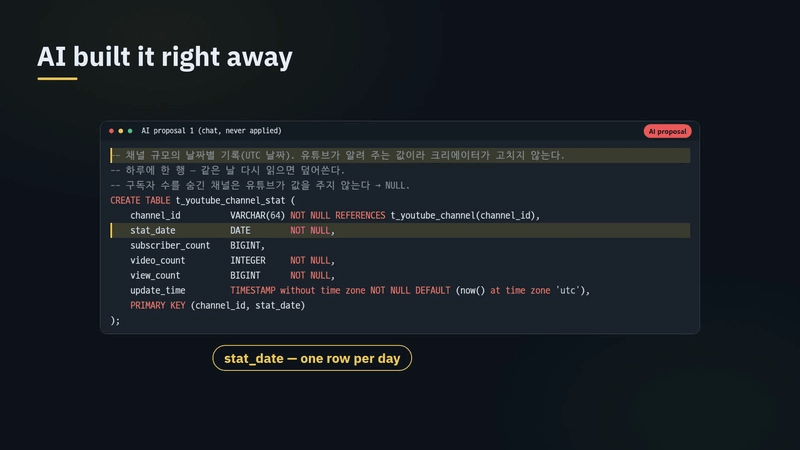
同一个订阅数字段还暴露了另一种问题。AI 在字段注释里举例,说订阅数可用于判断某个发布目标是否符合规则。服务里根本没有这条规则,订阅数实际用于对照频道规模和视频播放量,分析视频表现。注释本身不会影响写库,但下次让 AI 读 schema 生成发布逻辑时,它可能把注释里的假设写进判断分支。
用户只打开推广功能时,原视频语言从哪来
生成推广文案需要知道原视频的语言,部分 YouTube 频道又没有设置默认语言。AI 建议复用多语言字幕功能存下来的语言数据。对已经做过字幕的用户,这条路走得通。只用推广功能的人可能从没生成过字幕,这时推广流程就拿不到它依赖的值。
这里适合从页面入口倒推数据来源。用户直接打开推广页时,哪些数据已经存在,哪些要在这条流程里获取,哪些缺了就得让用户补?表结构可以把一个字段标为必填,字段究竟由谁、在哪一步填上,还得沿实际使用路径检查。原文没有交代作者最后选了哪种缺值处理方式。
表名、日期和发布结果都要对应实际职责
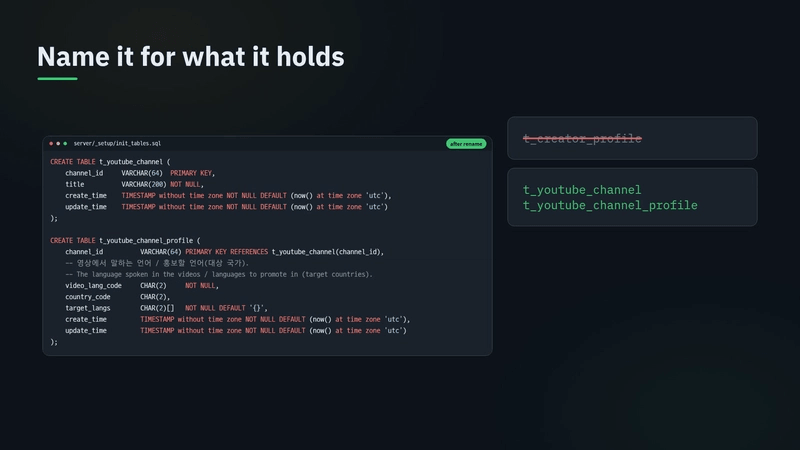
AI 起初把只含 YouTube 频道信息的表叫作 t_creator_profile,作者改用了 t_youtube_channel 和 t_youtube_channel_profile。原名指向范围更广的创作者资料,后续维护者容易对表里能放什么产生不同理解。
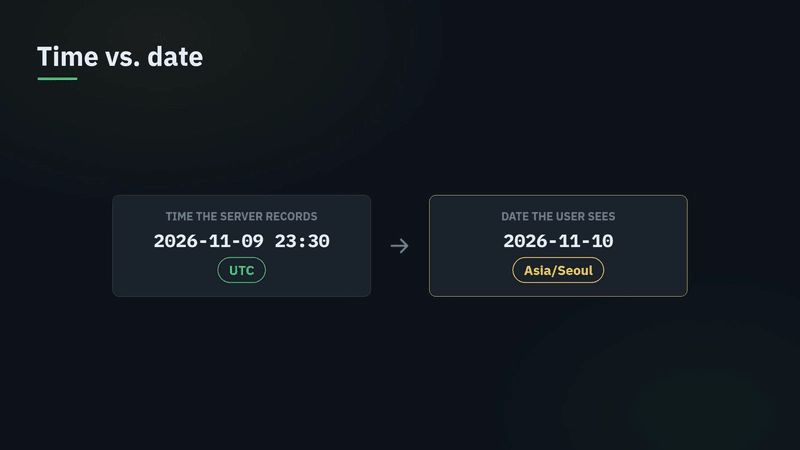
作者告诉 AI 服务器使用 UTC,AI 又把这个约定套到了日期列上。时间戳记录事件发生的时刻,可以用 UTC 保存。用户看到的日期涉及这个时刻在当地落在哪一天,跨过午夜就可能与 UTC 日期不同。作者把这条约定写进了 CLAUDE.md。至于 AI 起的 measure_time 和项目已有的 create_time,要先确认采集发生和记录创建是不是同一个事件,再决定字段怎么命名。
职责边界在发布环节也绕了一圈。对没有 API 的站点,AI 建议提供草稿和复制按钮,请用户逐站粘贴发布。作者希望把发布这一步也自动化,于是设计成由服务端提供一个文件,装入各站点的草稿和发布说明,用户再把文件交给自己的 AI。后来 AI 又提出回传发布结果、帖子 URL、观看数和评论数。作者认为,持续获取无 API 站点的数据需要另建采集系统,已经超出了这项服务的需要。
我的判断
最值得借用的是「从用户入口倒查字段」。对只做推广的用户,字幕语言有没有值,可以沿功能路径核对。相比只让 AI 检查字段类型、可空性和命名,这一步更容易找出被藏进表关系里的流程依赖。字段注释也适合和业务代码一起审,尤其是提到了权限、规则或发布条件的地方。
历史表留不留,则取决于外部数据源能否持续回答产品实际要查的问题。作者给出的是项目中的取舍,没有提供保留历史表与按需查询的对照数据,也没有交代外部 API 的历史覆盖范围。如果团队需要按过去某天的数据复算,得先确认到时候还能查到同样的数据。这属于经验之谈。
把发布说明交给用户自己的 AI,能省下多少操作,也要看用户侧 AI 能否访问对应站点、完成发布,以及用户要在哪一步介入。原文描述了方案,没有给出发布成功率或跨站验证结果。复制按钮把操作留给用户,文件交接把执行交给用户侧 AI,两种做法的差别落在发布这一步由谁完成。
能拿来做什么
- 审 AI 生成的 migration 时,给每张历史表写一条当前功能会执行的查询。外部 API 已经能回答时,先确认它覆盖所需的字段和日期,再决定是否落库。
- 给推广页走一遍新用户路径,从没用过字幕功能的账号直接打开页面,检查 Node 接口能不能拿到原视频语言,并明确缺失时要如何处理。
- 在
CLAUDE.md里写清哪些字段记录 UTC 时间戳、哪些日期按用户时区展示。审measure_time和create_time这类字段时,给每个名称对应一个明确的业务事件。 - 让 AI 生成发布逻辑前,对照现有需求检查 schema 注释里的规则,再逐项确认服务端到底要记录发布结果、帖子 URL,还是还要跟踪后续指标。