GitHub Copilot 上线两款微软自研编程模型
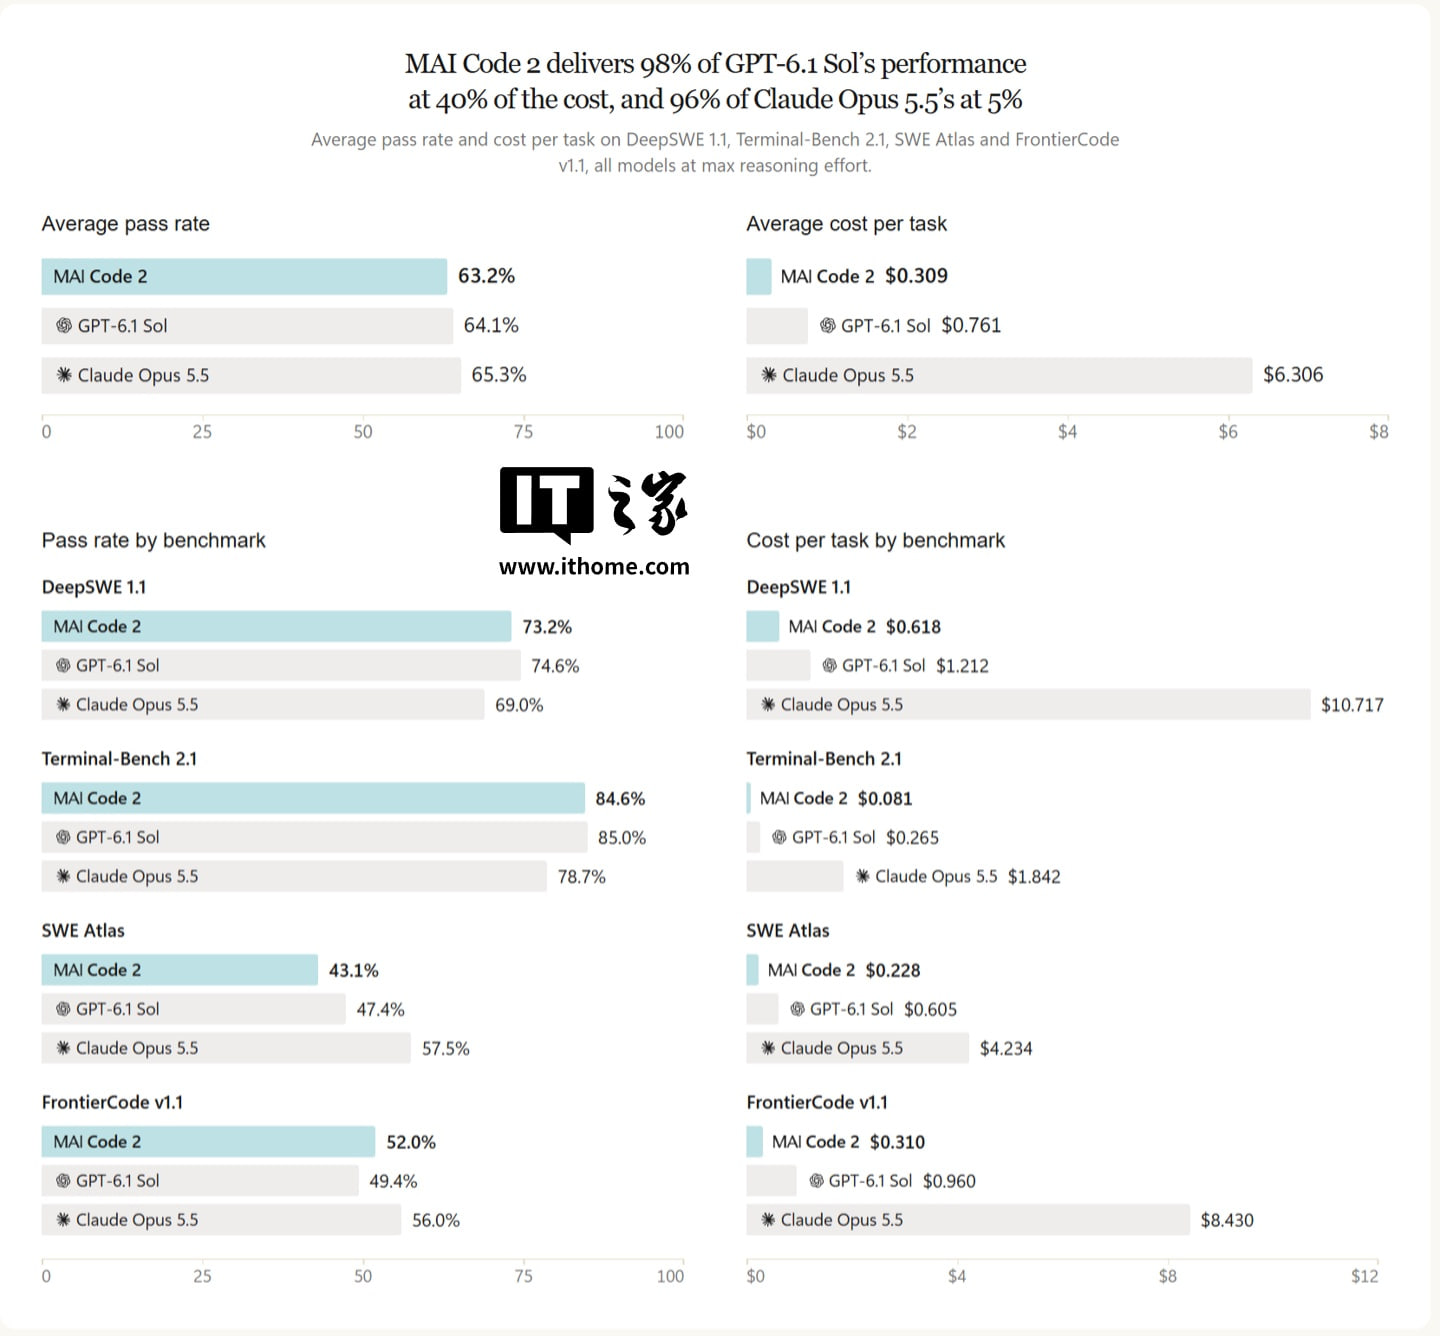
MAI Code 2 面向跨文件修改和复杂排错,Flash 面向高频小改动,后者也覆盖 Copilot Free 与 Student 用户。微软测试中,Code 2 平均每项任务花费 0.309 美元,约为 Claude Opus 5.5 的 5%,Flash 的促销期测试成本为 0.052 美元。
AI 深度解读
微软在 Ignite 2026 发布了两款自研编程模型,并已在 GitHub Copilot 上线。MAI Code 2 面向跨文件修改、复杂排错等任务,MAI Code 2 Flash 则负责解释代码、局部修复这类高频工作。
这次最有参考价值的是微软公布的单次任务成本。同一批编程基准里,Code 2 接近 GPT-6.1 Sol 的平均表现,任务成本约为后者四成。对每天用 Copilot 改代码的人,这组数字可以用来决定哪些任务先交给便宜的模型,以及什么时候该换模型。
什么时候用 Code 2,什么时候用 Flash
Code 2 适合改动范围还没摸清的任务,例如排查一个横跨前端和 Node 服务的错误,或先读懂仓库,再修改多个文件。它也能用于开发用户界面。微软希望它直接给出可用的修改方案,减少来回沟通,但报道没有给出节省了多少轮沟通的数据。
Flash 更适合范围已经明确的工作,例如解释一段代码、修一个已定位的常见问题,或者围绕同一处改动快速迭代。两款模型都能调用工具、分步骤推进任务,因此选择时可以先看要理解多少上下文、改动会波及多少文件。
使用资格也有区别。Code 2 面向符合条件的 Copilot Pro、Business、Enterprise 等订阅用户,Flash 还覆盖 Free 和 Student 用户。
约 5% 的成本,和约 96% 的性能分别怎么来的
按微软公布的四项编程基准平均结果,Code 2 达到 GPT-6.1 Sol 约 98% 的表现,平均单次任务成本为 $0.309,对方为 $0.761,前者约为后者的 40%。Claude Opus 5.5 的单次任务成本为 $6.306,原文标题里的「约 5%」来自 $0.309 与 $6.306 的比值。标题还写了「约 96% 性能」,但正文没有列出 Claude Opus 5.5 的对应成绩,读者无法从报道给出的数字复核这一比例。
Flash 的成绩来自 DeepSWE 1.1、Terminal-Bench 2.1 和 SWE Atlas 三项测试,平均通过率为 61.0%,高于 GPT-6 Luna 的 55.1% 和 Claude Haiku 5.5 的 53.9%。在 50% 促销定价下,Flash 的平均单次任务成本为 $0.052,分别相当于这两款对比模型的 65% 和 20%。做长期预算时,要把促销条件一起算进去。
我的判断
微软的基准结果支持把这两款模型纳入候选,但团队选型更该看一次合格交付的总成本。单次任务便宜,如果补提示、重试和人工审查花了更多时间,完成同一个修改仍可能更贵。报道也没说明测试成本如何对应 Copilot 的订阅额度,因此不能直接拿 $0.309 乘以团队的月调用量来估算账单。
和所有任务都默认用同一个模型相比,按任务范围分流有机会省钱。反过来,如果一开始就知道改动会跨模块,直接用 Code 2 也可能省掉一次试错。微软给出了模型之间的基准对照,但没有比较这两种用法的交付成本。至于 Code 2 能减少多少返工,目前还是产品主张。
能拿来做什么
- 用 Flash 处理验收条件明确的局部修改,例如给已定位的 React 组件补一个空状态,完成后跑对应测试并检查 diff。
- 遇到跨文件排错时,可以让 Code 2 先说明调用链和拟修改的文件,再根据测试结果判断它有没有解决问题。
- 用几条真实的历史任务对比现用模型与候选模型,记录首次通过率、重试次数和人工审查时间。把 Flash 的促销任务成本和团队实际的 Copilot 额度一起考虑。