审查AI代码,先看改动范围与历史风险
文章借历史软件缺陷研究,提出按跨子系统范围、改动规模和历史信息安排AI代码审查顺序。部分风险信号可从Git提取,帮助审查者优先检查高风险改动,而非只按文件路径阅读。
AI 深度解读
Agent 交来一长串 diff,最容易采用的审查方式,是按文件路径从上往下读。但目录排序只决定了谁先出现,并不决定哪里最容易出错。作者借两项相隔 13 年的缺陷研究,提出一个更实用的入口:先看改动散布到哪里、相对改了多少,再看这些文件过去有多折腾。
结论值得借鉴,证据边界也很清楚:研究支持用这些信号分配审查精力,却没有验证 Agent 代码,更没有验证作者提出的文件阅读顺序。把它当成审查导航,比当成质量判决更合适。
为什么先看改了多少地方,而不是先读代码
2000 年,Mockus 和 Weiss 分析了 Bell Labs 的 5ESS 电话交换机软件约十年间的 15,000 个变更请求。研究通过根因分析,区分正常发布的变更与导致更新失败的变更。
最终保留的六个预测因素是:涉及的子系统数、独立编辑次数、是否修复现场故障、首次到末次编辑的间隔、开发者经验,以及新增代码行数。前五项中除经验外,加上新增行数,都与更高失败风险相关;经验更多则对应更低风险。删除行数在完整模型中没有表现出显著关联,p = 0.87。
其中一个重要因素叫扩散度(diffusion):一个逻辑上的修改,需要动多少地方。
这很贴近日常开发:只是增加一个业务能力,却要同时改控制器、模型和几个服务,可能说明现有模块边界没有很好地承接这次需求。不过,跨模块也可能有合理原因,不能看到目录多就认定设计有问题。
2013 年,Kamei 等人把类似方法扩展到 11 个项目、超过 250,000 次变更,包含 Bugzilla、Columba、Eclipse JDT、Eclipse Platform、Mozilla、PostgreSQL 六个开源项目,以及五个商业项目。他们测量了五组、共 14 项属性。
结果中最稳定的是:涉及文件越多,11 个项目的缺陷风险都越高。新增行数相对于修改前文件大小的比例,在 10 个项目中与风险上升相关。
比例比绝对行数更有解释力。同样新增 200 行,放进原本只有 100 行的文件,和放进 5,000 行的文件,改动强度差得很远。
先看变更的形状,再进入实现细节,是这篇文章最值得拿走的方法。
三组 Git 检查,怎样帮助安排审查顺序
作者建议在 Agent 分支上,以它与 main 的共同祖先为比较基准。git diff main...HEAD 比较的就是这个基准与 HEAD,适合观察分支累计引入的修改。
下面这组命令解决第一个问题:任务到底扩散到了哪些地方。
git diff --shortstat main...HEAD
git diff --dirstat=files,0 main...HEAD
git diff --name-only main...HEAD \
  | cut -d/ -f1 | sort | uniq -c | sort -rn
重点看 --dirstat=files,0:它按变动文件统计目录占比,阈值设为 0%,避免隐藏小占比目录。最后一条统计顶层目录中的变动文件数,接近 2013 年研究以顶层目录代表子系统的处理方法。
但「跨几个目录算危险」没有通用答案。Bell Labs 的工具使用历史分布,超过过去 95% 变更涉及的子系统数量才触发提示,不是固定规定四个或五个目录。
第二组检查解决另一个问题:哪些文件接近被重写。
base=$(git merge-base main HEAD)
git diff --numstat --no-renames "$base" HEAD |
while read -r added deleted path; do
  before=$(git show "$base:$path" 2>/dev/null | wc -l)
  echo "$added $before $path"
done
重点比较输出的前两列:新增行数与修改前行数。两者接近甚至前者更大,作者建议优先检查;第二列为 0,则可能是新文件。--numstat 对二进制文件输出 -,所以这段脚本适合辅助观察文本代码,不能直接当成严谨的重写检测器。
它统计的也不是「旧代码被替换了多少」。大量追加代码同样可能触发提示,仍要结合实际 diff 判断。
第三组是历史检查。原文用 git log --oneline --since="6 months ago" 统计基准之前六个月的提交数,用 -i -E --grep='fix|bug' 找提交消息中的修复记录,再用 git log -1 --format=%cr 查看最近修改时间,最后按提交数 sort -rn。
这里有个容易漏掉的区别:六个月窗口只用于提交总数,修复记录数没有加这个时间限制。关键词命中也不等于确认缺陷,只能提供线索。
据此,作者给出的阅读顺序是:先解释扩散范围,再读频繁修改、频繁修复的热点文件,然后看疑似重写,最后读新文件和小修改。
这个顺序是作者的推演,两篇论文都没有直接测试。
这些指标为什么只能提示风险
2013 年研究的模型平均识别出 64% 的缺陷引入变更,准确率为 68%,精确率为 34%。精确率说的是:被标成高风险的变更中,约三分之一确实引入了缺陷。
所以,它更适合回答「先看哪里」,很难回答「能不能合并」。
研究还发现,按每行改动的预测风险给完整变更排序,审查 20% 的变动行,平均能找到 35% 的缺陷引入变更。但这是不同变更之间的排序效果,不能拿来证明同一个 diff 内先读哪个文件更有效。
有些信号也明显依赖项目。修复任务在六个开源项目中的四个与更高风险相关,在五个商业项目中都没有这一结果。文件越近期被修改,在所有开源项目中都对应更高风险,但两个商业项目的方向相反。
开发者经验更不稳定:三个项目中对应风险上升,另三个对应下降。Agent 如果使用你的 Git 身份提交,算出来的还是你的经验,解释价值进一步下降。
作者开发的 Hermes IDE 把审查单位缩小到 Agent 的每一轮。Review Desk 可按轮次或文件查看修改,支持把行评论交回写出该行的 Agent 会话。快捷键为 macOS 的 ⌘G,Windows、Linux 的 Ctrl+Shift+G。
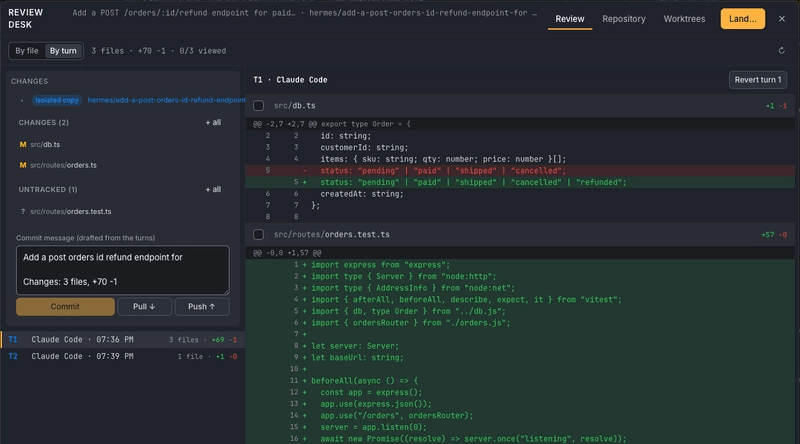
截图里的 orders-api 有两轮 Claude Code 修改:T1 涉及 3 个文件、+69 −1;T2 涉及 1 个文件、+1 −0。这个粒度便于趁上下文仍在时追问,但作者明确没有声称产品风险标记复现了论文模型。Hermes 免费,源码采用 BSL 1.1 提供,支持 macOS、Windows、Linux;这些产品介绍也需要结合作者身份来看。
我的判断
我赞成把扩散、相对大小和历史放在审查入口。相比按路径阅读,它们至少迫使审查者先确认:这次需求为什么需要这些修改。相比只盯新增行数,相对大小也更能反映局部改动强度。
但这套方法目前仍是有研究依据的经验迁移。两项研究面对的是 CVS、SCCS 时代的 C、C++、Java 人类代码,没有 Agent 代码的对照实验。开源项目中的修复识别和缺陷追溯,还依赖提交关键词与 SZZ 算法,存在误标可能。
作者提出的具体阅读顺序,同样没有效果对照数据。热点文件优先有道理,小改动也不能因此免检,论文漏掉的缺陷引入变更,多数恰恰涉及文件较少,或者不属于修复任务。
对团队而言,更合理的位置是把这些检查放在测试、静态检查和人工业务审查之前,用来安排注意力。它们不能证明逻辑正确,也不能代替验证。
能拿来做什么
- 下次审查 Agent 分支时,先运行扩散统计,对照任务解释每个被触及的目录。若一个 Node 接口修复牵动多个服务,先确认这些修改之间的依赖关系,再逐行阅读。
- 对新增行数接近文件原长度的代码提高审查优先级,检查 Agent 是否在实现需求时顺手重写了周边逻辑,并核对原有行为是否仍被保留。
- 把频繁提交、修复记录多的文件列为重点,但保留对新文件和小修改的完整检查,避免把低风险提示误读成免检。
- 如果 Agent 工作有清楚的轮次或提交边界,就逐次检查这些信号,趁上下文仍在追问扩散原因;合并前再检查整条分支的累计修改。