Kimi迁移需排查参数兼容与推理费用
据文章转述的官方文档,K2 系列已停止向新账户开放,并计划于 2026 年底退役,替代型号为 kimi-k3.1-pro。迁移涉及固定采样参数、思考开关变化及默认 max 的 reasoning_effort;作者未调用 API,费用占比来自示例计算。
AI 深度解读
Kimi K2 的迁移窗口已经打开:按原文引用的 Moonshot 文档,自 2026-10-31 起,K2 系列停止向新注册用户开放,已有用户暂时可继续使用,全部 K2 模型计划在 2026 年 12 月底退役。官方指定的迁移目标是 kimi-k3.1-pro。
真正需要提前处理的,是请求参数、对话历史和账单。K3 不再支持关闭思考,reasoning_effort 默认还是 "max"。原文作者没有调用 API,而是整理官方说明、第三方测试,再用假设工作量算账。这篇最有用的地方,是把一次模型升级拆成了可以检查的工程问题。
换掉 model 之前,先检查哪些请求会失败
退役通知需要分开理解:新用户已经受到限制;已有账号当前不受影响;「12 月底」是计划,文档没有给出精确的停服日期和时刻。固定使用 kimi-k2.6、kimi-k2.7-code 及其 highspeed 变体的应用,都应该安排迁移。
作者还整理了官方列表中的四次历史退役事件,日期落在 2025-11-11 至 2026-08-31,三段间隔分别为 78、117、98 天,平均约 98 天。
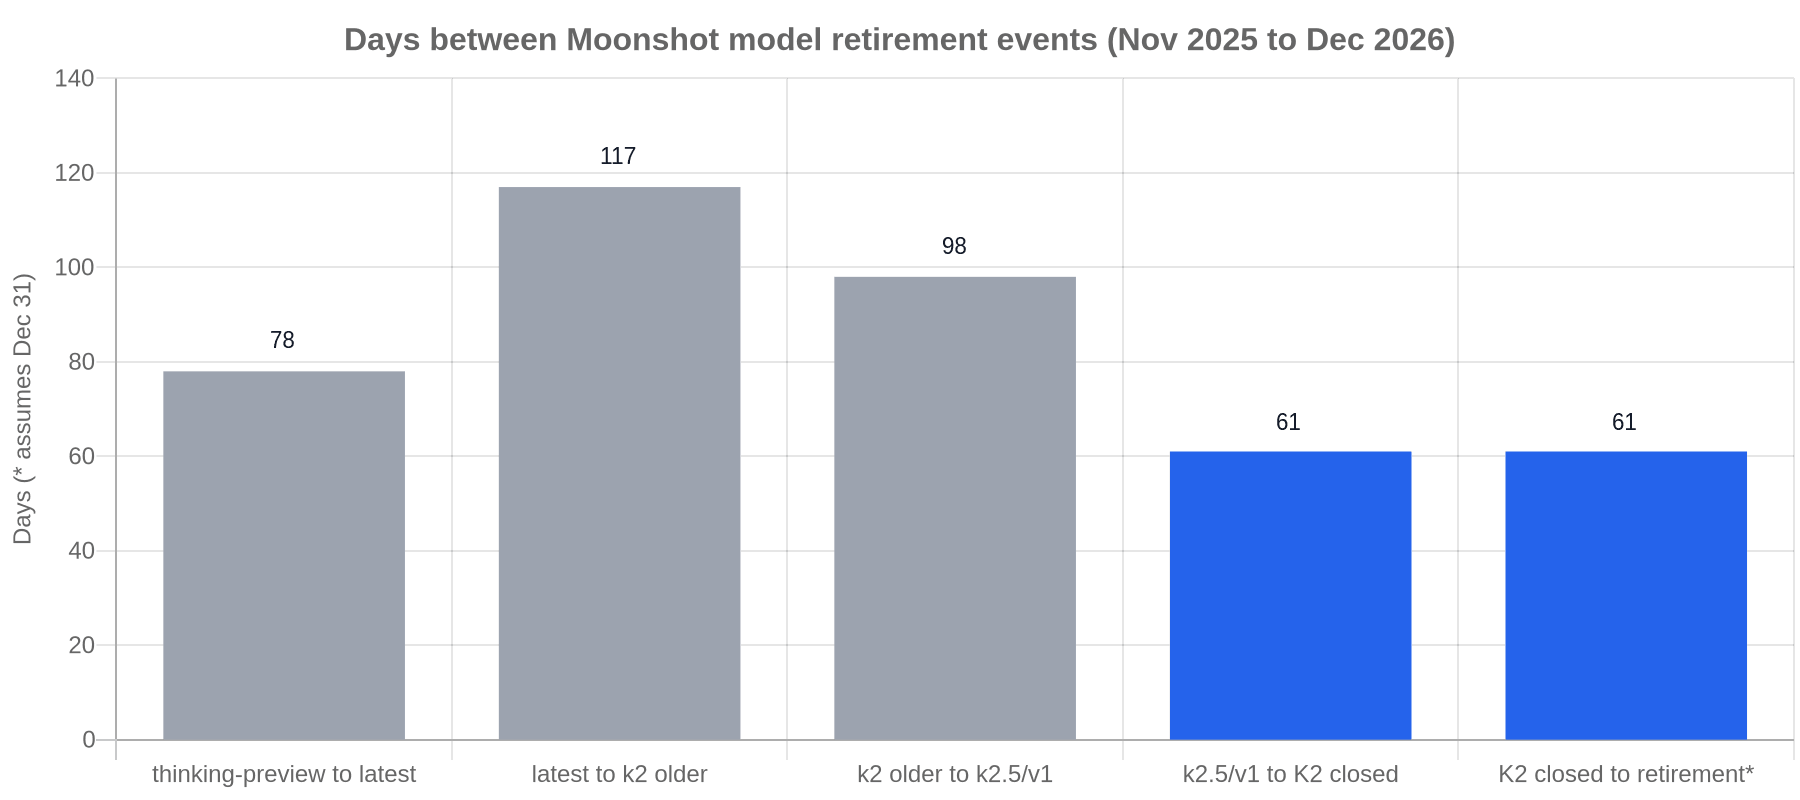
这只能说明该平台过去存在持续更替,不能据此推导固定周期。对开发者更有价值的问题是:下一次替换模型,需要改多少处代码?
K3 的参数变化足以让「只换名字」的请求报错。官方将 temperature、top_p、n、presence_penalty、frequency_penalty 列为固定参数,传入其他值会返回错误,建议直接不传。旧封装为了提取任务统一设置 temperature=0.2,迁移后就可能失败。
原文引用的第三方迁移测试报告了 HTTP 400,包括 invalid temperature: only 1 is allowed for this model,以及拒绝关闭思考。该测试通过聚合平台进行,部分行为与 Moonshot 官方接口存在差异,适合拿来补测试用例,不能直接当官方规格。
下面的原文适配器展示了需要清理哪些请求字段:
K3_FIXED = ("temperature", "top_p", "n", "presence_penalty", "frequency_penalty")

def to_k3(req: dict, effort: str = "high") -> dict:
    out = dict(req)
    out["model"] = "kimi-k3.1-pro"
    out.pop("thinking", None)             # K2-only switch
    for key in K3_FIXED:                  # fixed server side: do not send
        out.pop(key, None)
    if effort not in ("low", "high", "max"):
        raise ValueError("reasoning_effort must be low, high or max")
    out.setdefault("reasoning_effort", effort)
    stop = out.get("stop")
    if isinstance(stop, list):            # limits reported by a third party, verify
        assert len(stop) <= 5, "more than 5 stop sequences"
        assert all(len(s.encode("utf-8")) <= 32 for s in stop), "stop > 32 bytes"
    return out
要留意 out.setdefault("reasoning_effort", effort):它保留请求里已有的值,前面的校验只检查函数参数 effort,没有检查请求自带的值。这是一段迁移草图,不能直接当成完整校验库。stop 最多 5 项、每项最多 32 字节,也只是第三方报告的限制,仍需验证。
另外两处变化容易藏在业务代码里。K3 不支持 K2 的 thinking 开关,不能再靠 thinking={"type": "disabled"} 关闭思考;多轮对话和工具调用需要原样回传完整 assistant 消息,包括 reasoning_content。如果 Node 服务保存历史时只保留 role 和 content,就需要调整。新增能力则是支持 tool_choice: "required",K2.6 和 K2.7 Code 会拒绝这个值。
默认 max,到底会多花多少钱
只替换模型名而不指定 effort,就等于接受默认 "max"。
K3 始终启用思考,文档称其为 Preserved Thinking。可选的 reasoning_effort 只有 "low"、"high"、"max";"low" 是最接近低成本、低延迟需求的调节项,但它不代表关闭思考。
原文的价格计算有两层前提。输入每百万 token 为 2 美元、输出每百万 token 为 10 美元,来自第三方页面,作者没有从官方文档文本中读到价格表;思考 token 按输出计费的情况,需要结合实际响应的 usage 确认。因此,下面是预算示例,不能当成实测账单。
假设调用 1,000 次,每次输入 8,000 token,可见回答 500 token:
| 每次思考 token | 输入费用 | 可见回答费用 | 思考费用 | 合计 |
|---|---|---|---|---|
| 0 | $16 | $5 | $0 | $21 |
| 6,000 | $16 | $5 | $60 | $81 |
| 20,000 | $16 | $5 | $200 | $221 |
思考达到 6,000 token 时,约占总费用的 74%;达到 20,000 token 时,约占 90%。用户看到的回答一样长,账单却可能差很多。
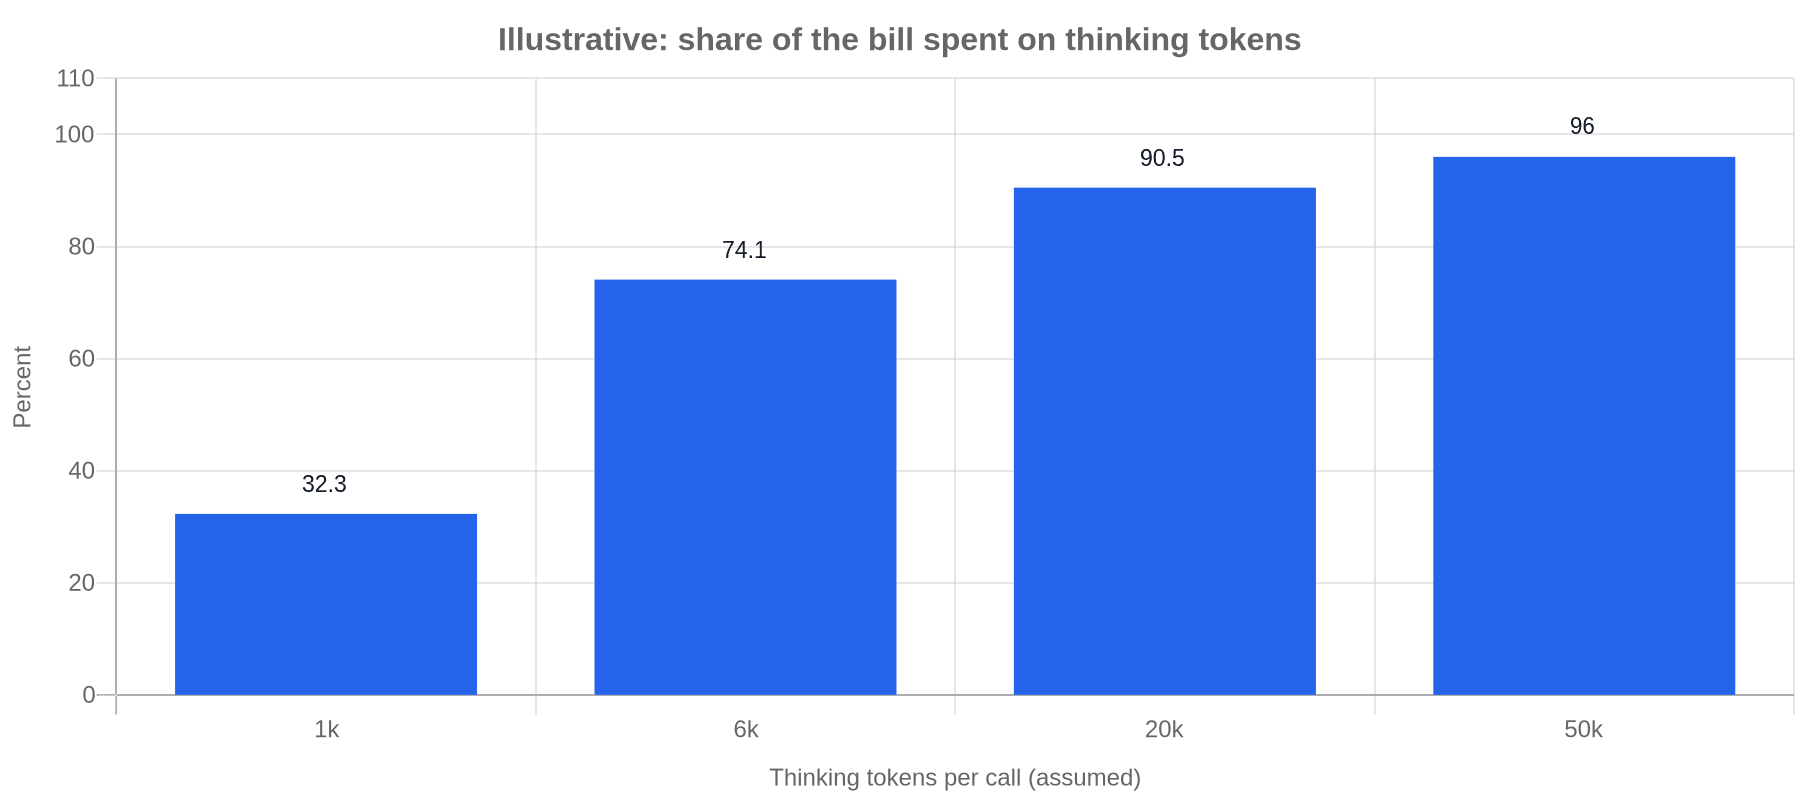
6,000 这个锚点也有边界。AIHubMix 的第三方测试只对一个提示词,在 low 档运行了三次,得到 5,561 至 7,356 个思考 token。它不能代表一般任务,更不能推算 high 和 max 的消耗。原文也没有提供同一业务迁移前后的真实成本对照。
省钱手段还会互相影响。官方说明 kimi-k3.1-pro 和 kimi-k3 支持批量推理,费用为标准价格的 60%,上述 81 美元的离线任务可按此计算为 48.60 美元。
上下文缓存自动启用,默认 TTL 为 5 分钟。按第三方提供的缓存输入每百万 token 0.20 美元计算,若每次输入中有 6,000 token 命中缓存,1,000 次调用的输入费从 16 美元降为 5.20 美元,总费用降为 70.20 美元。
但文档明确提示,切换 effort 会使前缀缓存无法命中。在同一会话里逐轮切换 low 和 max,可能破坏原先的缓存预算。选档策略应该连同缓存一起评估。
迁移测试要回答四个问题
作者建议把同一批固定提示词分别交给旧模型和新模型,检查请求、消耗、质量、延迟。
先覆盖应用实际产生的请求形态,包括带 stop、带 tool_choice、只有 system prompt 的情况,确认返回 HTTP 200。这一步很适合检查 SDK 和公共封装是否偷偷附加了固定参数。
然后按可能使用的 effort 档位记录 token 消耗,再用自己标注的 50 至 200 个案例检查答案质量,同时报告样本数和通过率。对工具调用或提取任务,参数能通过校验只代表接口接通,结果是否满足业务要求还需要单独判断。
延迟同样不能直接采用宣传数字。第三方作者对一个提示词运行三次,测得 highspeed 变体快约 1.6 至 1.75 倍,低于 Moonshot 宣称的 2 至 3 倍;原文引用的价格则是标准版的两倍。这些数据不足以给 highspeed 下结论,却足以提醒团队:要用自己的请求判断加速是否划算。
最后,把模型 ID 和 effort 放进配置,保留同一套回归用例。下一次迁移时,就有可以重复运行的检查依据。
我的判断
我认同原文把默认 effort 当作成本决策来审视。模型接口看起来兼容,不代表旧请求的参数、历史结构和预算假设仍然成立。只盯最终回答长度,也解释不了思考消耗带来的账单变化。
但「K3 会贵多少」目前没有统一答案。价格来自第三方,思考长度只有一个提示词的三次记录,成本表又是作者自行计算。它们能证明费用对思考长度敏感,不能证明你的业务会涨到某个倍数,也不能证明 low 一定够用。这部分是迁移经验和算术分析,缺少业务对照数据。
开放权重也暂时不能当作备用方案。原文称 quickstart 承诺在 11 月 4 日前发布完整权重,模型列表将 kimi-k3 描述为 3T 级开放模型;但作者在 2026-11-01 阅读时,页面仍有 [xx.x%] 这样的基准占位符。承诺发布、实际可下载、团队有资源部署,是不同的条件。
相比直接追随默认配置,我更倾向于先选满足质量要求的 effort,并尽量保持会话内稳定。具体选哪档,仍应由自己的测试决定。
能拿来做什么
- 如果项目用了 K2,先检查 Node 请求封装和 SDK 默认参数,清理固定采样参数与旧
thinking开关,并确认历史保存逻辑保留reasoning_content。 - 从实际业务中整理 50 至 200 个标注案例,分别验证请求能否通过、结果是否合格、token 消耗和延迟,再决定使用哪个 effort。
- 在服务端逐次记录模型 ID、effort 和
usage;能够区分思考与可见输出时,再观察思考占比,避免仅凭回答字数估算成本。 - 将离线任务纳入批量推理评估,将会话 effort 与缓存命中一起测试,并把模型 ID、effort 和价格配置集中管理,方便后续迁移。