GPU 排队时,CPU 分流能否加速推理
作者使用基于 Rust 和 Candle 的 mini-vllm-rs,在 Apple M2 上测试 CPU 与 Metal GPU 的请求分流。量化 Qwen2.5 0.5B 的实验中,选择性分流使八请求突发任务完成时间缩短 9.8%,48 请求的总输出吞吐提升 12.4%。
AI 深度解读
GPU 单独跑得更快,是否就该把所有推理请求都交给它?作者在 Apple M2 上做了一组实验:当请求能复用缓存前缀、GPU 又积压了足够多任务时,让 CPU 接走少量请求,反而能让整批任务更早结束。8 个请求中分走 1 个,完成时间缩短了 9.8%。
这篇值得看的地方,是它把「执行速度」和「排队时间」放在一起算。结果有明确收益,也有前提:小模型、热缓存、固定并发,以及尚未完成的基线验证。
CPU 跑得慢,为什么还值得分任务?
作者用 Rust 基于 Candle 开发了 mini-vllm-rs,这是一个面向 macOS 的单节点 LLM 推理引擎。CPU 与 Metal GPU 可以同时工作,路由器把完整请求分配给其中一个后端。每个后端有独立的调度器和 KV cache,请求选定后端后会一直在那里执行,不涉及中途迁移。
第一轮测试中,最快的路由策略把 12 个请求里的 11 个交给了 GPU。但这只能说明 GPU 应该承担大头,还不能证明「全部交给 GPU」就是最优方案。
突破口在推理的两个阶段。prefill 负责处理输入提示词,decode 负责逐个生成输出 token。作者使用量化的 Qwen2.5 0.5B、F32 激活值,在 Apple M2 上对 512-token 输入、128-token 输出的请求做独立后端分析,发现 CPU 在 prefill 上吃亏更大,在 decode 上的差距相对小些。
因此,长而未缓存的提示词通常值得等 GPU;如果大部分输入已有缓存,CPU 需要补做的 prefill 很少,GPU 的排队成本就可能超过它的速度优势。
决定请求去向的,不只是设备有多快,还有它面前排着多少工作。
第 8 个请求为什么被分给 CPU?
实验先在两个后端分别预热约 512-token 的前缀,再发送相同的 516-token 提示词,每次恰好生成 128 tokens。两个后端各允许最多 4 个活跃请求,请求每隔 50 ms 到达,不等待前一个返回。每种方案都从新服务器和预热缓存开始,运行 3 次。
路由器用下面的公式比较两个后端,把 prefill 和 decode 分开计价:
score = remaining prefill tokens      / prefill rate
      + remaining decode-token budget / decode rate
要留意第二行:它使用剩余生成预算,不预测请求最终会输出多少内容。已有请求按未使用的 max_new_tokens 计算,新请求按完整预算计算。速率又来自后端独立测试,所以这个分数适合比较工作量,不是批处理完成时间的精确预报。
两个后端都报告,新请求可复用 496-token 前缀,因此只剩 20 tokens 需要 prefill。空闲 CPU 的分数始终是:
20/73 + 128/45 = 3.118 秒。
第 7 个请求到达时,GPU 已有 4 个活跃请求和 2 个排队请求。算上新请求,待处理 prefill 是 2 × 20 + 20 = 60 tokens,decode 预算是 256 + 496 + 128 = 880 tokens。GPU 分数为 60/2551 + 880/293 = 3.027 秒,仍低于 CPU。
约 50 ms 后,第 8 个请求到达。第 7 个请求已经入队,活跃请求公布的剩余 decode 预算减少了 8 tokens,但新增队列工作更多。GPU 的 prefill 变为 80 tokens,decode 预算变为 384 + 488 + 128 = 1,000 tokens,分数升到 3.444 秒。CPU 仍是 3.118 秒,于是接走这个请求。
GPU 槽位占满,并不足以触发分流。缓存命中和累计工作量共同决定了边界。
作者还披露了一次修正:AI 在协助整理早期数据时发现,排队请求丢失了缓存折扣,导致 GPU 的 prefill 工作量被高估。修复并重跑后,首次分流从第 7 个请求移到第 8 个。现在队列会保留路由时的缓存估计,但缓存淘汰仍可能让它过时。
整批更快,不代表每项延迟都更好
8 个请求的实验里,3 次运行的平均整批完成时间从 11.47 秒降到 10.35 秒,缩短 9.8%。计时从首次提交开始,不含启动和前缀预热。
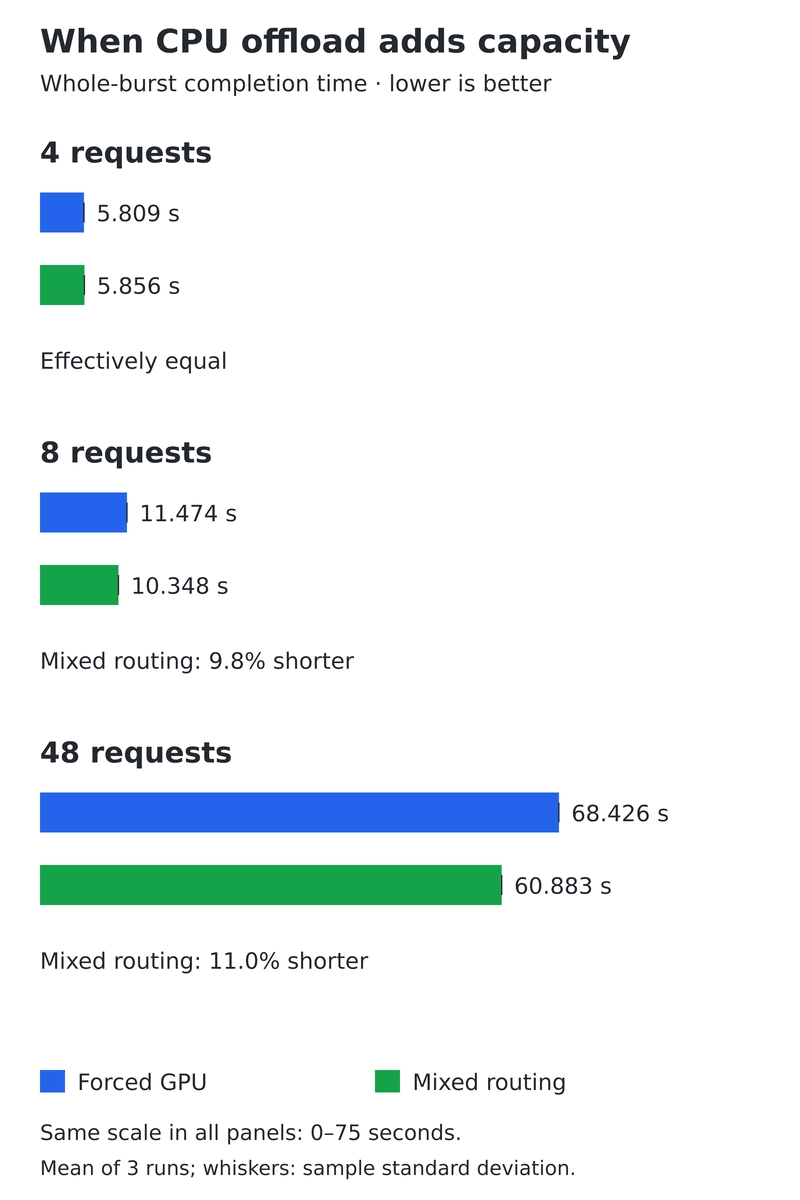
4、8、48 个请求时,CPU 分别接到 0、1、6 个请求。48 个请求的实验中,每次运行都分流了 6 个,平均完成时间从 68.43 秒降到 60.88 秒,总输出吞吐提高 12.4%。
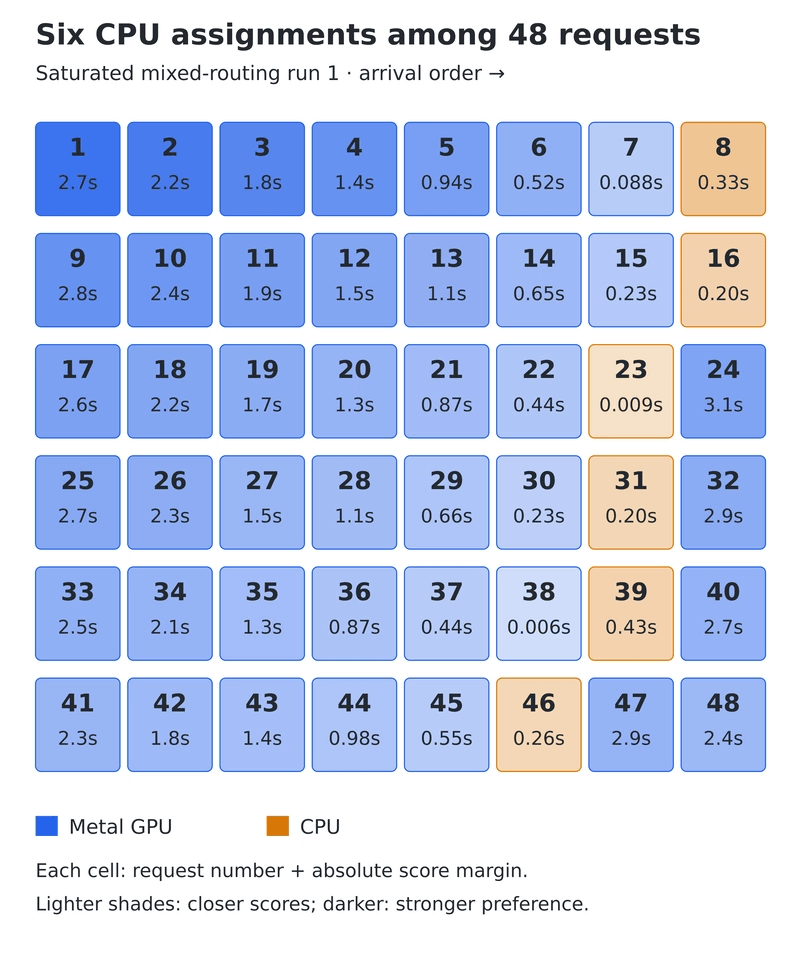
但 8 请求场景的首 token 时间(TTFT)并没有全面改善:中位数下降,p95 却增加了 3.5%。到了 48 请求场景,TTFT 和端到端延迟的中位数、p95 才都改善。
因此,这组结果证明了特定条件下的容量收益,不能承诺每个请求、每项延迟指标都获益。图里的路由估计也不能当作实测延迟。
我的判断
我认可它把阶段成本、缓存命中和排队工作放进同一个决策过程。相比「GPU 满了就交给 CPU」,这种方法能解释为什么第 7 个请求继续等待,第 8 个才分流。
但 9.8% 和 12.4% 都有明确边界。实验只覆盖 Apple M2 上的小模型、相同提示词和固定输出长度,而且两个后端都提前准备好了缓存。换成输入差异大、缓存命中低、输出长度不稳定的业务,分流边界需要重新测量。
另一个关键缺口是 GPU 并发扫描。对照组固定为 4 个活跃请求,作者也明确把调整并发上限列为下一步。现有数据支持混合路由胜过这组固定配置,尚不能证明它胜过调优后的纯 GPU。
输出长度估计同样没做完。原文提到 SGLang 用可调的 new_token_ratio 缩放运行中请求的剩余预算,以估算未来 KV-cache 需求;这也是启发式方法,并非准确预测。更复杂的调度器是否值得引入,还要看持续到达流量、不同缓存命中率下能否保住收益。
能拿来做什么
- 如果你在 Node 服务后接本地推理引擎,可以先记录队列长度、剩余生成预算和缓存命中量,再判断是否需要 CPU 分流;单看 GPU 是否繁忙,信息不够。
- 如果日常 AI 编程请求反复携带相同系统提示或项目上下文,可以测量前缀复用后的成本,同时确认不同后端是否各自拥有有效缓存。
- 比较调度方案时,先调整纯 GPU 的并发上限,再同时观察整批完成时间、吞吐、TTFT 和端到端延迟的中位数及 p95。
- 实现工作量评分时,要让排队请求保留缓存估计,并考虑缓存淘汰后的失效处理;作者修复的计账错误已经足以改变分流时机。