438 次测试探查编码智能体指南的作用
作者通过 438 次测试比较有无指南及不同放置方式的效果,研究哪些说明会改变编码智能体行为。已披露结果中,重复官方文档的指南在 32 次运行里未带来提升,项目特有信息则更有必要写入指南。
完整中文译文
CLAUDE.md、AGENTS.md 和各种 skill,到底是在帮 AI 写代码,还是只让它多读一份说明书?作者围绕这个问题做了 438 次运行,得到的结论很明确:指南的价值,取决于它补上了什么信息,而不是写得多完整、语气多强硬。
最有用的是官方文档没写的事实、难以推导的修复办法,以及 agent 会漏掉的检查。重复文档通常没有收益,写得过于绝对还可能带偏模型。不过,这组实验更适合用来调整团队的知识记录方式,不能直接当成模型排名。
指南有没有用,要看它补的是哪块缺口
原文提到,Opus 5 发布时,Anthropic 删掉了 Claude Code 超过 80% 的系统提示词,其编程评测没有下降。Claude Code 创建者 Boris Cherny 也建议,每隔六个月删掉 CLAUDE.md、skills 和 hooks,看看模型自己能做到什么。
这些说法引出了作者的疑问:模型会自己查文档,团队还应该写什么?
作者从自己运营的 worklore 案例库里选出 17 篇故事,其中 14 篇由自己撰写,3 篇来自另一位作者。每篇包含踩坑过程、解决办法和 Verify 验证要求。他为案例搭建小仓库,植入问题,再用一句话任务驱动 agent。隐藏脚本根据仓库、diff 和命令日志评分,不采信 agent 自报的完成情况。
实验覆盖 9 种配置:Claude Code 的 Opus、Sonnet、Haiku 5.5;Codex CLI 的 GPT-6-Sol,使用两档推理级别;Antigravity 的 Gemini 4 Argon,使用两档级别,以及 Gemini 3.8 Flash、GPT-OSS 120B。
第一轮五项任务,没有得出统一的「指南有效」结论。MCP 测试受益,时区修复却被指南带偏:所有 agent 原本都能修好,加入指南后,三个 agent 按字面理解其中一句话,破坏了正常 API。其余任务大体只是答案变长、格式更像指南,营销计划甚至略差。
指南应该补充模型拿不到的上下文,而不是展示团队写了多少规范。
哪些内容能把失败变成通过
第二轮按指南携带的信息分成六类,每类测试两个案例。每类第一个案例覆盖全部 9 种配置,第二个因额度限制覆盖 7 种。
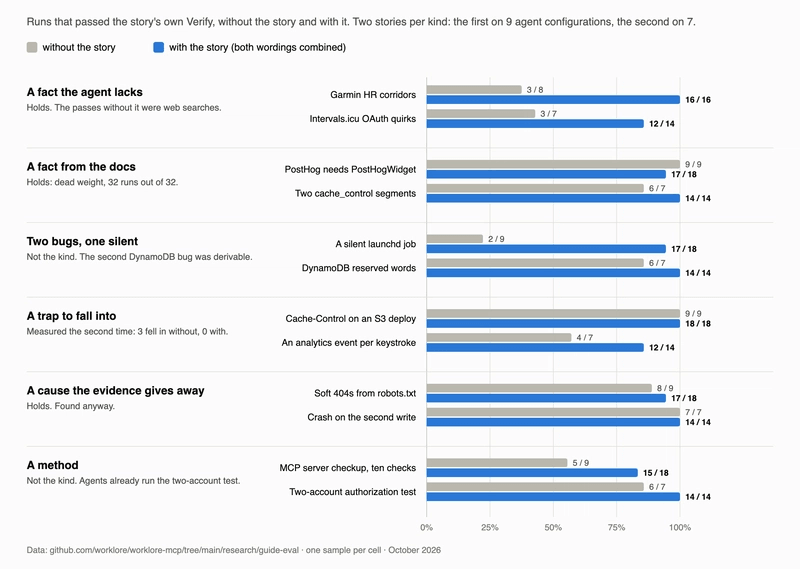
第一类是官方文档缺失的事实。Garmin 手表要求心率区间采用特定格式,文档没有写清。没有案例时,8 次运行只有 3 次成功,都依赖网页搜索;两次 Gemini 运行把整整 20 分钟花在尝试格式上。提供案例后,16 次全部通过。OAuth 提供商的三个未记录细节也有类似表现,但其中两个能在论坛找到,搜索能力强的 agent 仍可能自行解决。
第二类是文档已经说明的知识。PostHog 的 Flutter replay 需要用特定 widget 包裹应用,Anthropic 的 prompt caching 如何处理内存写入,这些信息模型都能获得。相关 32 次运行,有无指南没有区别。
第三类是能诊断、却不知道如何修复的问题。某个夜间任务调用 CLI 时报告「Not logged in」,原因是 launchd plist 的环境变量缺少 USER。9 个 agent 中有 7 个找到原因,却表示无法在当前环境修复。案例明确给出办法:把 USER 加入 plist 的 EnvironmentVariables。有指南的 18 次运行中,17 次完成修复。
这里缺的不是更多推理,而是一条具体操作知识。另一则 DynamoDB 保留字案例没有复制这种提升,因为 agent 能从日志推导修复办法。
第四类是容易踩中的陷阱。一个会把网页作为下载文件返回的命令,在 35 次运行中无人使用,指南自然没有发挥空间。另一个陷阱则放在很自然的位置:每次按键都发送 analytics 事件。没有案例时,7 次中有 3 次踩坑;提供案例后,14 次全部避开。
剩下两类也指向同一规律。robots.txt 导致的 soft 404、DynamoDB 第二次写入崩溃,如果日志已暴露原因,指南主要增加解释精度。十步 MCP 检查则补上了 agent 常漏的一项:输出 schema 能否拒绝错误答案。两账号授权测试没有明显收益,因为 7 个 agent 中已有 6 个会主动执行。
写成同事案例,为什么可能比强制命令更稳
作者把一半指南以「Follow this guide:」交给 agent,另一半则说明:这是一位同事处理类似问题的记录,请采用适用部分,忽略其余内容,并报告哪些部分适用。
案例措辞没有更差。在第一组比较中,它对六项任务中的三项更好,第二组则打平。连十步检查表也没有因强制遵循而占优:一个 agent 被清单占据注意力后,漏掉了无指南时原本会做的检查。
OAuth 案例更直观。要求遵循指南时,7 次运行全部重写了案例描述的 token exchange;采用同事笔记措辞时,只有 3 次重写,其中一个明确表示,日志没有指向交换流程,所以保留现状。
这让指南承担了更合适的角色:提供线索,再由当前证据决定是否采用。
作者还测试了第四种交付方式:把案例放进仓库的 notes 文件夹,旁边放两篇无关故事,任务完全不提它。
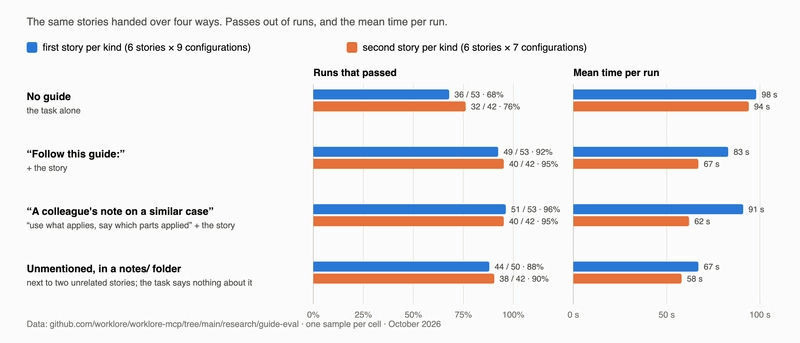
91 次运行中,84 次打开了笔记,没打开的全部来自 GPT-OSS。读到笔记后,通过表现接近直接放进提示词,而且该组平均最快,因为找到答案后就停止搜索。不过,没有 agent 在采用前质疑笔记或核查其说法。
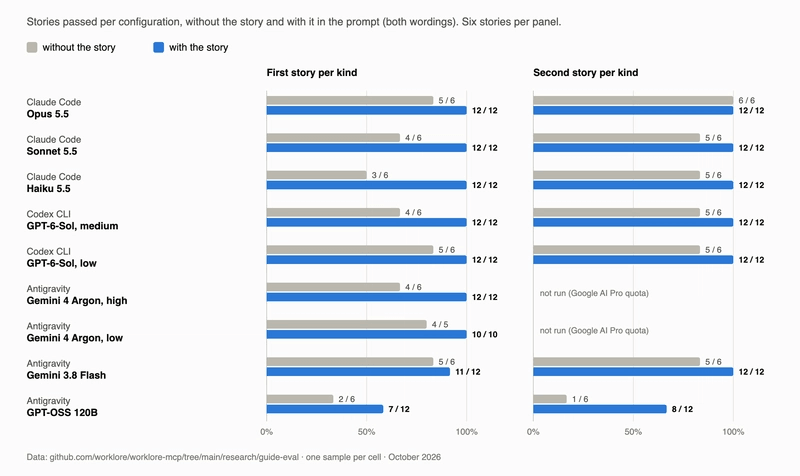
补充案例后,Claude、Codex 和 Gemini 的各配置全部通过,或只差一次;Codex 的 low reasoning 在这些任务中处处追平 medium。Haiku 加笔记,也追平了没有笔记的 Opus。GPT-OSS 120B 是例外,作者观察到它主要卡在工具使用上。
我的判断
这组实验最有价值的地方,是把「写更多规则」转成了「记录哪些信息能改变结果」。对团队而言,配置里的特殊键、第三方接口的隐含格式、一次事故暴露的漏检步骤,都比重复官方教程更值得保存。
但「小模型加指南追平大模型」有很强的前提:仓库小、每个任务只有一个预设问题,指南恰好携带关键答案。它不能证明小模型在复杂重构、多故障排查和长期开发里也能替代大模型。作者也没有给出足够的 token 与费用对照,不能据此计算能省多少钱。
实验每个单元只跑一次,所谓单元,就是一个案例、一种配置和一种交付方式。部分计数把两种有指南措辞合并,因此分母会从无指南的 8 变成有指南的 16。这些是有启发的观察,作者自己也称其为强烈的个案证据,而非基准测试。
17 篇案例中有 14 篇出自作者,格式也相同;agent 没有记忆、MCP servers 或全局指令文件,但可以联网。复杂团队环境能否复现,仍需另测。worklore 据此调整了新提示词,不过新版本尚未经过实验验证。
相比把所有经验写成必须执行的规则,我更认同「案例加适用条件加 Verify」。但案例语气也不能保证内容正确。所有 agent 都未核实仓库笔记,就直接使用,这同时说明了知识可发现性和过时知识的风险。
能拿来做什么
- 清理 CLAUDE.md 或 AGENTS.md 时,优先保留项目独有的坑、准确配置和接口细节;对于官方文档已有的内容,先测试删去后是否影响结果。
- 给前端埋点案例写清触发条件、曾经的失败方式和验证办法,例如检查是否每次按键都上报,让 agent 能判断当前实现是否命中同类问题。
- 在 MCP 工具或接口的 Verify 中加入实质检查,例如输出 schema 能否拒绝错误结果;提到扫描器时,也写清它看不到什么,避免工具结论替代代码检查。
- 发布 SKILL.md 或新增团队指南前,用同一任务分别跑一次有指南和无指南版本,并按相同 Verify 判断。结果一致时,继续检查它是否只增加篇幅;结果变差时,优先排查绝对化措辞和过时步骤。