ViBench 2.0测试Agent从零构建产品
Replit发布ViBench 2.0,让Agent从空项目开始逐步实现完整产品,覆盖17种产品、241项功能请求和544份测试计划。表现最好的模型也仅有49%至65%的构建能通过全部测试计划。
AI 深度解读
AI 能从空项目搭出一个像样的应用,已经不算稀奇。真正难的是:连续加十几个需求后,旧功能还能不能正常工作?Replit 发布的 ViBench 2.0 就在测这件事。它让模型逐步构建完整产品,最强模型也只有 49%~65% 的构建能通过全部测试。
这份评测值得看,不只是因为模型排名。它把 AI 编程中容易被演示页面掩盖的问题摆了出来:数据库能否从零启动、多人操作是否互相覆盖,以及新功能会不会破坏旧规则。
为什么要让模型接着自己的代码往下写
多数编码评测,例如原文提到的 DeepSWE,会在已有代码库中交给 Agent 一个明确任务。ViBench 2.0 则从空项目开始,让模型先根据简短规格搭出第一版,再追加最多 18 个功能。
这里的难点是,模型选择数据库结构和路由时,并不知道后续需求。早期图省事的设计,可能在后面变成障碍。
ViBench 1.0 已经观察到,模型在自己生成的代码上继续加功能,得分反而下降,论文把这种场景称为 Vibe-on-Vibe。2.0 把它延长成一段产品演进过程,产品参照 Uber、GitHub、Google Docs 等真实软件设计。
评测共有 17 个产品、241 条功能请求、544 份测试计划。其中 8 个产品以 Harbor 格式公开,另外 9 个保留。作者称,使用 v2.0.6 发布版本,可以通过一条命令复跑结果,但正文没有给出具体命令。
这些测试不只检查按钮能不能点,还检查业务规则是否一直成立:
- 构建必须能在空数据库启动,不能依赖开发过程中留下的数据。
- 社区聊天中的用户改名后,历史消息里对他的提及也要更新。
- 网约车分摊金额必须精确到分,总和始终等于车费。
- 代码托管产品中的旧编辑器不能覆盖别人刚保存的新内容。
- 商城里的两个退货表单不能对同一件商品重复退款。
能把功能分别做出来,和能让这些功能长期共存,是两种能力。
90% 的测试通过,为什么整次构建仍然失败
ViBench 2.0 的功能请求描述用户期待的行为,不指定实现。全部功能完成后,再由评分 Agent 在真实浏览器中点击、输入并验证结果。
设计工具的撤销功能很有代表性:每个人只能撤销自己的修改,不能撤销协作者的操作;产生新修改后,重做历史必须清空。
下面这段原始测试通过 Alice 和 Bob 交替编辑同一个矩形,检查撤销是否误伤别人:
1. Alice: create rectangle "R" at (100,100), 100x100, fill #CCCCCC.
2. Alice: move R to (300,100).
3. Bob: rename R to "Rocket".
4. Alice: change R's fill to #00AA00.
5. Bob: set R's opacity to 50%.
6. Alice: Undo. Read R on both screens.
...
Verify:
- After 6, R's fill is #CCCCCC while its name is still "Rocket", its opacity still 50% and its position still (300,100).
关键在最后一行:撤销只能恢复 Alice 改过的填充色,必须保留 Bob 设置的名称和透明度,以及 Alice 此前移动的位置。简单地恢复整个对象快照,就可能把别人的修改一起抹掉。
后续步骤还检查移动、取消分组和删除后的行为。GPT-6.1 Sol、GPT-6 Astra、Opus 5.5 的 12 次构建中,有 8 次没通过这份计划。
评测用两个指标区分「大部分可用」与「全部过关」:Plan pass rate 是按产品平均的测试计划通过比例;Pass@1 是所有测试计划都通过的构建比例。一个计划也要全部步骤成功才算通过。
因此,三个领先模型的测试计划通过率都超过 90%,整次构建通过率却只有 49%~65%。失败常常只差少数计划,但差的恰好是实际用户会遇到的地方:草稿 PR 不展示合并冲突、表格单元格里的词无法评论、没有角色的服务器所有者无法管理成员。
约每 40 次领先模型的构建,就有一次无法在空数据库启动,原因是后加的 schema 代码先引用了尚未创建的表。更普遍的故障出现在功能交汇处:领先模型失败的构建中,接近四分之三只在这些交汇处出错。
模型排名要连同成本、速度和测试范围一起看
正式结果来自 Fireworks:每个模型对 17 个产品分别构建 4 次,统一使用基于 OpenHands 的 Agent 执行框架,推理强度为 medium,temperature 为 1.0,并采用相同限制。
| 模型 | Pass@1 | 单次构建成本 |
|---|---|---|
| GPT-6.1 Sol | 65% | 约 $12 |
| GPT-6 Astra | 60% | 约 $90 |
| Opus 5.5 | 49% | 正文未给出 |
| DeepSeek V4.1 Flash | 未通过完整构建 | 约 $2.50 |
DeepSeek V4.1 Flash 的测试计划通过率为 77%,但本轮没有开权重模型完成一次全部过关的构建。便宜且能完成多数功能,仍不能直接等同于完整交付。
速度也影响选择。Opus 5.5 平均约 70 分钟完成一次构建,速度约为 Sol 的 2.5 倍;它只少生成约 6% 的 token,作者据此判断,时间差主要来自 API 服务商的速度。这里的成本按模型公开标价计算,构建时间则是从第一版到最后一个功能完成的墙钟时间。
作者还单独在 8 个公开产品上比较了 GPT 代际表现,每个产品同样构建 4 次:
- GPT-5.4 的 Pass@1 为 0%,GPT-6 Sol 为 31%,GPT-6.1 Sol 为 53%。
- 测试计划通过率从 GPT-5.4 的 42% 提升至 GPT-6.1 Sol 的 95%。
- GPT-6.1 Terra 的 Pass@1 为 47%,成本约为 GPT-6.1 Sol 的一半。
这组结果不能与正式榜单直接混用。公开产品上的 Sol 得分是 53%,全部 17 个产品上是 65%;其中 Sol 使用 Fireworks 的正式运行结果,其他 GPT 模型由作者团队运行。图中的区间为 95% 区间,使用 vibench score 计算,接近 0% 时采用精确二项区间。
外观则是另一条轴。下面两张是相同设计工具、加载相同数据后的构建截图,来自作者团队自己的运行:
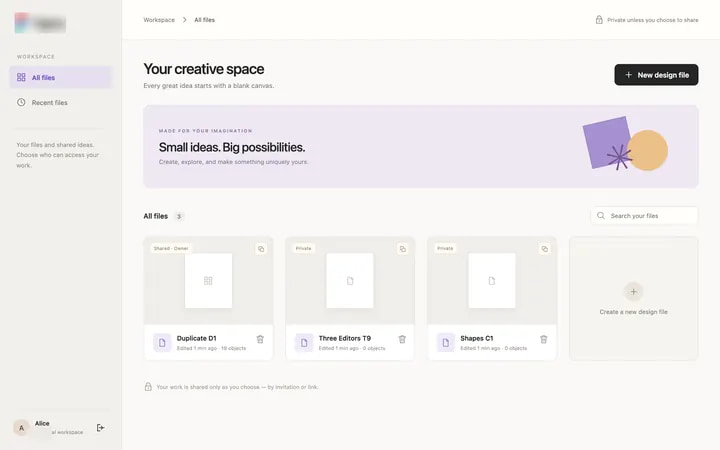
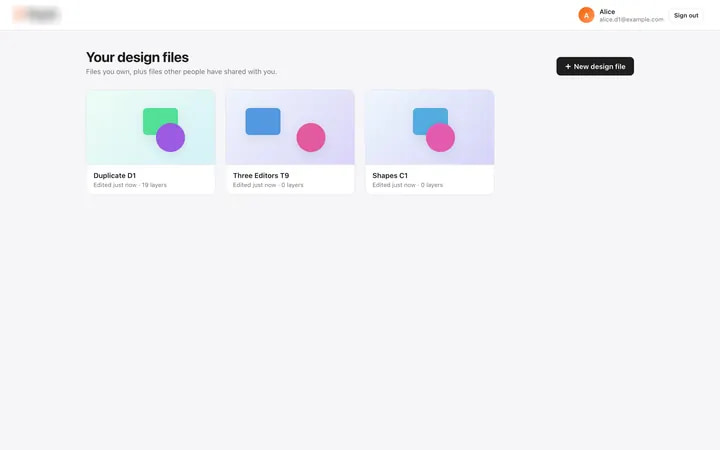
作者观察到,GPT 更喜欢插画和大标题,Claude 更倾向朴素、接近参照产品的界面。Sonnet 5.5 在代码托管产品的 4 次构建中有 3 次选择深色主题,在其他展示产品中没有选择。ViBench 不给设计打分,作者也没有发现好看的构建更容易通过测试;这部分属于观察,没有给出相关性的统计对照。
我的判断
我认同这份评测把重点放在连续迭代和功能交互上。对前端、全栈开发来说,撤销、权限、并发和数据迁移往往比首屏是否完整,更接近交付难度。
评分方式也做了一些验证。作者选择 Opus 5.5,是因为它在被测评分模型中犯错最少。他们向正常构建逐个植入 34 个缺陷,缺陷可见时,评分器没有错误放行;GPT-6.1 Sol 复核了 Opus 判定通过的 477 份计划,确认其中 99.2% 正确。作者还称,没有看到评分器偏向 Claude 构建的迹象。
这些证据能增强可信度,但还不能覆盖所有误判。植入缺陷验证的是特定可见错误,复核通过项也无法回答评分器错杀了多少正确实现。完整方法说明在原文发布时仍待公布。
模型排名同样有边界:每个产品只跑 4 次,且全部模型共用一个框架。为其他执行环境优化的模型,可能在这里吃亏。模型始终不知道后续需求,也比不少真实团队的产品规划更苛刻。
我更愿意把这份榜单当成特定条件下的交付能力测试,而不是采购模型的唯一依据。
作者预测这类成绩会逐渐出现在更便宜、包括开权重的模型上。目前这是趋势判断,文中没有提供足够数据来保证它何时发生。
能拿来做什么
- 给 AI 编程任务补上「从空环境启动」验收。前端加 Node 服务的项目,至少检查空数据库建表、初始化和启动流程,避免本地遗留状态掩盖问题。
- 把验收条件写成多人操作序列。涉及协作编辑、权限或退款时,明确谁先操作、谁后操作,以及最终哪些数据必须保留,比只写「支持撤销」更有约束力。
- 每次追加功能后,回归它与旧功能的交汇处。新增评论,就检查表格内文本;新增角色,就检查无角色的所有者权限,不要只验收新增入口。
- 比较模型时同时记录完整任务成功率、费用和耗时。若任务允许人工收尾,测试计划通过率有参考价值;若要求自动交付,就必须另外看全部验收通过的比例。