Gemini 4 Carbon发布,首批限安全专家
Google DeepMind在Argon发布两周后推出Gemini 4 Carbon,以59分登顶Artificial Analysis Intelligence Index v5。Google称其面向长程Agent工作流和网络防御全流程,初期仅向选定安全专家开放。
AI 深度解读
Gemini 4 Argon 发布仅两周,Google DeepMind 又推出了 Carbon。按原文给出的评测,它的综合能力、长任务执行和安全能力都有提升,价格则维持不变。但综合榜第一,并不等于写代码最好,也不代表普通开发者已经能用上。
对前端和全栈开发者,这条消息值得看的不是迭代速度,而是三个问题:模型能否连续处理复杂工程任务,能力提升有没有换来更高的时间成本,以及这些成绩究竟经过了谁的验证。
综合第一,为什么还不能直接认定编程最强
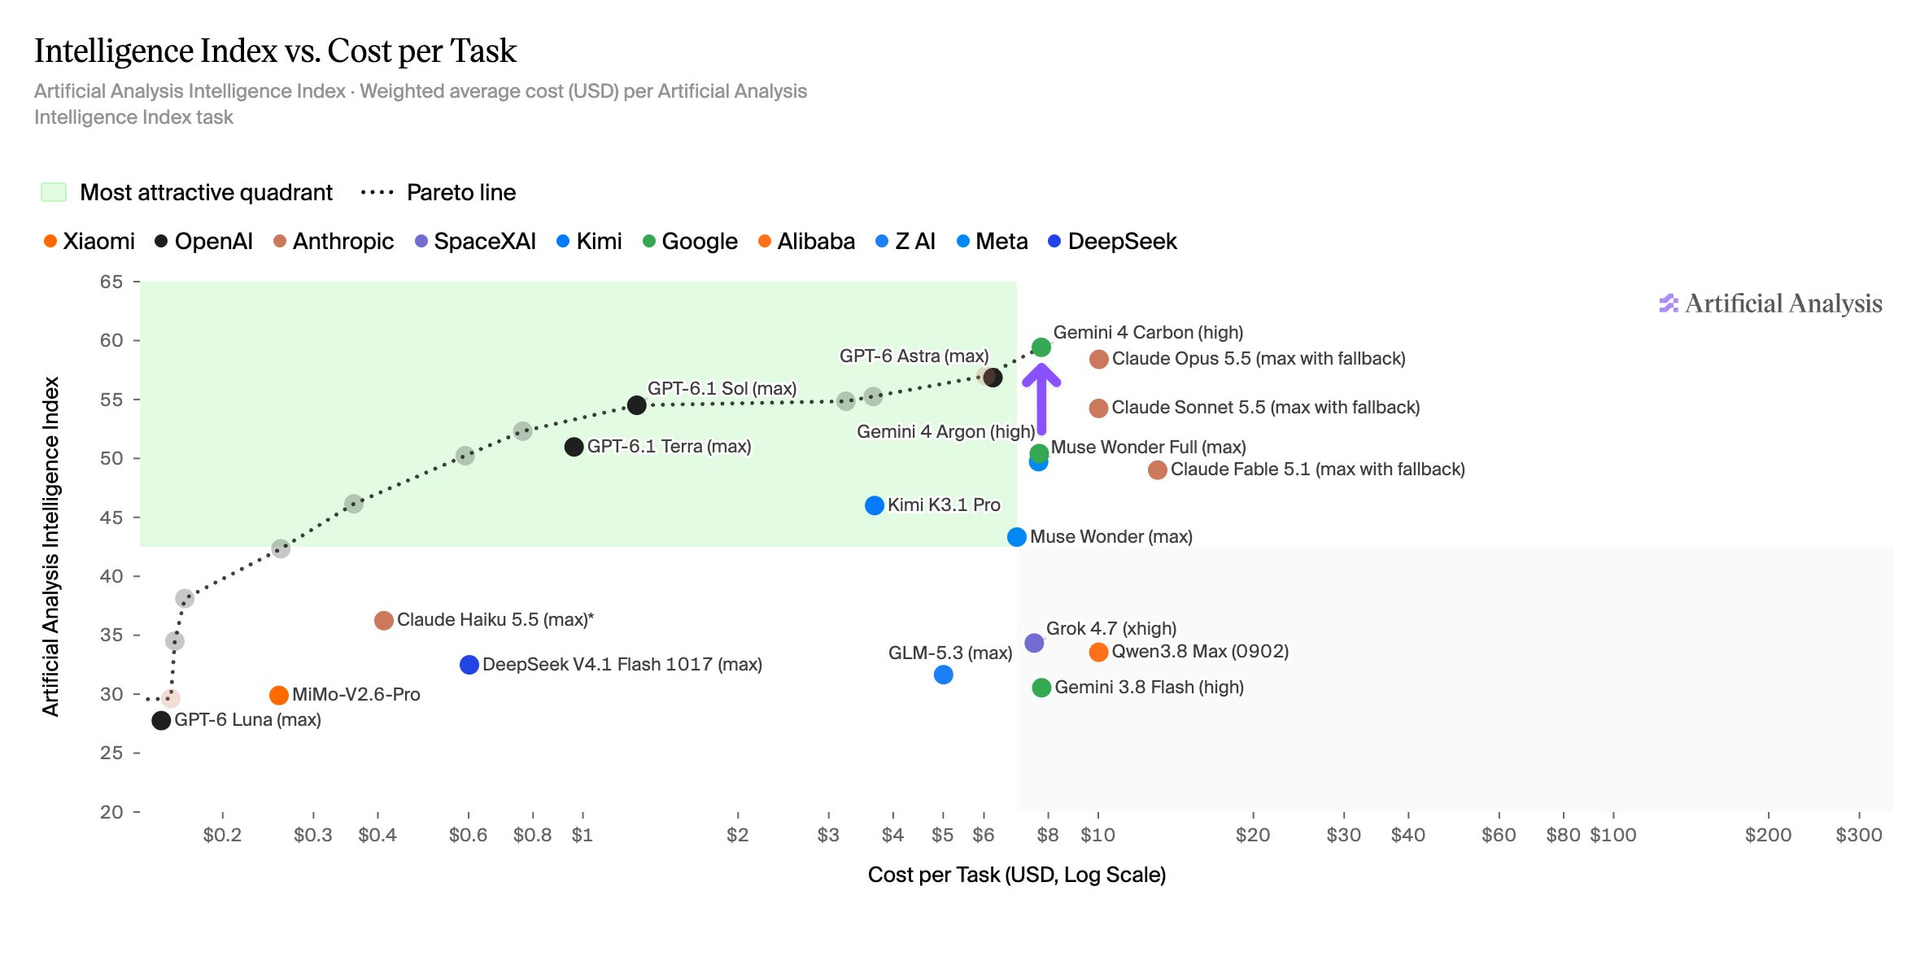
Carbon 在 Artificial Analysis Intelligence Index v5,也就是新版 5.0 综合指数中拿到 59 分,高于 Argon 的 50 分。但综合指数包含推理、知识检索和科学任务,不能直接当作编程成绩。
Artificial Analysis 的独立评测显示,Carbon 在最高推理档位 high 下,拿下九项子评测中的四项第一。到了智能体编程,运行在 Antigravity 中的 Carbon 得到 59 分,仍低于 Claude Code 搭配 Claude Opus 5.5 的 62 分。这里比较的是模型与工具环境组成的系统,结果也会受工具调用、上下文管理和执行流程影响。
原文有一处口径不一致:开头把 Argon 的 Coding Agent Index 写成 50 分,后文却说编程成绩从 53 分升到 59 分,没有解释差异。
综合榜领先,可以证明能力覆盖面更强,不能替代你自己的工程验收。
Google 对 Carbon 的定位是持续多天的自主开发。按其说法,内部团队让模型连续运行数天,模型能够自行走出失败路径,完成大型代码库和底层软件中的根因分析、隐蔽缺陷修复。这比一次生成多少代码更接近真实工程,但原文没有给出任务清单、成功率和人工介入次数,暂时只能视为厂商报告。
Web 开发的提升也比较明确:Carbon 比 Argon 高出 89 Elo,排名第四。不过原文前后分别写了 1,769 和 1,768 分;后一个口径下,它仅落后 Claude Sonnet 5.5(xHigh,1,770 分)两分,Argon 则排第十一。这个小差距不足以单独决定选型。
单价没涨,完成任务却未必更快
Carbon 的首发价格与 Argon 相同:每百万 input tokens 为 $2,output tokens 为 $10,缓存输入优惠 95%。但 Artificial Analysis 的成本计算采用常规标价,即输入 $4、输出 $20、缓存输入 $0.20,没有计入持续到 2026 年底的 50% 首发折扣。
按这一评测口径,Carbon 每任务成本为 $7.76,接近 Argon 的 $7.68,比 Claude Opus 5.5(max)的 $10.04 低约 23%,约为 GPT-6 Astra(max,$6.25)的 1.2 倍。Carbon 平均每任务输出 123,000 tokens,比 Opus 的 173,000 少 29%。
另一套 Vals Index v2.2 中,Carbon 以 70.36% 准确率排第二,位于 Claude Sonnet 5.5 的 70.85% 和 Claude Opus 5.5 的 70.18% 之间,Argon 为 69.24%。Carbon 每次测试花费 $10.51,运行不足 48 分钟,比这两个 Anthropic 模型便宜且快。
但与 Argon 相比,部分任务明显变慢。Finance 和 Tax Agent 任务耗时超过两倍,Legal Research 平均每任务超过 50 分钟。Carbon 生成的推理 tokens 是 Argon 的 2.3 倍,输出 tokens 多 64%;法律研究引用来源约多 45%,工具调用也更频繁。它的输出量仍不到 Sonnet 5.5 和 Opus 5.5 的一半。
因此,「更快」必须说明和谁比、做什么任务。Carbon 在 Vals 的 Finance Index 和 Legal Research 中领先,背后也可能伴随更长的搜索与推理过程。
Arena.ai 提供了另一种观察:超过 21,900 次真实会话中,Carbon 在 Agent Arena 排第二,净改善指标为 +16.2%,可引导性指标最高,为 +18.6%;任务成本中位数 $1.80,比第一名 Opus 5.5(Max)低 72%。这些结果支持它有成本竞争力,却不能和其他平台的每任务费用直接混算。
安全能力进步很大,开放范围却仍有限
Google 自选的 16 项测试中,Carbon 拿下 15 项第一,长上下文和安全任务尤其突出。
安全评测覆盖发现漏洞、生成可用利用程序和编写修复补丁:SEC-bench Pro 为 88.2%,CWE-Bench 为 71.0%,ExploitGym 在十小时运行条件下达到 54.8%。按原文,这些成绩领先被测的 GPT-6 Astra 和 Argon。
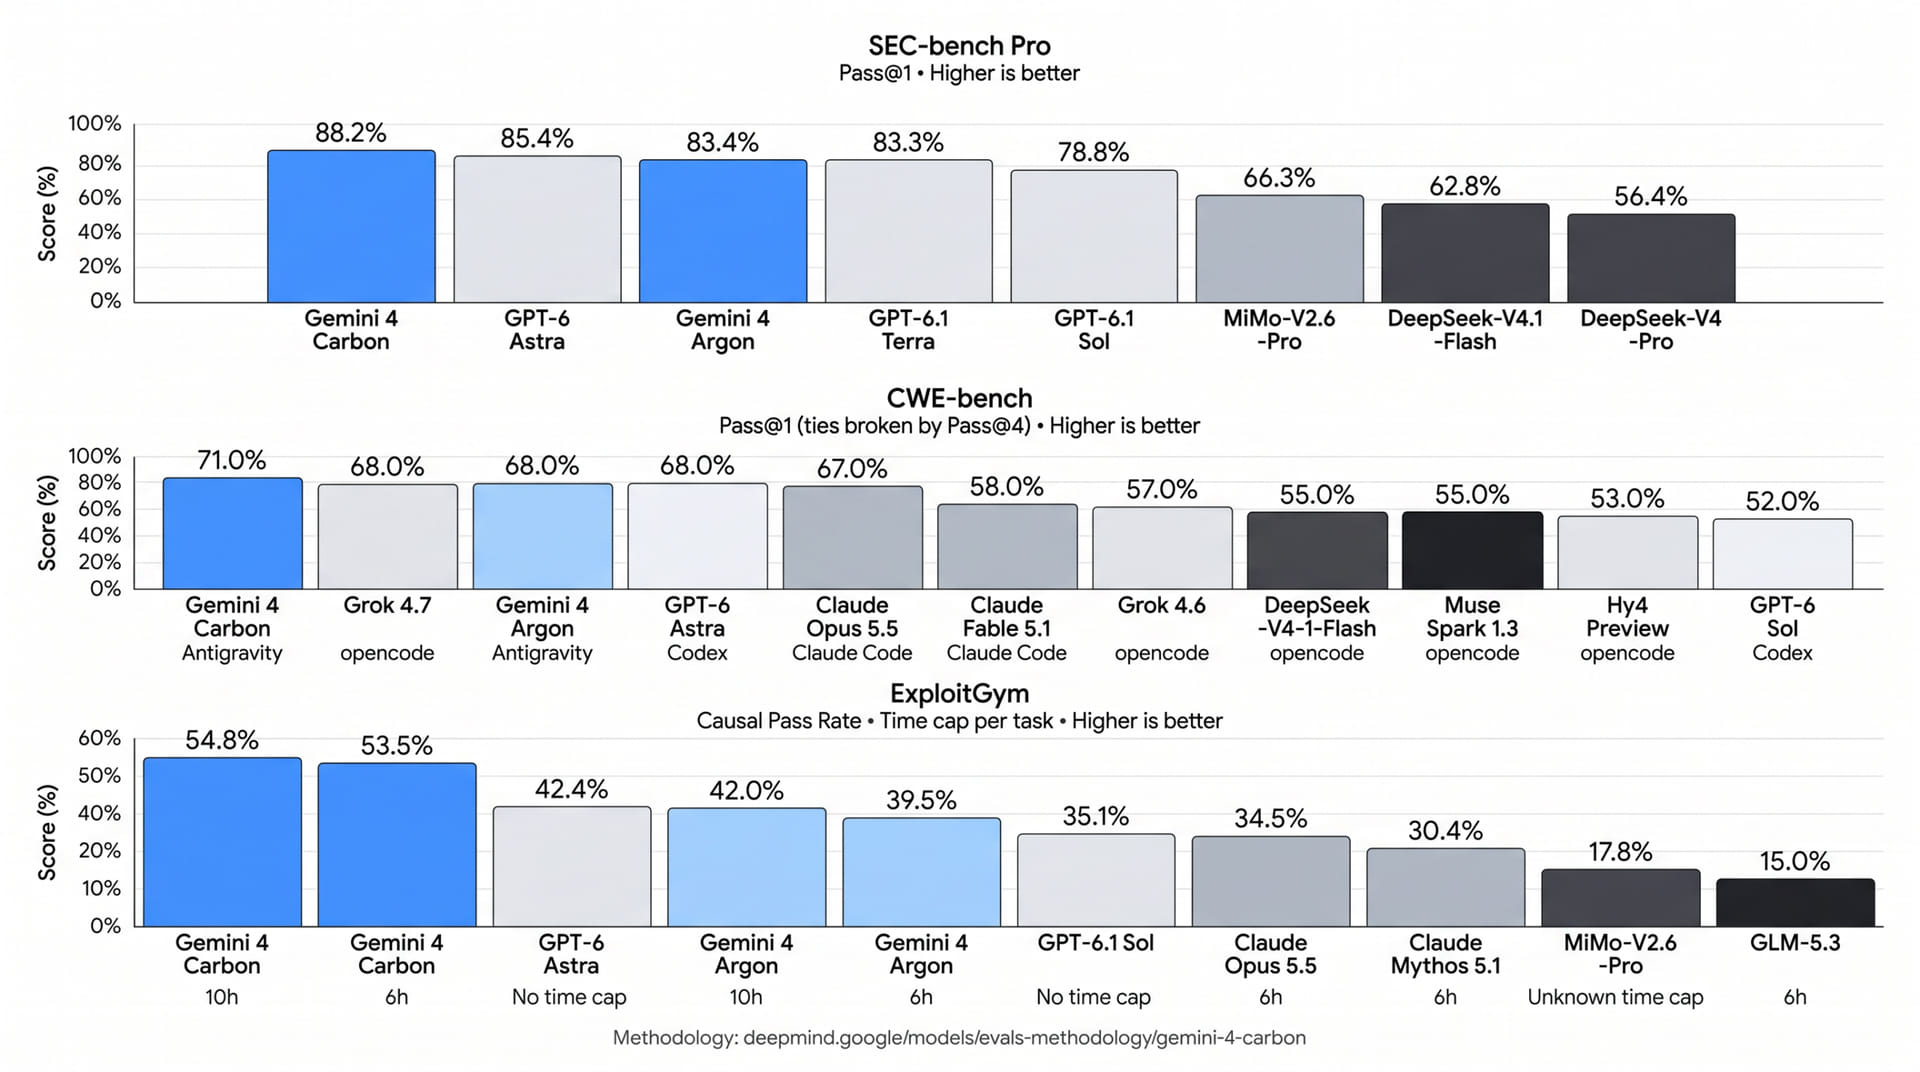
关键前提是,Google 在若干安全测试中移除了安全护栏。这有助于测试能力上限,但不代表正式开放版本会执行同样的操作,也不能据此推断日常开发中的安全效果。
Google 还给出两组内部结果:生成安全代码的频率超过 Argon 两倍;Chrome 团队测试中,编写安全补丁的表现超过某个未具名竞品前沿模型十倍。由于缺少公开任务和可复核过程,这些数字无法独立验证。
间接提示注入方面,Gray Swan 测试中的攻击成功率从 Argon 的 0.7% 降到 0.0%。间接提示注入就是把恶意指令藏进模型读取的网页、文件或工具结果,让它偏离原任务。0.0% 说明这一批测试没有攻击成功,不代表所有攻击都被解决,也可能说明测试集已经难以区分更强的防御能力。
Carbon 因此采取分阶段开放:参与美国政府的自愿发布前测试,报道所称的「本周」先向选定安全专家提供访问,再通过 Fairwind Program 扩展给可信伙伴。面向开发者、企业和消费者的开放,还要等待反馈与护栏调整。原文没有给出具体日期,也没有提供 API 接入方式。
我的判断
Carbon 最有说服力的地方,是多个外部平台都观察到了提升,而不是只有 Google 自选测试表现好。但「全面进步」需要拆开理解:编程仍落后 Opus 5.5,Web 开发排第四,AA-Briefcase 知识工作也没有登顶。
在 AA-Briefcase 中,Carbon 从 Argon 的 1,483 Elo 升至 1,609,增加 126;展示质量增加 293 至 1,598,分析质量增加 120 至 1,671。它仍落后 Kimi K3.1 Pro(1,678)、Muse Wonder(max,1,659)和 Grok 4.7(xhigh,1,638)。提升幅度和最终名次,是两回事。
另一个不能忽略的变化是:答案准确率从 48% 升到 58%,幻觉率也从 4% 升到 11%。后者虽然仍是该榜第二低,低于 Claude Opus 5.5(max)和 GPT-6 Astra(max)各自的 50%,却说明能力增强没有自动消除错误输出。原文没有充分解释这些指标的统计口径,不能把 11% 当成任意业务中的出错概率。
我会把 Carbon 视为值得进入候选名单的模型,而不是可以省掉评审的工程代理。
和继续使用现有模型相比,切换是否划算,取决于任务成功率、等待时间和人工返工量。原文没有普通团队的完整迁移对照;多天自主开发是否能稳定减少人工投入,目前仍缺少证据。
能拿来做什么
- 等 Carbon 获得可用访问后,用真实仓库里的根因定位、跨文件缺陷修复和全栈功能任务做对照,统一工具权限与验收标准,再判断是否替换现有模型。
- 前端团队评估 Web 开发能力时,把页面效果、交互正确性和代码可维护性一起验收。WebDev Arena 第四名可以作为试用理由,不能替代项目要求。
- 为长任务记录总 tokens、总耗时、重试次数和人工修改量,并区分首发价与常规价。每百万 tokens 的价格相同,不保证每次需求的交付成本相同。
- 涉及依赖漏洞或安全补丁时,用测试和代码审查验证模型输出;处理网页、文件与工具结果时,继续保留权限边界,不能因为某项提示注入测试达到 0.0% 就放开限制。