单图生成热门短视频的工程流水线
作者拆解从热点配置、链接解析到视频模板、额度预留、轮询、竖屏重构和失败处理的完整流程。热点内容通过 TypeScript 配置接受代码审查,页面发布同时受配置与数据库状态控制。
AI 深度解读
把 TikTok 热门视频做成「上传一张照片就能复刻」的模板,难点远不止写提示词。作者搭建的流水线覆盖了趋势上架、链接识别、视频生成、积分预留、轮询、画幅处理和失败退款,许多细节都来自上线后的真实故障。
这篇值得看的地方,是它把 AI 产品拆成了普通程序员能处理的工程问题:哪些输入先校验,哪些操作只能执行一次,失败后用户该改什么。但它提供的是一套实践记录,没有生成成功率、成本或转化率的对照数据。
趋势内容放代码里,上下架交给数据库
TikTok 趋势几天就可能换一轮,产品必须赶在热度上升时上线。作者最初把趋势全放数据库,后来发现,每页都需要人工核对参考视频、剧情发生的秒数、用户实际模仿的版本。这些内容更适合用 TypeScript 对象维护,通过代码差异审查。
页面公开有两个条件:配置存在于 TREND_PAGES,数据库记录的 page_status 等于 published。状态还包括 none、draft、held,分别表示没有页面代码、等待审核、暂不上线。草稿只向管理员展示,并带 noindex 和草稿提示,其他人访问得到 404。
首页卡片另用 wall_status,取值为 pending、approved、hidden,因此可以先展示趋势卡片,再补完整页面。
他们还把选材门槛写进检查脚本:站内展示的 TikTok 帖子至少有 200,000 次播放,即 MIN_PLAYS = 200_000;趋势下的模仿作品需要 100,000 次播放。这是作者采用的筛选规则,不能据此断言播放量就代表模板质量。
每页记录剧情节点的秒数,再由脚本截取对应画面,让用户先看懂模板会发生什么。
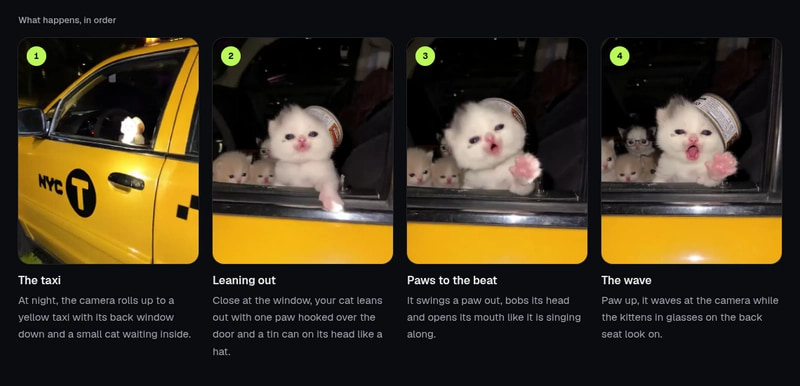
粘贴链接入口也围绕真实使用习惯设计:用户经常贴进整段分享文案,夹着 emoji 和 vm.tiktok.com 短链接。服务端先提取第一个 URL,再手动跟随跳转,只允许 TikTok 域名;最多处理 3 跳,每次请求通过 AbortSignal.timeout(5000) 限时,并设置 redirect: 'manual',自行检查 Location。
解析出的 awemeId 会与已发布页面的参考帖、模仿帖和趋势采集记录匹配。命中返回 { slug },未命中写入 copy_request,成为用户需求清单。这一步不下载视频,接口按 IP 限制为每 10 分钟 20 条链接。
模板固定场景,参数必须跟着任务类型走
作者给模板定的规则很明确:换主体,保留场景。参考视频负责镜头、动作、节奏和声音,用户照片负责人物或动物的外观。
Cat Dance AI 的示例使用 mode: 'reference-video',参考片段长 10 秒,设置 durationSec: 10、aspectRatio: '9:16'、generateAudio: true,等待页展示 etaMinutes: [3, 6]。页面的四个模板分别对应真实流行过的四种版本。
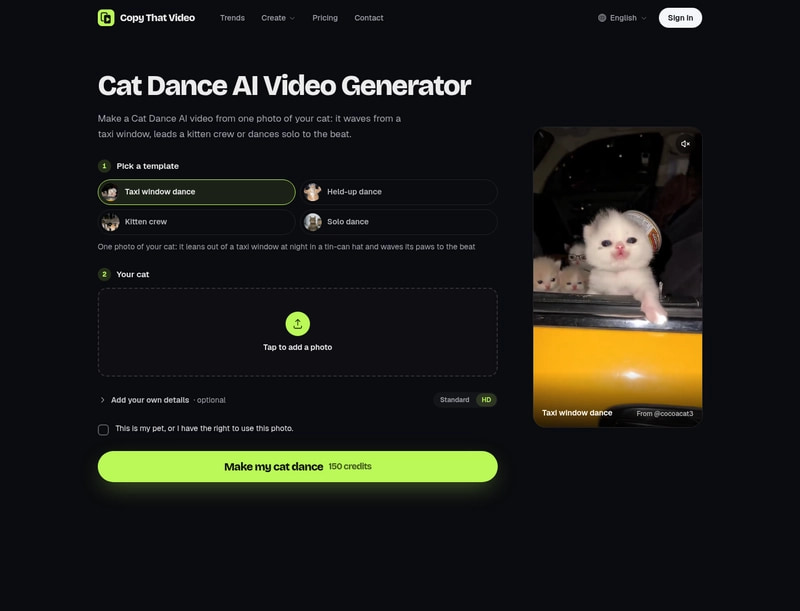
照片顺序也是接口约定:用户照片先传,模板附带的服装、道具图随后传,所以 @image1、@image2 的编号稳定,@video1 始终指向参考视频。可选备注最多 200 个字符,最后追加,并去除 @、花括号和换行。这个处理能防止用户直接插入素材引用标记,但不能据此认定提示词注入已被全面解决。
更容易踩坑的是编辑与生成的参数差异。作者在 10 月 16 日发现,替换参考视频中的人物会被模型视为视频编辑,此时只接受 durationSec: -1 和 aspectRatio: 'adaptive'。其他参数可能先被接受,约一分钟后才报约束错误。
下面这段代码在提交前确定任务参数,避免用户等待后才失败:
const portrait = picked?.frame === 'portrait' && !!gen.choices?.frame;
const edit = !!reference && !portrait;

task: {
  durationSec: edit ? -1 : gen.durationSec,
  aspectRatio: edit ? 'adaptive' : portrait ? '9:16' : gen.aspectRatio,
}
要看的是 edit 的判断:横版参考转竖版时,作者使用 portraitPrompt 生成新片,因为编辑任务保留原画幅。原文没有交代具体模型和版本,这组约束不能直接套到其他服务。
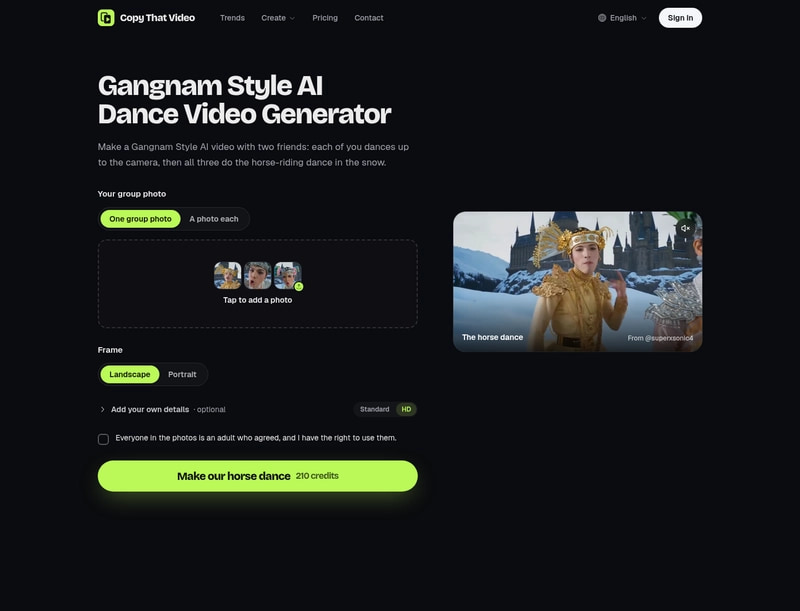
即使要求 9:16,模型也可能返回其他比例。下载后,偏离目标比例超过 6% 的视频会经 ffmpeg 合成为 720×1280:前景完整居中,背景使用同一视频的模糊暗化副本,声音保留。背景先在 90×160、即目标宽高的八分之一尺寸上运行 boxblur=6:2,再放大。
若处理失败,系统保留模型原片并告警。因此「最终都输出竖版」是正常路径的目标,降级路径仍可能交付其他画幅。
花钱之前做校验,失败之后告诉用户怎么改
积分预留、任务结束和退款,都应该成为明确的状态变化。
作者先完成计划和校验,再预留积分、提交生成。照片必须是自有存储域名下 uploads/ 路径的 HTTPS URL,并逐个发送 HEAD 请求,避免把已经删除的旧照片交给模型。
计费按每个开始的秒数向上取整,再用 Math.min(Math.ceil(seconds - 1e-6), MAX_TEMPLATE_SECONDS) 限制上限,其中 MAX_TEMPLATE_SECONDS 为 15。减去 1e-6 是为避免浮点误差多算一秒。
页面、视频列表和 cron 都能轮询任务,但结束操作经过一次条件更新,只有一个调用者能成功完成状态迁移。这使并发轮询不会重复结算。成片随后立即复制到自有存储,避免供应商临时链接过期。原文提到轮询时序,却没有给出具体间隔;套餐规则则明确为一次性购买、积分不过期、失败返还积分。
失败提示同样影响成本和体验。10 月 26 日,一名用户因反复看到通用错误,连续提交相同照片 6 次,而真实原因是模型拒绝了真人照片。现在错误分成 content、photo、other:前两类分别提示规则限制或更换照片,只有最后一类建议重试。
后台还会让文本模型判断哪张照片可能触发拒绝,提示晚到也不阻塞主流程。上传照片另有裸体和性内容检查,但它在生成启动后执行,只告警;真正拦截生成的是视频模型自身的规则。
多人模板则增加关键帧:先由图像模型按镜头摆放人物,再由文本模型检查身份、位置、重复人物、文字和手部异常,要求只返回 JSON。失败最多尝试 3 次,通过的图片才追加到照片后面,并把 {kf-<shot>} 替换为类似 frame follows @image6 的引用。
这一步预算为 200 秒,为路由的 300 秒上限留出提交时间。若关键帧触发真人拒绝,就去掉它们再提交一次;若处理函数中途结束,等待超过 6 分钟的任务也会跳过关键帧继续。
我的判断
我最认可的是作者把失败后的动作写清楚:余额不足就不启动,素材失效就提前报错,参数约束在计划阶段处理,照片不合适就提示更换。对接按次付费的 AI 服务时,这些工作比继续堆提示词更值得优先完成。
但「几行规则」的边界也要看清。失败原因靠正则分类,供应商换一种错误措辞就可能失准;HEAD 成功也不能保证稍后生成时素材仍然可读。上线还需要围绕实际响应持续修正。
多人关键帧尤其属于经验方案。作者没有给出加入前后的身份一致性通过率,也没有说明额外图像生成、检查和重试的成本。文本模型验图能提供一道筛选,不能当作身份一致性的确定性证明。
相比通用视频输入框,独立趋势页减少了用户写提示词的负担,也增加了每个趋势的人工维护量。内容进代码适合需要审查、由开发者快速迭代的阶段;如果每天大量上新、主要由运营维护,成熟 CMS 也是合理选择。参考视频、音频的使用授权及保存策略,原文没有说明。
能拿来做什么
- 在 Next.js 或 Node 的异步生成接口里,先构建并校验完整任务计划,再预留额度和调用供应商;用数据库条件更新保护结束与退款操作。
- 前端等待页应区分规则拒绝、照片问题和临时故障,并明确是否退款,让用户知道下一步该换素材还是重试。
- 做固定场景生成器时,把素材顺序、提示词引用和可选参数一起放进模板配置;横竖屏选择必须参与请求规划。
- 为多人生成增加关键帧之前,先记录当前失败类型,再比较额外耗时、费用和实际改善,确认这道工序是否划算。