用链路追踪还原 Agent 的异常决策
文章介绍 Claude 平台公测的 OpenTelemetry 追踪能力,可记录请求、模型调用、Agent 轮次及 MCP 工具调用,并通过 OTLP 输出。重点讨论给追踪附加哪些上下文,才能支持事后排障。
AI 深度解读
Agent 出错后,最难的往往不是找到报错,而是还原它为什么走到这一步:哪次模型调用触发了哪个工具,当时用了哪版提示词,又有哪些开关改变了执行路径。原文的主张是:用 OpenTelemetry 记录执行过程,再把应用自己的上下文放进 trace。
这套思路值得看,因为接入追踪只解决了一半问题。平台知道模型和工具做了什么,你的代码才知道这次运行属于哪位客户、用了什么配置。把两边的信息接起来,事故后的排查才有依据。
为什么 Agent 更需要一条完整的执行轨迹
普通接口通常围绕一次请求组织逻辑,Agent 则会反复经历模型调用、工具执行、读取结果、再次调用模型。一条用户消息可能展开成十几个步骤,异常也未必发生在最后报错的位置。
Trace 是整次执行的轨迹,span 是其中一个带有耗时和属性的步骤。它能直接呈现调用顺序,让你看到时间花在哪里、运行从哪一步开始偏离预期。
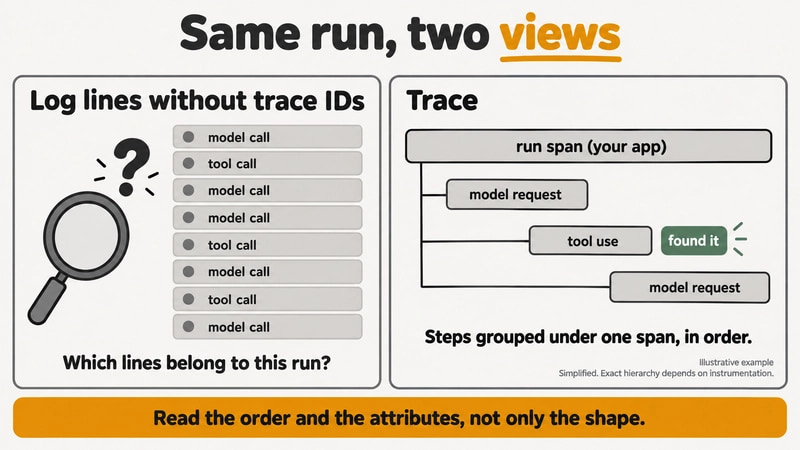
日志同样可以携带 trace ID、span ID 和结构化字段。作者批评的是彼此孤立的日志行:没有关联信息时,工程师只能手动拼接执行过程。
不过,trace 的树形结构也有边界。不同埋点方式会产生不同层级,Anthropic 的示例中还夹着 tool runner 和 request span。父子关系不能单独证明因果,判断异常仍要结合时间顺序、属性和工具返回值。
Trace 能帮助还原执行过程,但调用树本身不能解释全部决策。
API 和 SDK 的追踪,为什么要分别接入
据原文介绍,Anthropic 在 2026 年 10 月 14 日宣布 Claude Platform 的 OpenTelemetry(OTel)追踪进入 public beta。Claude Managed Agents、Messages API 和 Claude SDKs 可以产生覆盖请求、模型调用、Agent 轮次及工具使用的 span,包括 MCP 工具调用。
这些 span 使用 OpenTelemetry GenAI semantic conventions,也就是一套描述生成式 AI 操作的公共属性约定。支持这套约定的平台更容易识别数据;接收端只要支持 OTLP,就可以承接 trace。原文列出的平台包括 Datadog、Grafana Cloud、Honeycomb、Sentry、Splunk、New Relic、Langfuse、LangSmith、Braintrust 和 Arize AI。
接入分成两条路径:
- API tracing 在 Claude Console 配置,由管理员添加 destination,记录 Messages API 请求、请求内的模型运行、Managed Agents 轮次,以及 API 执行的服务端工具。
- SDK tracing 在应用内配置,记录 SDK 发出的请求和 tool runner 执行的客户端工具,但 SDK 不会自行导出数据。应用需要注册 tracer provider 和 exporter;已有 OTel 配置时,SDK 使用已注册的 provider。
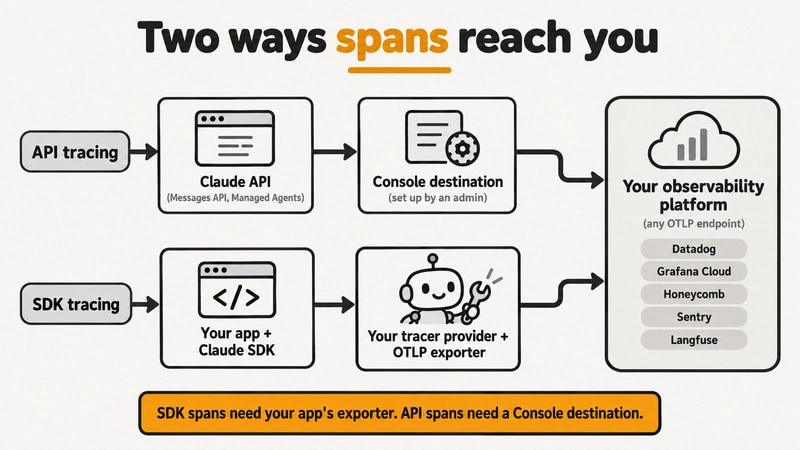
两边都配置好,请求的 SDK span 和 API span 才能进入同一条 trace。只打开 Console 设置,无法补齐应用侧客户端工具的执行过程。
原文给出的 Python 安装命令是:
pip install anthropic opentelemetry-sdk opentelemetry-exporter-otlp-proto-http
这里要留意 opentelemetry-exporter-otlp-proto-http:示例通过 OTLP HTTP exporter 导出数据。初始化还需要 TracerProvider、BatchSpanProcessor 和 OTLPSpanExporter,并在第一次 SDK 调用之前完成注册;目标地址及请求头分别从 OTEL_EXPORTER_OTLP_ENDPOINT、OTEL_EXPORTER_OTLP_HEADERS 读取。
这项能力仍处于 beta。原文明确提醒,span 名称、属性和 SDK 选项可能变化,因此应固定 SDK 版本,但没有给出具体版本号。
真正让 trace 有用的,是应用补上的上下文
平台能记录调用,却不知道应用当时使用哪版提示词、打开了什么功能开关。作者建议在自己的 Agent 轮次外包一层 span,让 SDK 调用嵌套进去。
下面是原文中负责附加业务上下文的片段,依赖前面已经初始化的 tracer、client、版本常量和客户引用函数:
def run_turn(customer_id: str, user_message: str, flags: dict[str, bool]):
    with tracer.start_as_current_span("agent.turn") as span:
        span.set_attribute("app.prompt_version", PROMPT_VERSION)
        span.set_attribute("app.customer_ref", customer_ref(customer_id))
        for name, value in flags.items():
            span.set_attribute(f"app.flag.{name}", value)

        # SDK 的请求 span 嵌套在 agent.turn 下。
        return client.messages.create(
            model="claude-sonnet-5-5",
            max_tokens=1024,
            messages=[{"role": "user", "content": user_message}],
        )
关键是 start_as_current_span("agent.turn") 这一行:它建立当前追踪上下文,让后续 SDK span 有机会关联到应用轮次。app.* 属性名是作者自行选择的命名,并非 OTel 标准字段。
作者最希望附加四类信息:提示词版本、实际生效的功能开关、客户引用,以及过滤后的工具参数。示例提示词版本是 triage-v7,它用于回答「行为变化是否与提示词发布有关」。
客户引用则通过 CUSTOMER_REF_KEY 提供密钥,使用 HMAC-SHA256 计算,并截取十六进制结果的前 16 个字符。这样可以按客户查找运行记录,同时避免直接导出原始 ID。但它仍是可关联的假名化数据,持有密钥的人可以进行匹配,不能当作匿名数据。
工具参数要使用允许列表,只记录明确需要的字段,其余省略或脱敏。单纯截断字符串并不可靠,密钥可能就出现在开头。
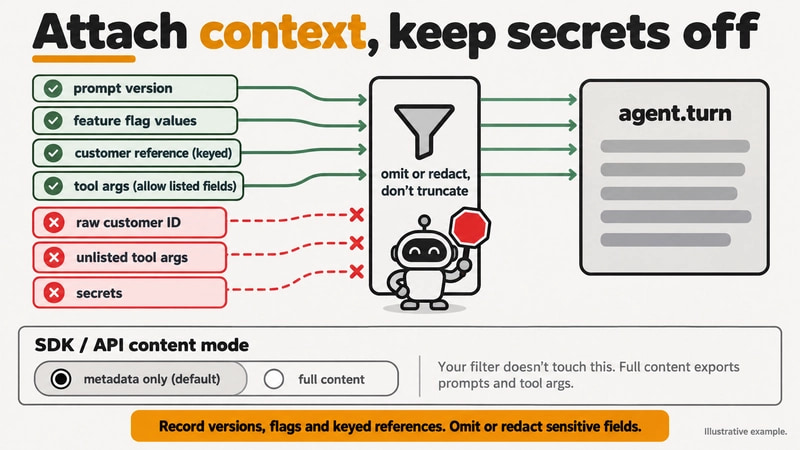
另一个容易漏掉的出口是自动内容采集。默认的 metadata only 模式记录标识符、耗时、状态、token 数量,以及自行设置的工具名、Agent 名等信息;full content 会额外加入提示词、响应、工具参数和结果。
自行过滤 app.* 属性,并不会清洗 SDK 或 API 自动采集的内容。两边设置需要分别检查。conversation ID 在两种模式下都会导出,也不能拿它存放个人信息或秘密。
我的判断
作者最有价值的建议,是把排查问题需要的配置快照留在运行现场。提示词和功能开关都可能改变行为,事故后再根据当前配置推测当时状态,很容易找错方向。
采用 OTel 也有实际意义:已有可观测平台的团队,可以把 Agent 调用放进现有服务链路中查看,减少另建一套追踪体系的成本。
但原文没有给出排障耗时、故障定位成功率或不同方案的对照数据,也没有展示一次真实事故如何被定位。它提供的是接入说明、示意代码和作者的经验判断,不能据此认定 trace 一定比关联完善的结构化日志更高效。
上下文是否完整,往往比有没有一张漂亮的调用图更重要。
full content 同样需要取舍。它能提供更多排查线索,也会让观测平台持有更多业务内容。已有严格访问控制和保留期限的团队更容易承接这件事;其他团队可以先保留元数据与必要字段。原文没有提供适用于所有团队的采样、成本和保留策略。
能拿来做什么
- 维护 AI 编程助手或业务 Agent 时,给每次运行记录实际部署的提示词版本和关键开关值,让异常能够对应到具体配置。
- 在 Node 服务接入 Claude SDK 追踪时,先确认对应 SDK 的配置方式,并检查 provider、exporter 是否在首次调用前注册;原文只有 Python 示例,不能直接当成 Node 接入代码。
- 为工具参数制定字段允许列表,同时分别检查 SDK 与 API 的内容采集设置,避免手动属性已脱敏,自动采集仍把完整内容导出。
- 上线前打开一条真实 trace,从入口跟到模型和工具调用,确认 SDK 与 API span 已关联、业务属性可查询,并在 beta 期间固定 SDK 版本。