智能体上下文越短,账单未必越低
文章援引两项研究指出,删除旧工具输出可能破坏提示缓存前缀,让后续内容重新按未缓存输入计费。其中一项实验中,提示缩短 33.3%,未缓存预填充却增加 608.5%;文章建议结合缓存读写量评估裁剪策略。
AI 深度解读
给 AI 编程 Agent 装一个自动删历史的插件,提示词变短了,账单却可能更高。原文讨论的就是这个反直觉问题:两项研究发现,频繁删除旧工具输出,会破坏原本可以低价复用的提示词缓存,省下的 token 抵不过重新计算的部分。
对经常让 Agent 连续读文件、跑测试、改代码的程序员,这比「上下文越短越省钱」更值得关注。但研究也有明确边界:它们没有直接测 Claude Code、Codex 的云端账单,608.5% 更不是费用涨幅。
为什么删掉旧输出,后面的内容也要重新付费
Agent 每次请求通常都会重新发送整段对话。长会话能持续运行,靠的是提示词缓存(Prompt caching):前面没有变化的内容,可以按缓存读取价格复用。
关键在于,缓存匹配的是从开头连续一致的前缀。
按原文引用的 Anthropic 文档,前缀依次包括 tools、system prompt、messages,需要 100% 一致。假设已经进行到第 40 次调用,插件把第 12 次工具输出改成占位符,那么从修改位置开始,后面的内容就无法继续命中原来的缓存。下一轮再删第 13 次输出,又要重复一次。
删除历史省的是文本长度,破坏缓存增加的是重新计算量。
价格差会放大这种影响。原文列出的 Anthropic API 价格是:缓存读取为基础输入价的 0.1x,5 分钟缓存写入为 1.25x,1 小时缓存写入为 2x。原文称 OpenAI 当时当前模型的默认 30 分钟缓存写入为 1.25x、读取为 0.1x。这些价格和有效期应按具体模型核对,不能当作长期不变的规则。
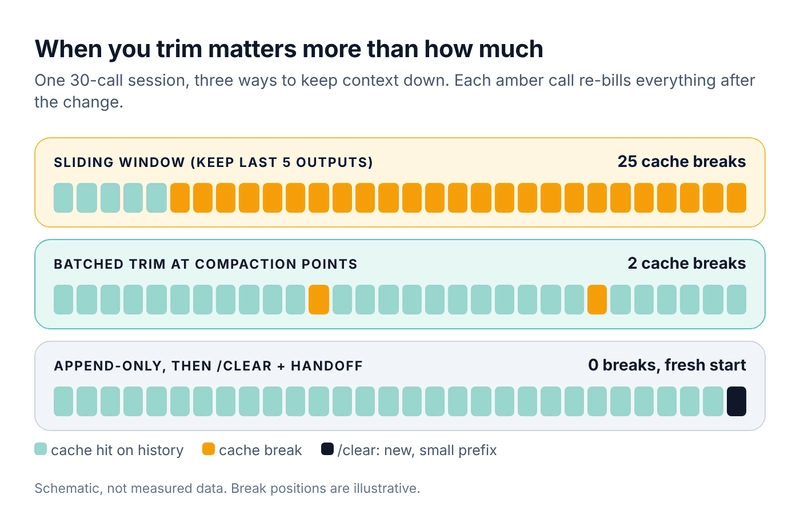
因此,连续工作时最容易踩坑的,是每轮都删除一点旧内容的滑动窗口策略。会话越长、缓存原本越有效,反复改写历史的代价越容易超过收益。
两项研究测到了什么,608.5% 又是什么
第一项研究《The Physical Cost of Context》让 mini-SWE-agent 在本地 GPU 上运行 100 个 SWE-bench Verified 任务,服务端开启前缀缓存。
研究比较了保留全部工具输出的 Eager,以及只保留最近五次工具输出的 Mask-5。后者确实让每个任务累计的提示词从 225.6k 降到 150.5k,减少 33.3%。但无法命中缓存、需要重新计算的输入,也就是 uncached prefill,从 10.0k 升到 70.8k,增加 608.5%。
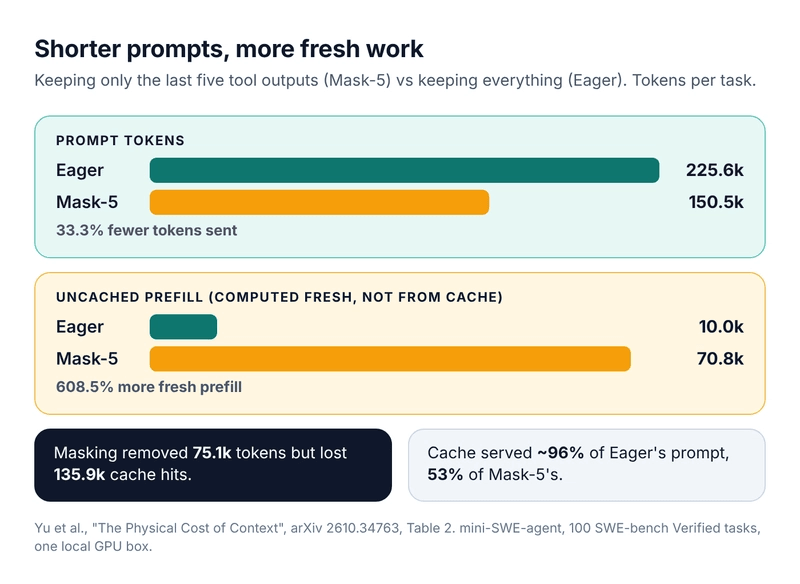
原因可以用两组数解释:Mask-5 删除了 75.1k token,同时损失了 135.9k 原本能命中缓存的 token。缓存覆盖率从约 96% 降到 53%。
实际运行时间增加 36.9%,GPU 能耗指标增加 125.6%,解题数也从 29 个降到 26 个。这里的 608.5% 是新增计算 token 的涨幅,不能直接换算成费用上涨。
同一研究还有 Compact 策略:找到相关文件后,只集中改写一次历史。它让提示词减少 6.5%,新增计算量增加 22%。收益仍有限,但代价远低于逐轮删除。
第二项研究《The Hidden Costs of Forgetting》使用 mini-SWE-agent、Trae Agent 和 DeepSeek-V4-Flash,针对删除内容、比例、粒度、是否延迟两轮等因素测试了 42 种配置,总计 9,400 次运行。
按所有输入同价计算,26 种配置更便宜;把缓存输入按 0.1x、输出按 5x 计价后,没有一种更便宜,其中 26 种显著更贵。一个删除全部工具输出的配置,成本从统一计价下的基线 0.71 倍,变成考虑缓存后的 1.20 倍。最差配置接近五倍。
删除还会诱发重复工作:延迟两轮删除时,工具重复调用最高达到基线的 7.5 倍;立即删除时达到 10.6 倍。立即删除的 42 种配置里,有 19 种解题能力显著下降,几乎都涉及工具输出。
不过,这项研究算的是估算费用。它没有计入缓存写入溢价,还假设所有未变化的前缀都能命中缓存,作者因此把估算称为成本下界。
什么时候该清理,怎样判断有没有省钱
上述结果依赖一个前提:缓存原本就在有效工作。
第一项研究给出的关系是:若实际缓存只能提供实验中比例为 ρ 的命中,Mask-5 带来的新增计算量变化为:
−75.1k + 135.9k × ρ
当 ρ 高于约 0.55,删除会增加计算量;低于这个值,删除可能有收益。这个阈值来自特定模型和任务,不能直接移植到团队的日常开发。
更实用的判断是看工作节奏。连续对话、缓存读取占比很高时,尽量保持历史只追加。已经闲置到缓存过期,或者准备开启新会话时,清理的机会成本更低。一次删掉大块内容,再让新前缀稳定复用多轮,也比每轮删一点更有希望划算。
原文给了 Anthropic context editing 的 beta 配置,用来要求每次清理至少删除足够多的内容:
"context_management": {
  "edits": [{
    "type": "clear_tool_uses_20250919",
    "trigger": {"type": "input_tokens", "value": 100000},
    "keep": {"type": "tool_uses", "value": 3},
    "clear_at_least": {"type": "input_tokens", "value": 40000}
  }]
}
要看的是 clear_at_least:它没有默认值。这里的 40,000 是作者建议的起点,没有实验验证为最优值;收益还取决于清理后继续调用多少轮。
验证时,也不能只看 token 总量或缓存命中率:
- Anthropic 的
cache_read_input_tokens、cache_creation_input_tokens、input_tokens要相加,才是总输入。 - OpenAI 的
input_tokens已经包含缓存部分,缓存读取看usage.input_tokens_details.cached_tokens,原文提到较新模型还提供cache_write_tokens。 - Claude Code 可以用
/cost分开看缓存读取和写入;OpenTelemetry 的api_request事件还能区分 5 分钟与 1 小时缓存写入。
作者建议对同一任务分别开启、关闭清理器,逐轮累计 read × 0.1 + write × 1.25 + uncached × 1,再按实际模型价格调整。这个公式用于比较输入成本,完整账单还要加输出和其他收费项。
我的判断
我认同原文对计费口径的提醒:给 Agent 做优化,不能只展示「少发了多少 token」。如果旧内容原本可以低价读取,把它改掉就可能增加成本。
但两篇论文都在 2026 年 10 月 26 日发布,仍是未经同行评审的预印本。第一项只测了单机、逐个请求,没有测试并发批处理和缓存挤占;第二项使用价格模型,没有真实云账单。它们主要覆盖 SWE-bench 类任务和开放权重模型,不能据此断言所有 Claude Code、Codex 清理策略都会更贵。
研究支持的是警惕频繁改写历史,而不是禁止清理上下文。
一次性摘要、交接文件配合 /clear、按阶段批量清理,都值得作为替代方案评估。不过,作者没有给出这些方案在真实团队中的完整对照数据,不能替它们承诺省钱。
接近上下文窗口上限时,清理还有维持任务继续运行的价值。此时需要同时看能否完成任务、答案质量和总成本,单独追求缓存命中率也会走偏。
能拿来做什么
- 给前端或 Node 项目启用历史清理插件前,选一组相近任务做开关对照,记录每轮缓存读取、写入、未缓存输入,以及任务是否完成。一次运行的偶然结果不足以决定长期配置。
- 连续让 Agent 改代码时,检查插件是否改写旧消息,避免在提示词开头更新动态时间戳,尽量把模型、effort 和工具配置切换安排在会话边界。
- 先减少工具产生的无用内容。测试日志可以按需使用
| tail -50,文件读取限定行范围,比先塞入整份输出再反复删除更直接。 - 在阶段结束时保存目标、已改文件、验证结果和未解决问题,再考虑摘要或
/clear。批量清理后仍要看实际费用,不要把「清理次数少」直接等同于「一定省钱」。