英伟达用固定版本配方部署推理集群
NVIDIA AICR 将 Dynamo 及其基础设施依赖打包为带版本约束和验证检查的部署配方。文章列出1.4.2版本的资源定义升级、通信方式及 NATS 默认安装行为变化。
AI 深度解读
把模型部署到 Kubernetes,不等于推理服务已经可靠。NVIDIA 在 2026 年 10 月 30 日发布的技术文章,把注意力放在 Dynamo 下面的运行环境:驱动、GPU 分配、调度、网络和监控,怎样组成一套经过验证的版本组合。
答案是 NVIDIA AI Cluster Runtime,简称 AICR。它用配方记录组件版本、兼容约束和检查项,再验证真实集群是否符合要求。对自建推理服务的团队,这篇值得读的地方是:如何让「这套环境能跑」变成别人可以复查的证据。
模型部署图,管不到底下所有依赖
NVIDIA Dynamo 是开源的分布式推理框架,使用 DynamoGraphDeployment 描述服务图:vLLM、SGLang 或 TensorRT LLM 分别运行在哪个阶段,需要多少个 GPU worker pod。
但这张图表达的是应用需求。GPU 能否被发现、驱动是否匹配、调度器能否按拓扑放置一组 worker,都需要集群另行提供。
这里的 Dynamic Resource Allocation,简称 DRA,可以理解为由 Kubernetes 协调设备资源的申请与分配;gang 调度则关心一组互相依赖的任务能否一起获得资源。分布式推理不能只看某个 pod 是否启动成功,还要看它依赖的其他 worker 能否就位。
AICR 位于这层基础设施中,并被放进 NVIDIA DSX AI Factory Platform。它把 Dynamo 和依赖项整理成经过验证的配方,让没有亲手搭建集群的人,也能检查配置依据。
以 Amazon EKS 上面向 GB200 NVL72、GB300 NVL72 的推理配方为例,AICR v1.0.0 固定了原文所称的 17 个 Helm chart 版本。对应清单包括:
- GPU 与节点组件:NVIDIA GPU Operator v26.7.1、Node Feature Discovery 0.19.0、NVIDIA DRA GPU Driver 0.5.0、NodeWright Operator v0.19.0、NVSentinel v1.25.0。
- 调度与推理组件:KAI Scheduler v0.16.9、Grove v0.1.0-alpha.13、Dynamo Platform 1.4.2、Agent Gateway v1.5.0 及其 CRDs。
- 证书、存储与网络组件:cert-manager v1.20.2、AWS EBS CSI Driver 2.59.0、AWS EFA v0.5.29。
- 监控组件:Kube Prometheus Stack 84.4.0、Prometheus Operator CRDs 28.0.1、Prometheus Adapter 5.3.0、Kubernetes Ephemeral Storage Metrics 1.19.2。
dynamo-platform chart 固定为 1.4.2,配套包含 Dynamo operator、运行时镜像,以及替代 v1alpha1 的 nvidia.com/v1beta1 版 DynamoGraphDeployment 定义。
Grove 的版本仍带着 alpha 标记。配方的价值不是让每个组件自动成熟,而是把测试过的组合固定下来。升级其中一项时,团队能明确看见自己偏离了哪套基线。
两条路由路径,区别在谁来选 worker
Dynamo 1.4.2 把请求传输与缓存事件分开:请求默认走 TCP,KV-cache 事件走 ZMQ。KV-cache 是模型计算过程中可以复用的中间结果;路由器知道哪个 worker 已经缓存了相同前缀,就有机会减少重复计算。
vLLM worker engine 先在本地发布原始缓存事件,Dynamo worker runtime 订阅、规范化,再转发到 Dynamo 事件平面。原文提到的配置包括 --enable-prefix-caching,以及 kv-transfer-config 中的 enable_kv_cache_events、ZMQ publisher 和本地 endpoint,但没有提供可直接复制的完整代码块。
组件发现改由 Kubernetes 资源承担,因此平台 chart 默认不再安装 NATS;需要它的部署仍可显式启用。
第一条路由路径比较直接:客户端经过 Kubernetes Service,进入 Dynamo Frontend。设置 DYN_ROUTER_MODE=kv 后,Frontend 对请求分词,根据前缀重合度和当前负载给候选 worker 打分,再选择目标。
NVIDIA 将它描述为拓扑最小、生产经验最充分的方案,适合团队维护单个模型专用入口。不过,文中没有提供两条路径的对照测试。
第二条路径通过 Gateway API 接入。agentgateway 把 HTTPRoute 解析到 InferencePool;Dynamo operator 根据 DynamoGraphDeployment,通过 selector 和 endpointPickerRef 建立对应关系。Dynamo EPP 负责分词和选择 endpoint,再把选择结果交回网关。
worker pod 内还会运行 Dynamo Frontend sidecar,使用 --router-mode direct,按照已有选择转发请求。
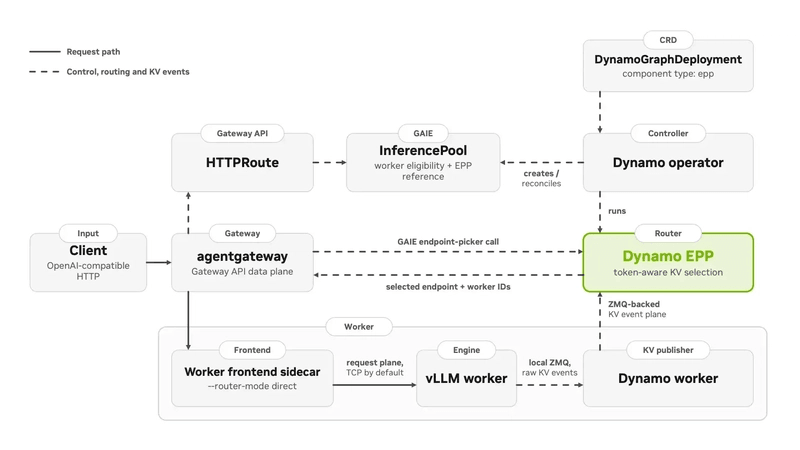
要看清的是职责边界:网关负责 TLS 和 HTTP 路由,EPP 根据 KV 状态选 worker,sidecar 负责转发。token 输出变慢时,排查需要结合各自的指标,不能只盯着模型进程。
验证要放在应用部署之前
AICR 的流程分成五步,顺序值得保留。
第一步,aicr snapshot 记录集群现状。默认选择带有 nvidia.com/gpu.present=true 标签的节点,并容忍 GPU 节点污点,也支持通过 node selectors 和 tolerations 控制放置位置。
第二步,aicr recipe 把快照、部署意图和平台信息转换为配方,写入版本、约束和验证项。
第三步,aicr bundle 将配方渲染成 Helm values 和 manifests。节点选择、污点容忍,以及 agentgateway 的来源地址范围等配置,在这一阶段进入部署产物。
第四步,先执行 helmfile diff 检查差异,再执行 helmfile apply。没有 Helmfile 时,也可以使用生成的部署脚本。
第五步,运行 aicr validate,对真实集群执行 deployment 和 conformance 两个阶段的检查,随后才安装应用的 DynamoGraphDeployment。
配方描述预期配置,验证报告证明这次集群接受了哪些检查。
两者都需要留存。只保存配方,无法说明线上实际部署是否符合它;只保存报告,又缺少复现检查时所依据的版本组合。原文建议把 recipe 和 bundle 纳入仓库,让验证结果可以对应到具体变更。
我的判断
我认同它把版本组合当作交付对象。普通的 Helm values、镜像标签或依赖锁文件,可以固定部分输入;AICR 进一步把跨组件约束和集群检查放进同一套流程,更贴近 GPU 推理平台的运维问题。
但适用前提很具体。这份配方围绕 EKS、GB200 NVL72 和 GB300 NVL72 展开,不能直接当成其他云、其他 GPU 或自建集群的兼容承诺。文章也没有说明完整测试矩阵、执行成本,以及相对人工维护节省了多少时间。
「经过验证」的范围,止于所选配方要求的检查。
原文明确区分了 deployment、conformance 与性能验证。性能验证需要另外运行临时 GPU 工作负载;升级和回滚流程仍需要操作者自己测试。基础组件通过检查,不能直接推导出目标模型的延迟、吞吐和故障恢复已经达标。
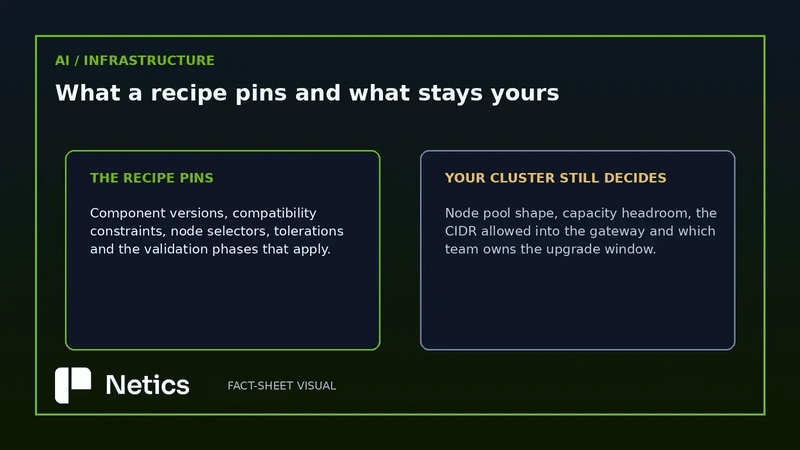
还要区分证据来源:版本清单、协议变化和部署流程来自 NVIDIA 的技术说明;「版本固定让平台可运维」以及建议如何安排升级,是 Netics 作者的解读。文中没有作者独立复现实验或路由性能对照数据,因此这些判断应当作为工程经验参考。
对于只调用托管模型 API 的前端或 Node 团队,AICR 离日常工作较远。对于已经自建 GPU 推理平台的团队,它提供了一个更具体的配置审查和交接方式。
能拿来做什么
- 如果团队正在 Kubernetes 上自建推理服务,可以先把驱动、设备分配、调度器、推理框架、网关和监控的版本组合纳入仓库,并记录它们共同通过了哪些检查。
- 如果 Node 服务连接的是团队自建的 Dynamo 入口,应先确认采用哪条路由路径。排查流式响应变慢时,按网关、EPP、Frontend 和 worker 的实际分工查指标。
- 升级运行环境前,先记录集群快照、审查部署差异,并把验证报告关联到变更记录。基础检查通过后,再安排模型性能与升级回滚测试。