AMD 平台异步强化学习提升代码修复能力
AMD 与 Miles 团队在 MI355X 上,结合 Miles、SGLang、Megatron-LM 和 Harbor,对 Qwen3-30B-A3B-Instruct 进行全异步智能体强化学习。在 SWE-bench Verified 的 100 题分层子集上,pass@1 从 7.3% 提升至 27.5%。
AI 深度解读
训练能修代码的 Agent,瓶颈可能藏在等测试、等沙箱、等最后一条轨迹结束的时间里。LMSYS / SGLang 团队用 Miles 在 AMD Instinct MI355X 上训练 Qwen3-30B-A3B-Instruct,把 SWE-bench Verified 子集的 pass@1 从 7.3% 提到 27.5%。
这份记录值得程序员读,不只是因为分数上涨。它拆出了多轮 Agent 如何拖慢训练、上下文如何挤满显存,以及基础设施故障如何变成错误奖励。但约 4 倍吞吐和约 3 倍步骤加速来自两组不同对比,不能合并成一个固定硬件上的优化成绩。
分数怎么涨的,评测又覆盖了多少
普通单轮强化学习生成一次回答就能评分,编码 Agent 的一个训练样本却是完整任务:读 GitHub issue,在沙箱里执行 20 到 100 多条 shell 命令,修改代码,最后依据仓库测试是否通过拿奖励。中间任何环节堵住,都会影响样本产出。
他们用 SGLang 生成动作,Harbor 管理沙箱,Miles 收集完成的轨迹交给 Megatron-LM 更新模型,再把权重同步回推理端。训练与推理分节点运行,完成的轨迹攒够就训练,使采样和更新能够重叠。
训练分两步。先用 Open-SWE-Traces 约 4,000 条成功轨迹做一个 epoch 的监督微调(SFT),教模型遵循工具格式;再在 SWE-smith 约 1,350 个任务上运行全异步 GRPO。任务来自 47 个仓库,与 SWE-bench Verified 的仓库不重合。
每个任务尝试 8 次,测试通过奖励为 1,不加 KL 惩罚。每轮最多生成 8,192 tokens,整条轨迹最多生成 65,536 tokens,最多执行 80 轮。软件栈还包括 mini-swe-agent 和 ROCm 7.2,系统打包在一个 ROCm 容器中。
评测从 SWE-bench Verified 的 500 个任务中分层抽取 100 个,每题尝试 4 次,报告 pass@1。基座模型是 7.3%,SFT 后为 12.8%,RL 后达到 27.5%,后者贡献了 14.7 个百分点。
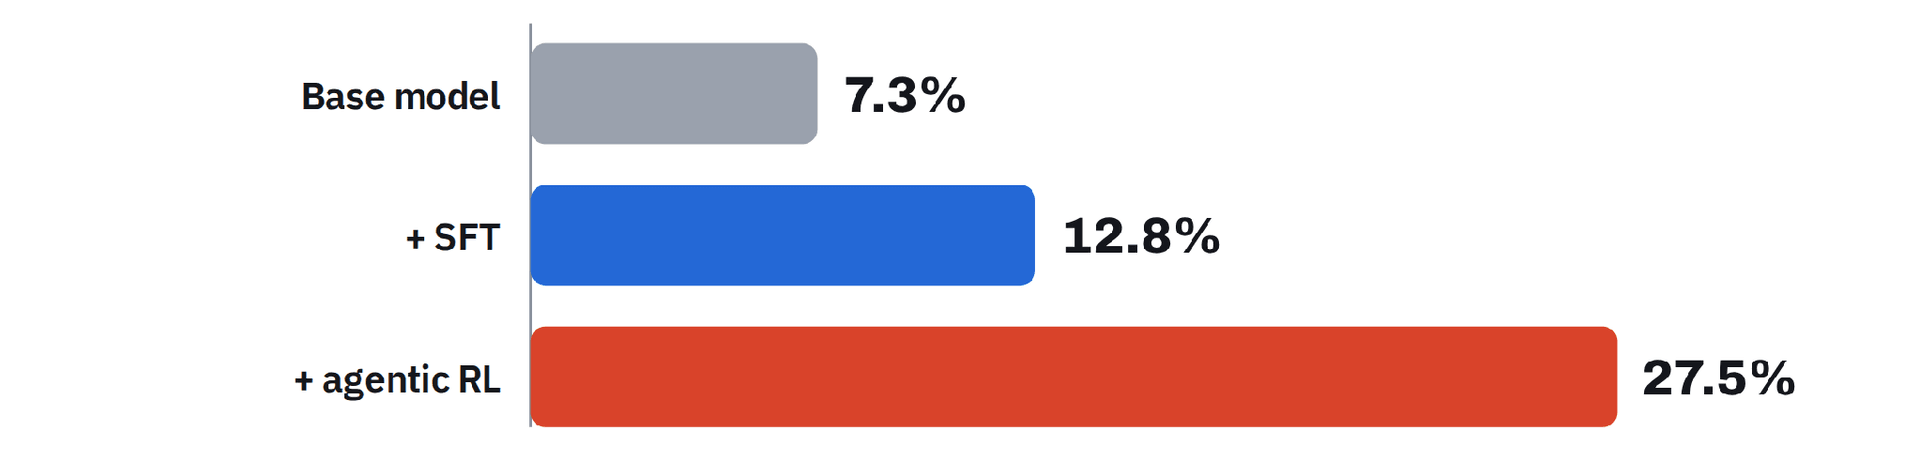
这里的「每题尝试 4 次」是评测采样设置,指标仍是 pass@1,不能理解为尝试四次后的任务通过率。仓库隔离也只证明 RL 阶段没见过这些评测仓库,原文没有证明基座预训练和 SFT 数据都不存在相关内容。
为什么少跑一些轮次,反而能更快训练
GRPO 要比较同一任务多次尝试的结果,因此组内最慢的轨迹会拖住整组。全异步能让训练器继续消费其他已完成的数据,但不能自动消除组内长尾。
作者观察到,同一任务的两次尝试,长度能相差 2.5 倍。84% 的轨迹跑到了轮数上限,成功轨迹的轮数中位数却只有 8。90% 的轨迹完成后,系统仍消耗了整个 rollout 时间的 32%;最慢的一次 AnyIO 尝试持续 28.8 分钟。
收尾时只剩少数序列,解码 batch size 接近 1,GPU 很难吃满。全异步配合更紧的长度限制,在同一台 8-GPU 推理节点上,把步骤时间从 850 秒降到 284 秒,约快 3 倍。作者称这次限制没有影响成功轨迹,但没有给出适用于其他任务分布的截断阈值。
无效探索的尾巴,可能比单次推理速度更值得先优化。
上下文增长是另一类问题。工具输出不断进入下一轮输入,每 token 的 KV cache 占用按 96 KB 计算,一条 64K-token 上下文约占 6.3 GB。一次未设置引擎上下文上限的运行中,少量请求长到 113K–186K tokens,约 10 条就填满了引擎 1.5M-token 的缓存,另外 99 个请求排队直到超时。
把引擎上下文限制为 64K 后,问题得到解决。这里必须区分:轨迹累计生成 token 的限制,和引擎允许的完整上下文限制,是两个控制位置。只限制模型输出,工具返回内容仍可能撑大输入。
MI355X 每卡有 288 GB HBM,能容纳数十条 64K-token 轨迹。即便如此,缺少上下文边界仍能让少数任务堵住整个引擎。
沙箱启动更快,为什么单条任务反而变慢
每条轨迹都需要干净的仓库、依赖和测试环境。并发上百后,这些 CPU 工作就成了 GPU 前面的供应链。
团队把沙箱迁到 E2B 云端 microVM,每个配置 2 vCPU、4 GB 内存。最大运行使用三个推理节点和一个训练节点,每节点 8 张 MI355X;24 个单 GPU SGLang 引擎,每个承载 16 条轨迹,总并发达到 384。
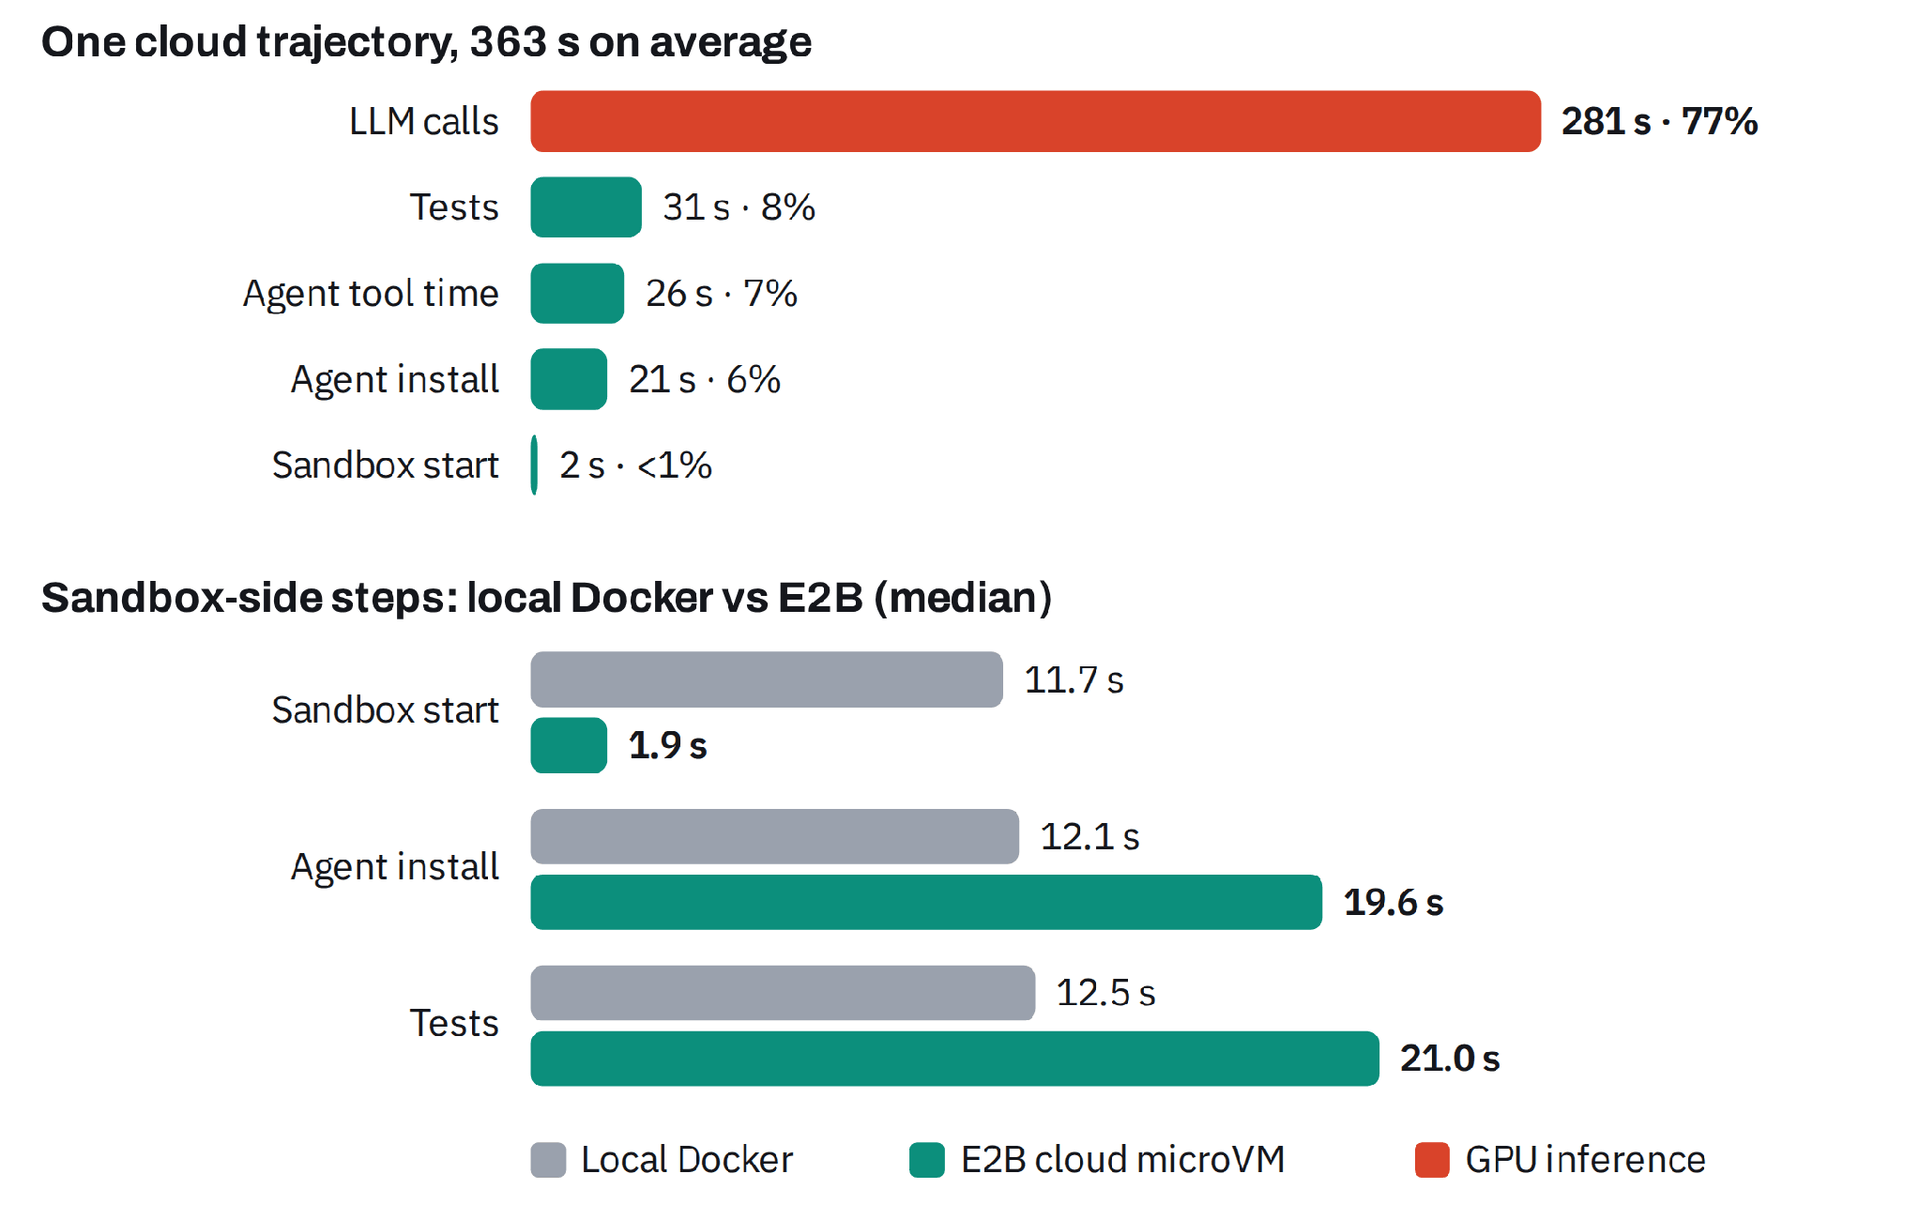
E2B 沙箱启动中位数为 1.9 秒,p99 为 3.7 秒,本地 Docker 在负载下的中位数则为 11.7 秒。但小规格 microVM 安装 Agent 多花 7.5 秒,测试多花 8.5 秒,每次 LLM 调用穿过隧道又增加约 0.26 秒。单条轨迹因此多花 15–40 秒,占其耗时的 4–11%。
单条变慢与整体变快可以同时发生:云沙箱减少启动排队,允许更多任务并行。吞吐从约 860 提到约 3,480 条轨迹/小时,但这同时包含推理节点从一台扩到三台、迁移沙箱和修复并发限制的收益。
384 并发时,LLM 调用占轨迹时间的 77%,沙箱侧合计占 22%;引擎等待队列为空,KV cache 使用率最高仅 23%,当时卡住扩容的是沙箱并发。
更有借鉴价值的是那些固定上限:每机最多 31 个 Docker 网络、整个集群每小时 100 次镜像下载、Miles 的 100 个 Agent 连接,以及单个 CPU 核处理全部请求。它们都曾表现得像 GPU 性能问题。
故障还会污染训练。原文另报有 3.1% 的轨迹因基础设施错误结束,却和修复失败一样拿 0 分,因此需要记录和过滤。云端稳态统计中,轨迹失败率为 2.6%,300,500 次隧道 LLM 调用的错误率为 0.09%。这几项统计口径不同,不能相加。
我的判断
这篇最有说服力的部分,是把吞吐问题追到了具体等待位置。384 并发运行中,训练器侧测得步骤均值为 208 秒:actor 更新占 63%,等待 rollout 占 29%,重算 log-probability 占 8%;权重同步的 23 秒单独记录。它解释了为什么只盯推理引擎会漏掉大量时间。
稳定性也有实测支持:训练持续 145 步,经历三次 checkpoint 恢复;轨迹长度约稳定在 30K tokens,训练器与推理端的平均逐 token log-probability 差约 0.011,重要性权重的有效样本量平均为 93%。不过,这些结果只能支持这次运行,不能直接推广到更大模型。
约 4 倍吞吐不是约 4 倍单卡效率,27.5% 也不是完整评测集成绩。
与继续增加 GPU 相比,先解决长度、排队和固定连接上限,确实更符合这组测量。但云沙箱相对本地容器是否划算,还缺成本对照;预热池和快照比加核更重要的判断,也依赖他们的平台条件。自托管 E2B 每次只能启动 3 个沙箱时,启动等待占轨迹时间的 20%;新沙箱首次调用在微基准中又比重复调用慢 15 倍,不能据此断言所有部署都该同样取舍。
DeepSeek-V4-Flash、GLM-5.3、Kimi K3 在文中属于扩展讨论,不能当成已经复现同等训练收益的模型。
能拿来做什么
- 给日常 AI 编程任务分别记录 LLM 请求、工具执行、沙箱启动和测试耗时,再观察少数最长任务消耗了多少时间,决定先优化哪一段。
- 为自动修复或测试 Agent 同时设置轮数、累计生成量和完整上下文上限,单独处理过长的工具输出,避免只管回答长度。
- 批量运行仓库任务前,检查镜像拉取额度、网络数量、连接池和请求处理进程,并比较冷启动与重复调用,验证预热是否有用。
- 在 Agent 评测或训练中区分代码测试失败、环境启动失败和网络超时,保留独立状态,避免用基础设施故障评价模型修复能力。