英伟达开放多任务语音模型及微调资源
Nemotron 3.5 Transcribe 通过文本提示执行转写、翻译与说话人识别,并在多项基准中领先,活跃参数量仅为其最强开放竞品的六分之一。英伟达还发布超过 80 万小时的语音数据集及微调工具。
AI 深度解读
Nvidia 把语音转写、翻译、说话人区分和录音问答,装进了同一个开放模型 Nemotron 3.5 Transcribe。它想解决的不是单纯的「听写」,而是让一段会议录音按文字指令,变成带发言人标签的记录、英文译稿或决策摘要。
这次发布值得看的有两件事:一是准确率接近领先模型,同时每步只激活约 40 亿参数;二是 Nvidia 给出了领域适配的数据和结果。但单卡能跑不等于部署便宜,榜单领先也不等于中文会议可以直接放心交付。
一个模型能做几件事,要先看语言和输入限制
Nemotron 3.5 Transcribe 支持 40 种语言转写,其中 31 种支持与英语互译,13 种支持说话人区分。它能处理最长一小时、最多八位说话人的录音。
这里的说话人区分,主要回答「哪句话由谁说」,不应直接理解成识别出某个人的真实身份。普通转写只有文字,加入说话人标签后,才方便追踪谁提出方案、谁确认结论。
用户通过文字指令选择任务。同一段录音,可以要求逐句转写、输出英文,或者整理决策。还可以提供药名等术语作为提示;模型按设计只应在录音确实出现这些词时使用它们,不能把提示当成必须写进结果的内容。
支持多项语音任务,不代表每种语言都具备全部能力。
原文没有列出完整语言能力表,而且录音问答是在英语上训练的。需要中文转写、说话人标签和中文问答同时工作时,不能仅凭「支持 40 种语言」推断它们都已覆盖。
另一个边界更直接:它只处理录好的音频,不支持实时处理。Nvidia 在 9 月推出的 Nemotron 3 Diarization 可以实时区分最多八位说话人,但转写需要另外搭配 Parakeet。新模型合并了任务,却没有继承实时能力。作为对照,Mistral 的 Voxtral 系列也结合转写与音频理解,Voxtral 3 则把重点放在实时语音 Agent。
准确率接近领先模型,单卡吞吐要连硬件一起看
模型总参数量为 300 亿,每步约激活 40 亿参数。原文称,它能运行在单张 Nvidia GPU 上,覆盖紧凑的 DGX Spark 到数据中心硬件。
不过,活跃参数主要描述一次计算涉及多少参数,不能直接当作模型加载时的显存需求。原文没有提供各硬件的显存占用和完整部署配置。
Nvidia 给出的吞吐成绩是:在 RTX PRO 6000 Blackwell Server Edition 上,使用 NVFP4 精度,不到三分钟处理 100 小时音频。这是特定硬件和精度下的处理量,不能理解成任意单卡都能达到,也不能据此推算单段录音的响应延迟。
准确率有两组独立结果。在 Hugging Face 英文 Open ASR Leaderboard 上,它以平均词错误率(WER)5.33% 排在开放权重模型首位,领先 Qwen3-ASR-1.7B 的 5.4% 和 IBM Granite Speech 的 5.68%。
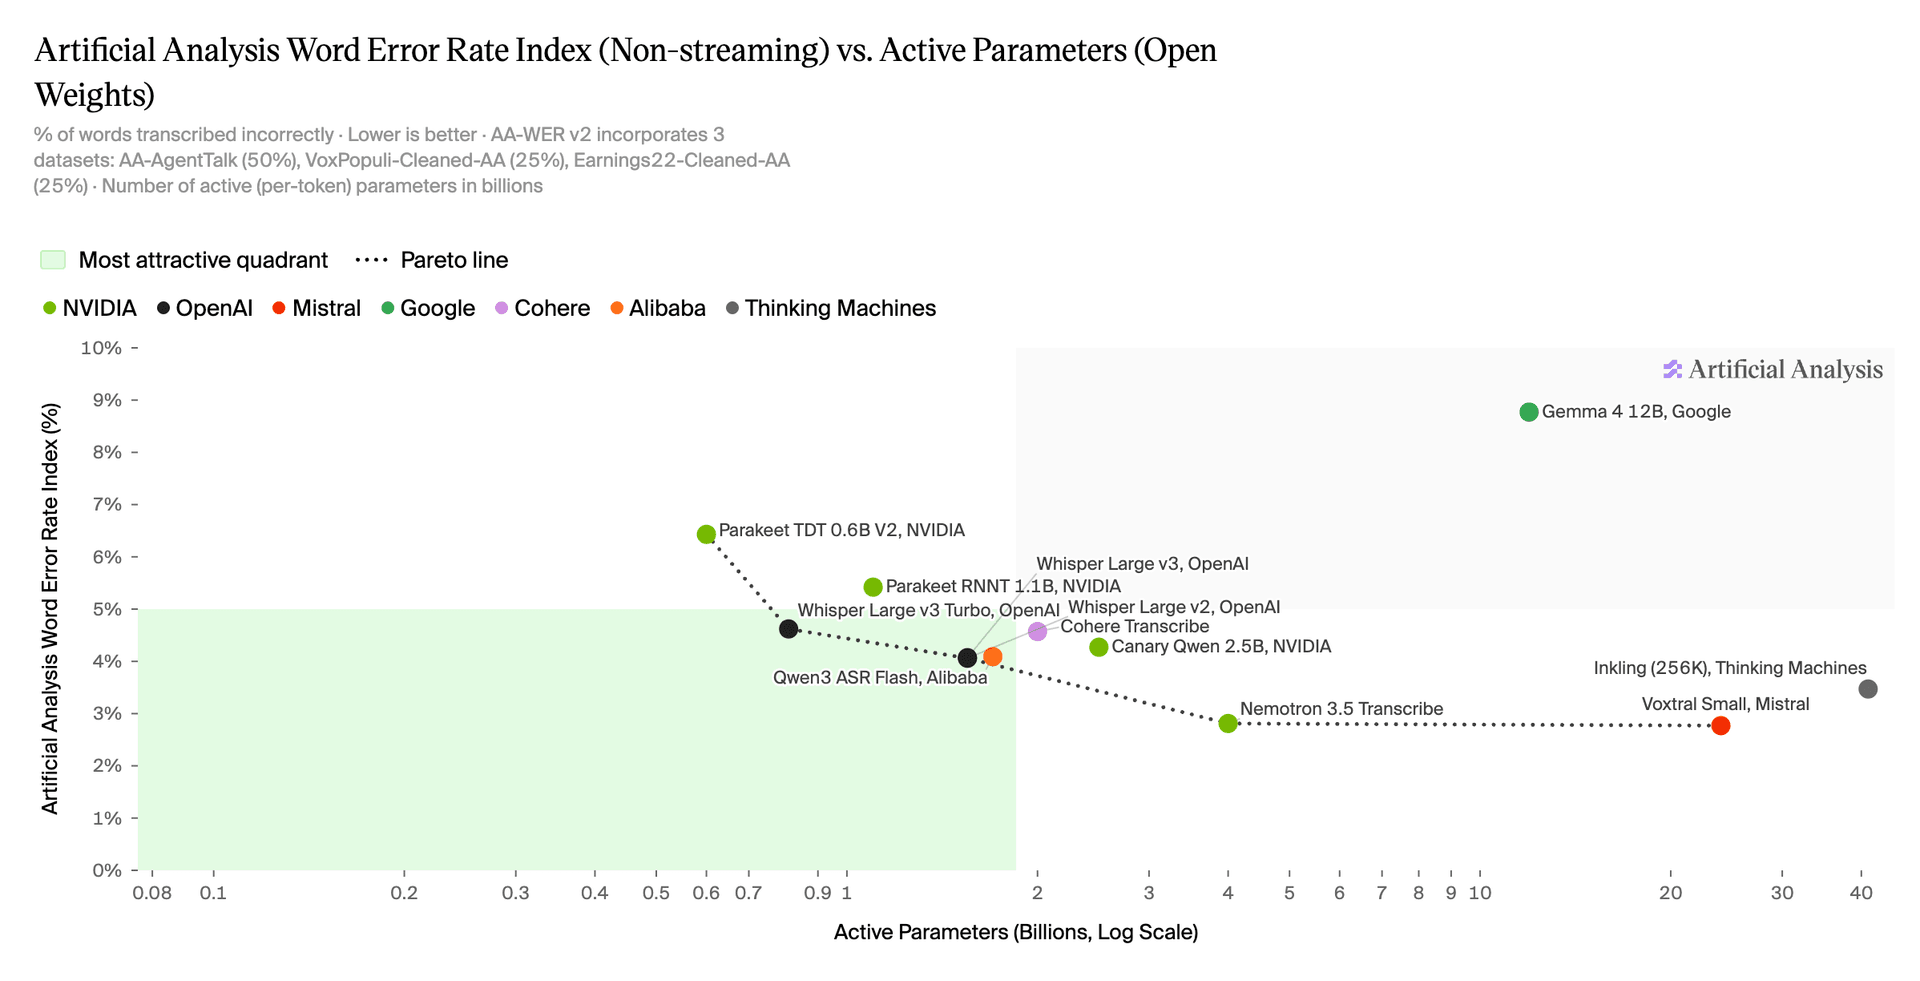
在 Artificial Analysis 的比较中,它的 WER 是 2.81%,接近 Voxtral Small 的 2.77%,活跃参数却只有后者约六分之一,即约 40 亿对 240 亿。两套评测的数据不同,5.33% 和 2.81% 不能直接互比。
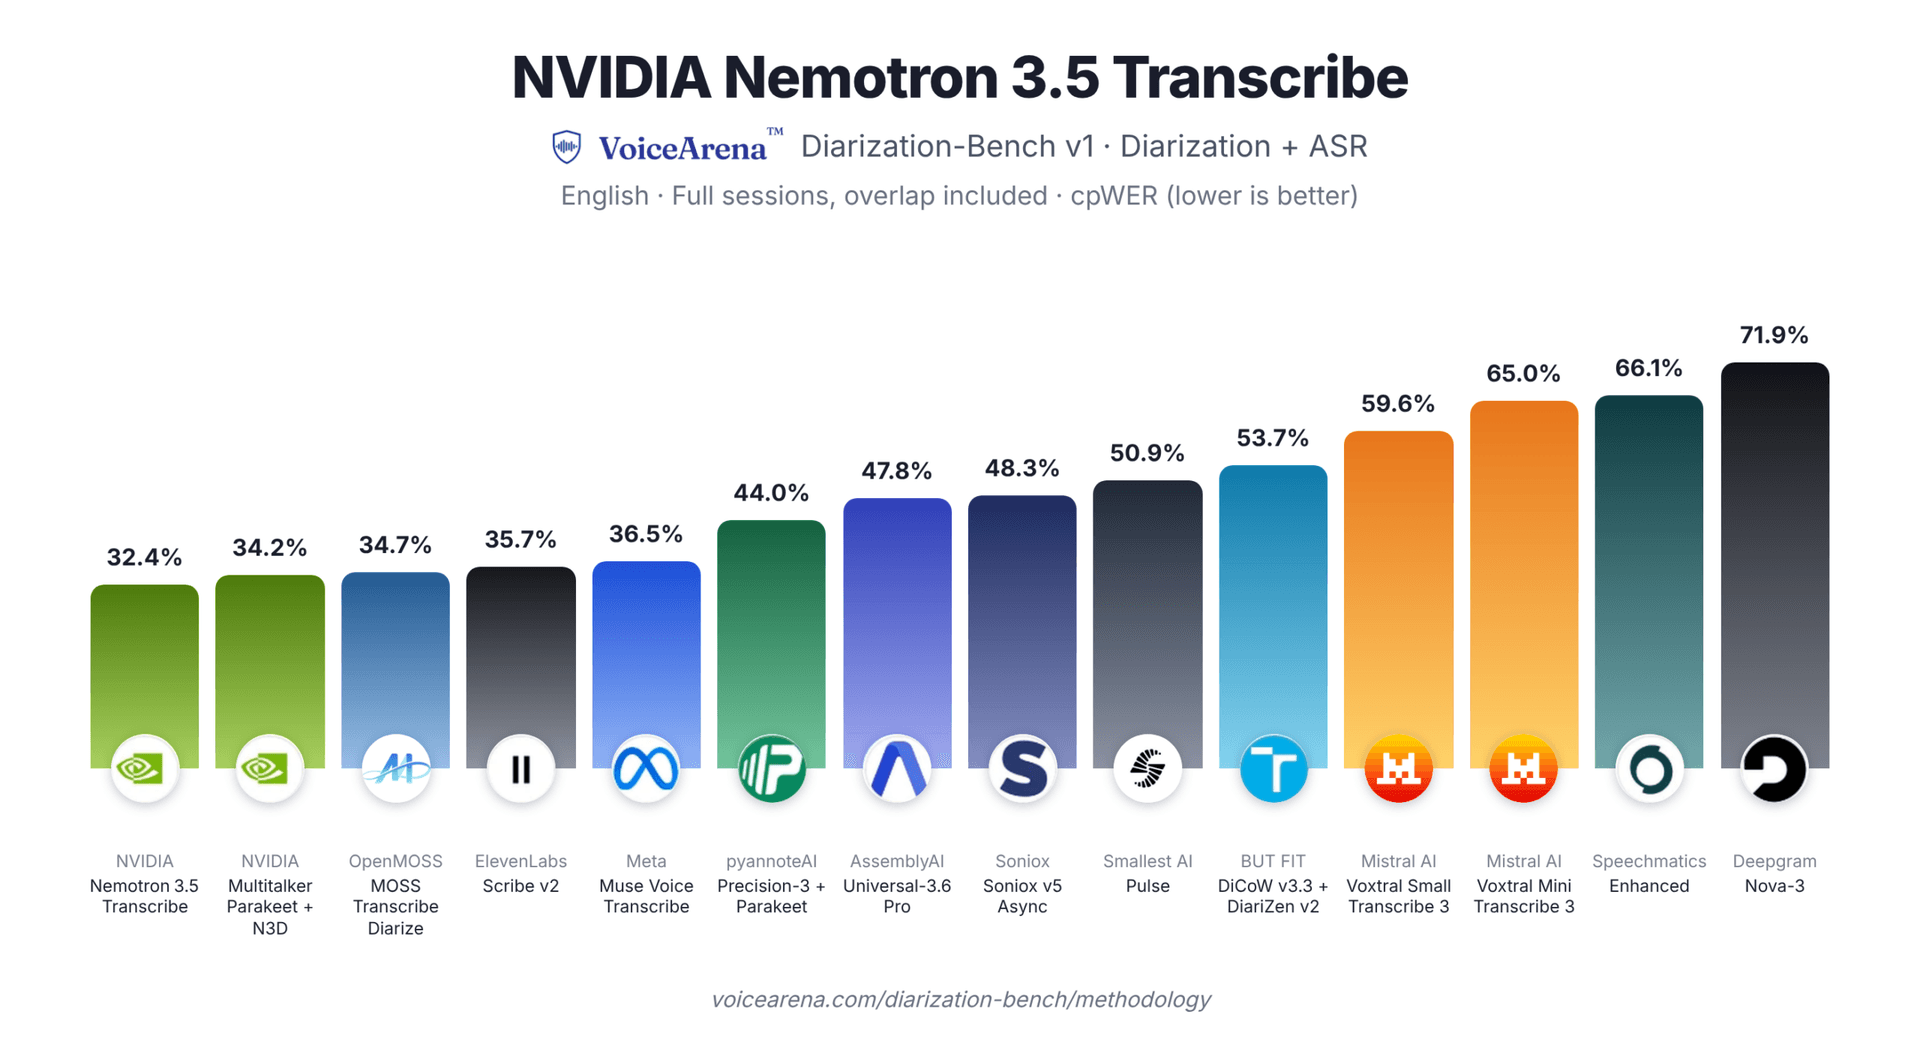
说话人区分的表现更突出。VoiceArena 用存在抢话、重叠发言的英语对话测试了 14 个系统,它取得第一,漏词率为 8.32%,参评系统的中位数约为 31%。
但这个第一仍有明显误差:Diarization-Bench v1 的 cpWER 为 32.4%,后面是 Multitalker Parakeet 的 34.2%、MOSS Transcribe Diarize 的 34.7%,Deepgram Nova-3 为 71.9%。cpWER 同时涉及转写和说话人归属,不能把它与普通 WER 混为一谈。
David AI 的 DAI-ASR-I18N 评测覆盖 21 种语言,它的说话人分离错误率为 18.26,略好于专用模型 Nemotron 3 Diarization 的 18.38;gpt-4o-transcribe-diarize 为 37.55。评测覆盖 21 种语言,也不等于官方承诺支持 21 种语言的说话人区分。
领域适配有实测收益,也会损失通用能力
随模型发布的 Granary v2 包含约 844,000 小时、48 种语言的语音,上一版约为 643,000 小时、25 种语言。每段录音有不同转写风格,例如保留语气词、数字写成文字的逐字稿,以及去掉语气词、使用数字字符的整理稿。
这对应用开发很实用:字幕、会议纪要和逐字存档需要不同输出规范,训练目标应该先明确。Nvidia 还开放了构建数据集的工具,但说明该数据集并不完整对应模型的训练数据,不能据此声称可以复现整个训练过程。
领域适配案例来自印度医生和医学生的录音。在完整基准上,更精确的提示词把错误率从 30.8% 降到 23.8%;微调后进一步降到 11.8%,训练数据主要是合成语音。
对模型此前没听过的说话人,Nvidia 另外报告了从 22.44% 降到 12.17% 的结果,相对改善 45.8%,好于一个开放医疗语音模型的 13.79%。这组结果与前面的完整基准口径不同,不能拼成一条连续下降曲线。整个适配过程据称在单张 Nvidia GB300 上用了约 14 GPU 小时。
代价也被报告了:通用英语错误率略升,而品牌药名识别仍是对照医疗模型更准。Nvidia 建议定制时至少留出 100 条经过核验的真实录音用于测试。
我的判断
我更看重它把「文字是否听对」和「发言归属是否正确」放在一起解决。会议记录的可用性依赖两者,单纯优化听写准确率,仍可能把结论安到错误的人身上。
但原文没有给出一体模型与「ASR+说话人分离+文本模型」流水线的完整成本、延迟和维护对照。少接几个模型有工程吸引力,是否更省钱、更稳定,还不能替它背书。
医疗案例说明提示词和微调都可能有效,却不能推广成任意行业的收益保证。录音条件、口音、术语和合成数据质量都会影响结果。模型与数据集已上 Hugging Face,也有演示、微调指南和供 AI 编程助手运行训练流程的扩展;原文未交代许可证细节和完整训练配置,正式选型仍需补齐这些信息。
能拿来做什么
- 给已有录音上传功能增加转写或摘要时,可以先把它作为离线处理候选。前端展示上传与处理状态,服务端执行推理;实时字幕需求应另选方案。
- 做会议记录评测时,挑选真实的多人抢话录音,分别核查漏词、术语和发言归属。人名、说话人切换及录音问答结果都应抽查。
- 遇到行业词识别差,先比较普通提示和包含术语、输出规范的提示,再决定是否微调,并按建议预留至少 100 条核验过的真实录音。
- 让 AI 编程助手参与训练流程时,把训练配置和评测结果留作可复查产物,同时测试领域录音与通用录音,避免只看到专项分数上涨。