用回滚和返修记录评估编程代理
文章指出,模型使用不同代理框架和任务集时,榜单成绩难以直接比较。建议在提交中标记代理来源,利用回滚、一周内修复和主分支失败记录衡量其在自身仓库中的表现。
AI 深度解读
选 AI 编程工具,排行榜只能帮你列候选,仓库里留下的返工记录才更接近实际成本。作者提出了一个可操作的办法:给合入的提交标记 Agent 和 Model,再统计它们后来有没有被回滚、在一周内修补,或者让 main 上的 CI 失败。
这套思路值得看,但标题比证据更强。作者没有拿真实团队的历史跑过脚本,统计结果也不能直接归因于模型。真正有用的,是把「哪个模型更强」变成「哪种工具组合更适合我们这类任务」。
排行榜测到的,为什么不只是模型能力
作者从 Meta 的 Muse Wonder 模型卡切入。这份日期为 2026 年 10 月 12 日的材料说明:SWE-Marathon 中,Abundant AI 提供的 GPT-6 Astra 和 Claude Fable 5.1 成绩分别来自 Codex 与 Claude Code,并非使用统一运行框架的受控比较。
这里的运行框架(harness),包括提示词、工具、执行环境和运行限制。同一个模型,周围配置不同,成绩也可能不同。Meta 对自行测试的竞品使用了尽可能统一的设置,但承认未必针对各家模型完成最佳调优。
Epoch AI 的记录提供了另一条证据:2026 年 2 月 12 日,他们升级了 SWE-bench Verified 的脚手架、环境和 token 限制,随后模型成绩明显提高。原文没有给出具体增幅,不能据此计算配置贡献了多少分。
作者想指出的是:榜单比较的是模型与运行配置的组合,而且任务通常在测试通过时结束。团队还要承担合入后的维护成本。
2025 年 DORA 报告调查了近 5,000 名技术从业者,90% 表示在工作中使用 AI。报告发现,AI 采用程度与交付吞吐量、产品表现呈正相关,同时与交付稳定性呈负相关。原文还提到,DORA 于 9 月 3 日宣布不开展年度调查,也不发布 2026 年版报告,因此作者沿用 2025 年的结果。
但这是相关性调查,不能直接证明某个 Agent 导致了故障。DORA 的变更失败率关注部署后需要立即干预的比例,部署返工率关注生产事故引发的计划外部署。Git 中的回滚、补丁可以提供线索,却不等同于这两项部署指标。
给提交补上来源,才能追踪合入后的代价
作者建议统一使用 Git trailer,也就是提交信息末尾、与正文空一行的 Key: value 字段。
Claude Code 已有提交署名机制,可通过 attribution.commit 修改或隐藏;Aider 会在作者和提交者名称后附加 (aider)。但这些格式不统一,也未必同时记录模型,单独增加 Agent: 和 Model: 更方便统计。
下面这段命令把任务分支压成一次提交,并记录工具与模型:
git switch main
git merge --squash hermes/fix-login
git commit -m "Fix flaky login test" \
  --trailer "Agent: claude-code" \
  --trailer "Model: claude-opus-5-5"
要注意两条 --trailer:它们分别标记 Agent 和模型,后续比较的单位就是这对组合。这里的 claude-opus-5-5 是原文示例值。
已有但尚未推送的提交,可以用 git commit --amend --no-edit 配合相同参数补齐。再执行 git log -1 --format=%B | git interpret-trailers --parse,确认 Git 能正确解析。任务中途换过工具,就写两条 Agent:。
修补也要有约定。作者借用 Linux kernel 的 Fixes: 格式:记录被修复提交的 SHA-1,至少保留前 12 个字符,并附上单行摘要。无论代码由谁写,修复近期引入的问题时都应标记,否则人工代码和 AI 代码会出现不同的漏记程度。
三个信号能组成账本,但还算不上质量评分
作者提供的 agent_scores.py 读取最近 90 天的非合并提交,按 Agent 与 Model 组合统计三个信号:
- 提交是否被后续提交回滚。
- 提交是否在 7 天内被带有
Fixes:的提交修复。 - 提交是否对应 main 上失败的 CI 运行。
脚本通过 Git 的 %(trailers) 占位符读取归属信息,再用 gh run list --branch main --status failure --limit 500 --json headSha 获取失败运行。在仓库根目录执行 python3 agent_scores.py,同时需要 gh 已登录。
下面是原文负责归因和计数的后半段,需要接在前半段构建 commits 映射的代码之后:
def lookup(prefix):
    hits = [s for s in commits if s.startswith(prefix)]
    return hits[0] if len(hits) == 1 else None

reverted, fixed = set(), set()
for sha, (ct, _, msg) in commits.items():
    for m in REVERT.finditer(msg):
        if m.group(1) in commits:
            reverted.add(m.group(1))
    for m in FIXES.finditer(msg):
        target = lookup(m.group(1))
        if target and 0 <= ct - commits[target][0] <= WEEK:
            fixed.add(target)

runs = json.loads(run("gh", "run", "list", "--branch", "main",
                      "--status", "failure", "--limit", "500",
                      "--json", "headSha"))
red = {r["headSha"] for r in runs} & set(commits)

def tally(shas):
    return Counter(commits[s][1] for s in shas if commits[s][1])

landed = tally(commits)
rv, fx, ci = tally(reverted), tally(fixed), tally(red)
bad = tally(reverted | fixed | red)
print(f"{'agent / model':34}{'landed':>7}{'revert':>7}"
      f"{'fix<7d':>7}{'red CI':>7}{'any':>7}")
for who, n in landed.most_common():
    print(f"{who:34}{n:7}{rv[who]:7}{fx[who]:7}{ci[who]:7}"
          f"{bad[who] / n:7.0%}")
重点看 bad = tally(reverted | fixed | red):最后的 any 列取三个集合的并集,同一次提交即使同时被修补和回滚,也只计一次。因此,它统计的是出现过后续异常信号的提交占比,并非单纯的回滚率。
脚本还有明确前提:每个任务以一次 squash 或 rebase 后的提交落到 main;回滚使用默认的 This reverts commit 加完整提交 ID 格式;CI 在推送 main 时运行。启用 revert.reference 会改变回滚引用格式;如果只跑 PR CI,PR head SHA 与 squash 后的 SHA 对不上,red CI 就会保持为零。
它也不会记录推送前的 git reset 或工具撤销。多个 Agent: 会被拼成组合名称,脚本没有把责任拆给各个 Agent。作者明确承认尚未用真实团队历史验证,采用前需要按团队合入方式调整。
我的判断
我赞成把合入后的返工纳入工具选择,但「唯一重要的基准」说得过满。
12 次合入中出现 3 次回滚,未必足以说明工具差。作者建议每个 Agent 至少积累几十次合入,并等待数周。即便如此,任务难度仍然影响结果:数据库迁移和文案修改不能直接放在一起比较。增加 Task: migration,或按顶层目录分组,会比总榜更有解释力。
回滚原因也要人工读。产品取消功能、feature flag 调整、偶发测试失败,都可能进入这张表。返工较少还可能来自更严格的人工审查,不能全部算成模型功劳。
相比公共榜单,这套方法贴近真实仓库;相比固定任务的受控评测,它又更难隔离变量。两者可以配合:用榜单缩小候选,用同类任务的仓库记录决定长期配置。原文没有提供对照实验,关于效果的主张仍属于经验建议。
作者还在推广自己开发的 Hermes IDE,这层利益关系需要摆明。Hermes 2.3.4 支持按任务选择 Agent、model、effort 和 account,并保存为 presets;每个任务使用独立的 hermes/<name> 分支与 worktree。⌘G 打开的 Review Desk 可以按轮次或文件审查,Land 则提交工作并打开 PR,或合并回任务起始分支。
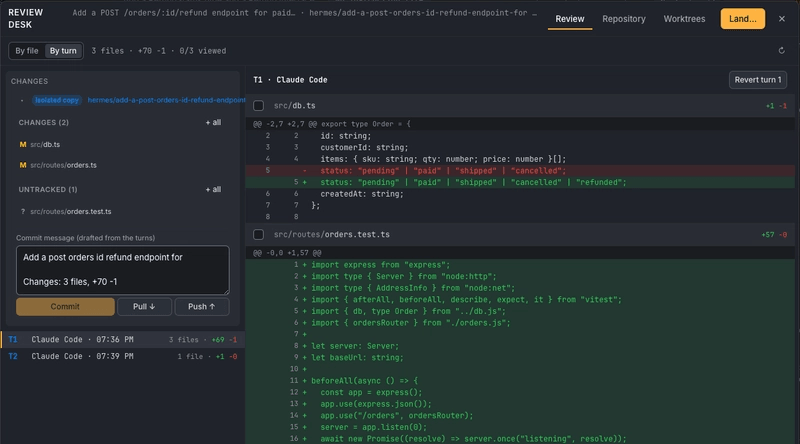
这些功能方便组织任务,但 Hermes 没有文档化的 commit-trailer 配置,归属标签仍需通过 Git 补齐。它免费,采用 BSL 1.1 提供源码,支持 macOS、Windows 和 Linux;统计方法本身不依赖它。
能拿来做什么
- 在前端或 Node 仓库的 squash 提交模板里加入
Agent:、Model:,人工编写的修补同样遵守Fixes:约定,先让记录保持一致。 - 先核对 CI 触发方式、回滚格式和合入策略。如果只运行 PR CI,就调整 SHA 关联方式,避免把零失败误读成高质量。
- 把数据库迁移、测试修复、页面修改等任务分组,积累几十次合入后,再比较同类任务中的工具组合,并逐条阅读异常提交。
- 用记录调整具体任务的默认配置。某个组合在迁移任务上反复返工,就优先更换这类任务的配置,同时保留人工审查和测试要求。