前端复用MCP工具的数据接入方案
文章比较浏览器直连MCP与后端代理两种方式,并展示初始化后的工具调用协议。推荐通过后端代理隐藏凭证、校验用户会话并限制可调用工具。
AI 深度解读
MCP Server 不只服务 AI 助手,也可以给网页提供数据。作者提出,让订单后台与 Agent 共用 search_orders,可以减少两套查询入口各自维护的成本;前端通过一层 Node.js 代理调用,就能沿用普通 HTTP 接口的开发方式。
这篇的价值在于讲清了连接路径、返回格式和错误分层。但它提供的是接入示例,没有生产验证数据。尤其是鉴权、结果解析和流式处理,代码能说明方向,离可靠上线还有几步。
网页为什么也能调用 Agent 的工具
MCP 把工具调用封装成协议,并没有要求调用方必须是模型。Agent 能查询订单,网页也能发起同样的请求。共用的是服务端能力,页面仍然负责搜索按钮、加载状态和列表渲染。
作者给了两条路径:
- 浏览器直接使用官方 TypeScript SDK
@modelcontextprotocol/sdk,通过 Streamable HTTP 连接远程 MCP Server。演示和内部工具接入较快,但浏览器需要持有服务凭据,服务端也必须允许 CORS。 - 后端运行 MCP Client,再向网页暴露
/api/tools/search_orders这样的普通接口。MCP 凭据留在后端,并在入口检查用户身份、限制可调用工具。
让 UI 与 Agent 复用查询能力,不等于让浏览器直接持有 MCP 凭据。
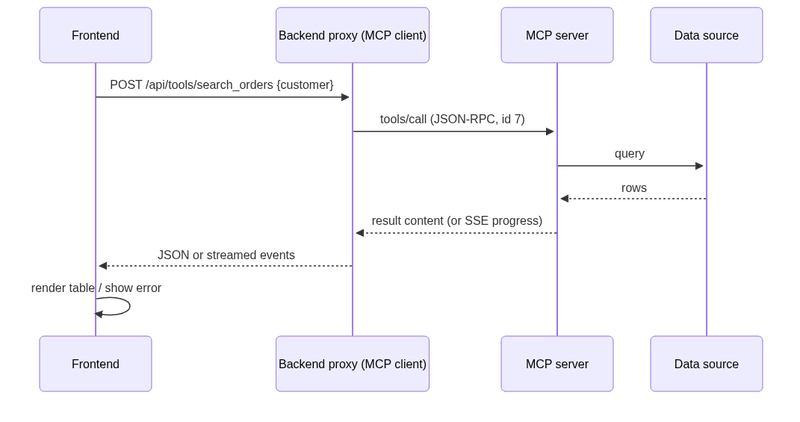
协议层使用 JSON-RPC 2.0,先完成 initialize 握手,再通过 tools/call 指定工具名和参数。原文的请求用 id: 7 调用 search_orders,参数是 customer: "Acme";响应仍用 id: 7 对应请求,返回订单 id: 101、total: 250。
这里有个容易踩坑的细节:示例订单并非直接返回的 JSON 对象,而是 content 数组中一段文本里的 JSON 字符串。
资源读取走另一套入口:resources/read 接收 URI,例如 orders://recent,返回包含文本或二进制数据的 contents。要发现服务能力,可以分别调用 tools/list 和 resources/list。
Node.js 代理解决了什么,又漏了什么
下面这段代理把工具调用收口到 Express 接口,并设置工具白名单:
import express from "express";
import { Client } from "@modelcontextprotocol/sdk/client/index.js";
import { StreamableHTTPClientTransport } from "@modelcontextprotocol/sdk/client/streamableHttp.js";

const client = new Client({ name: "web-proxy", version: "1.0.0" });
await client.connect(new StreamableHTTPClientTransport(new URL(process.env.MCP_URL!)));

const ALLOWED = new Set(["search_orders", "get_order"]);
const app = express();
app.use(express.json());

app.post("/api/tools/:name", async (req, res) => {
  if (!req.headers.authorization) return res.status(401).json({ error: "Sign in first" });
  if (!ALLOWED.has(req.params.name)) return res.status(403).json({ error: "Tool not allowed" });
  try {
    const result = await client.callTool({ name: req.params.name, arguments: req.body });
    if (result.isError) return res.status(422).json({ error: result.content });
    res.json(result.content);
  } catch (e) {
    res.status(502).json({ error: "MCP server unavailable" });
  }
});

app.listen(3000);
重点看 if (!req.headers.authorization):它只检查请求头存在,没有验证 token,也没有检查用户是否有权读取目标订单。作者正文要求检查会话、权限和参数,但示例没有完整实现。
白名单允许 search_orders、get_order,能缩小暴露范围,却代替不了业务授权。客户端配置中的 version: "1.0.0" 也是 web-proxy 的自报版本,不是 SDK 版本;原文没有给出 SDK 的具体版本。
React 示例则展示页面如何消费这个接口:
import { useState } from "react";

export function OrderSearch() {
  const [rows, setRows] = useState<any[]>([]);
  const [error, setError] = useState("");
  const [loading, setLoading] = useState(false);

  async function search(customer: string) {
    setLoading(true); setError("");
    try {
      const res = await fetch("/api/tools/search_orders", {
        method: "POST",
        headers: { "Content-Type": "application/json", Authorization: `Bearer ${localToken()}` },
        body: JSON.stringify({ customer }),
      });
      const data = await res.json();
      if (!res.ok) throw new Error(typeof data.error === "string" ? data.error : "Tool failed");
      setRows(JSON.parse(data[0].text));
    } catch (e: any) {
      setError(e.message);
    } finally {
      setLoading(false);
    }
  }

  return (
    <div>
      <button onClick={() => search("Acme")} disabled={loading}>Search Acme</button>
      {error && <p role="alert">{error}</p>}
      <ul>{rows.map(r => <li key={r.id}>#{r.id}: ${r.total}</li>)}</ul>
    </div>
  );
}
要留意 JSON.parse(data[0].text):它假设首个内容块一定是文本,且文本一定能解析成订单数组。这个约定来自示例,不能推广成所有工具的返回规则。localToken() 也没有实现;这里发送的应是应用侧身份凭据,MCP 凭据另留后端,原文未展示后者如何配置。
相同的 fetch 请求可以用于 Vue 或原生 JavaScript,组件状态和渲染方式则需各自实现。
错误与流式响应不能只靠一个 catch
作者把错误分成三层,这个划分比统一显示「请求失败」更有用:
- 传输错误包括网络中断和 HTTP 5xx,原文建议退避重试,并展示易懂的提示。
- JSON-RPC 错误通过带
code的错误对象表达,例如-32602是参数无效,-32601是未知方法,通常应记录并排查调用问题。 - 工具错误仍是正常返回结果,但带有
isError: true,例如找不到客户,适合反馈给用户。
示例把这些信息压缩了:工具错误映射成 422,调用异常统一映射成 502,浏览器未必能区分参数错误与服务不可用。因此,分层原则还需要落实到代理的错误映射中。
Streamable HTTP 还允许服务端通过 Server-Sent Events(SSE)在最终结果前发送进度通知。作者建议代理继续输出 SSE,前端用 fetch 加流读取器消费;GET 请求也可以使用 EventSource。
但示例只是对 /api/tools/long_report/stream 发起 POST,携带 "{}",然后通过 res.body.getReader()、TextDecoder 和 showProgress() 处理字节块。读到一块网络数据,不代表已经读到一条完整 SSE 事件。 原文没有补齐事件边界解析,也没有实现代理流接口。
此外还应使用 AbortController 设置超时,并在组件卸载时取消请求;取消浏览器请求是否会终止服务端工具执行,原文没有说明。
我的判断
我赞同把 MCP 放在后端、让前端保留普通接口的边界。对于已经有 MCP Server、又需要给 UI 暴露同一批能力的团队,这条路径有直接价值。
但作者没有提供延迟、吞吐量、维护成本或故障率的对照数据,也没有报告实测过程。因此,「推荐薄代理」是架构经验建议,不能据此认定它比普通业务 API 更快、更省事。
如果团队原本只有网页订单查询需求,直接建设业务 API 同样合理。增加 MCP 是否划算,取决于 Agent 是否确实需要复用这些能力。即使共用工具,用户权限、返回格式和错误约定仍然要单独设计。
能拿来做什么
- 已有 MCP 工具的团队,可以先挑一个订单查询类读取操作,用 Node.js 白名单代理接到页面,并在服务端完成会话验证、参数校验和数据权限检查。
- 前端接入时,应把示例中的文本结果解析收口处理,验证内容类型与订单字段,避免每个组件都依赖
data[0].text。 - 为传输失败、协议错误和业务失败定义可区分的返回信息,再补超时与卸载取消;重试前先判断工具是否适合重复执行。
- 只有长任务需要进度展示时,再实现完整 SSE 转发与解析;工具返回内容按不可信数据处理,不直接注入原始 HTML。