选编程智能体,先看模型能否自由切换
文章区分智能体 CLI 的运行框架与底层模型,前者负责工具调用、上下文、权限和会话。作者比较多款工具的模型供应商开放程度,指出工具选型可能提前决定后续换模型的成本。
AI 深度解读
装一个 AI 编程 CLI,你其实同时选了两样东西:负责读文件、调工具、跑测试的执行框架,以及框架背后的模型。作者的核心主张是:这两个决定应该分别考虑,否则下一次想换模型时,才发现要迁移的是整套集成。
文章值得读的地方,不是推荐哪款 CLI,而是把「支持多模型」拆成了可以检查的工程问题。不过,其中的产品状态来自作者标注的核查时间,案例也有实验性质,不能直接当成今天的产品选型结论。
你选的是模型,还是替你安排工作的框架
作者把模型外面的执行框架叫作 harness。模型负责根据输入生成回答,harness 则管理代理循环、工具、上下文、权限和会话,让模型能够连续完成「读仓库、改代码、跑测试、根据结果再修改」这一串动作。
Claude Code 与 Claude 就是这种关系:前者是执行框架,后者是里面的模型。
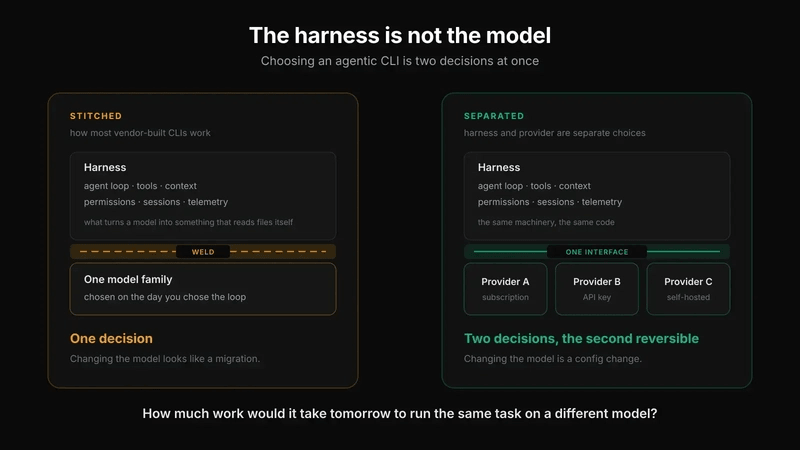
作者还区分了 Agent SDK、CLI、Client SDK 和 Managed Agents。它们回答的是「你拿多少现成的执行能力」,模型选择则是另一条轴。不能因为都带着 Agent,就把它们当成同一种产品。
据作者在 2026 年 9 月 1 日对八款工具文档的核查,Anthropic 和 Google 将框架与自家模型家族绑定;OpenAI、DeepSeek、Cline、Aider、OpenCode 和 Pi 则保留了供应商选择。文中举出的例子包括 OpenAI CLI 为 Ollama、LM Studio 留出接入位置。
这里最容易误读的是 Anthropic。作者列出的部署入口有六类,包括 Amazon Bedrock、Claude Platform on AWS、Google Cloud 的 Agent Platform 和 Microsoft Foundry,另外还有自托管网关。因此,用户可以选择基础设施、地域、账单和凭证,但受支持的模型仍属于 Claude 家族,opus、sonnet 别名不会因为换云就变成其他模型。
通过网关接入非 Claude 模型,技术上可以做到。文档允许模型名称字符串透传,但 Anthropic 明确不支持这种用法。它划的是支持边界,并非技术封锁。企业使用时,还要考虑其商业条款;Claude Agent SDK 的库仅提供 Python 和 TypeScript,其他语言需要把 CLI 当作子进程调用。
能换接入地址,不等于能在官方支持范围内换模型家族。
Pi 和 DeepSeek 的案例证明了什么
Pi 把几层能力拆成独立包:pi-ai 统一供应商接口,pi-agent-core 提供代理循环与工具调用,pi-coding-agent 提供 CLI,pi-tui 负责终端界面,pi-telemetry 定义供应商中立的遥测契约。
作者记录,earendil-works/pi 创建于 2025 年 8 月,核查时有 100,481 个 stars,采用 MIT 许可。Mario Zechner 是最初作者;项目于 2026 年 4 月 8 日宣布归入 Earendil,他与 Armin Ronacher、Colin Daymond Hanna 共同参与决策。热度和作者背景可以解释关注度,却不能代替工程验证。
更具体的证据来自 DeepSeek Harness。它于 2026 年 8 月 13 日开放,采用 MIT 许可和插件架构。其中的 @deepseek-ai/dsh-llm-pi-ai 通过 @earendil-works/pi-ai 接入多个供应商,依赖版本为 ^0.84.2。对于目录中没有的模型路由,可以手工声明,把 OpenAI-compatible 网关或自托管服务的接入变成配置工作。
但这个适配包自身只有 0.1.2-alpha.4,定位是验证设计的实验版本,并非默认生产路径。它证明了分层接口确实被使用,尚不足以证明整套方案成熟、稳定或迁移成本更低。
作者还纠正了一个传播中的说法:OpenClaw 并没有通过 pi-agent-core 的 createAgentSession() 嵌入会话,它使用的是自己实现的同名函数,实际携带的 Earendil 包只有 pi-tui。第三方声明承认部分代码改编自 Pi,但这与直接复用代理运行时是两回事。
换模型为什么会牵动五层代码
最有用的部分,是作者列出的迁移清单。接口字段看起来相似,协议却不完全相同。
第一层是请求。Anthropic 使用 /v1/messages,OpenAI 使用 /v1/chat/completions 或 /v1/responses,Gemini 把模型名放进 URL 路径,流式调用另有方法。输出长度限制也分别叫 max_tokens、max_completion_tokens、max_output_tokens 或 generationConfig.maxOutputTokens。
第二层是工具协议。工具参数在 Anthropic 里叫 input_schema,在 Chat Completions 中放在 function.parameters,Responses 又将结构展开,Gemini 则使用 tools[].functionDeclarations[].parameters,接受的是选定的 OpenAPI 子集。
工具执行结果更不能直接搬:Anthropic 使用用户消息中的 tool_result 和 tool_use_id;Chat Completions 使用 role: tool 和 tool_call_id;Responses 使用 function_call_output 和 call_id;Gemini 使用带函数名的 functionResponse,没有 tool 角色。
第三层是上下文。系统指令分别位于 system 参数、system 或 developer 消息、instructions 字段,以及 systemInstruction 对象。推理过程还可能带着供应商签发的不透明数据:signature、encrypted_content、thoughtSignature。这些内容需要按原样回传给签发方,不能期待另一家模型接着使用。
第四层是权限表达。要求模型调用工具,分别写成 tool_choice: {"type": "any"}、tool_choice: "required" 和 toolConfig.functionCallingConfig.mode: "ANY"。Gemini 还有 VALIDATED 模式及逐请求安全设置,无法简单一一对应。团队「哪些操作必须经人批准」的规则可以保留,编码进请求的方式需要调整。
第五层是遥测。Anthropic 的输入总量需要合计 input_tokens、cache_creation_input_tokens 和 cache_read_input_tokens;Google 与 OpenAI 的 prompt 总量已经包含缓存命中。只把 prompt_tokens 重命名为 input_tokens,可能得到能显示、却算错用量和费用的看板。
pi-ai、LiteLLM 可以吸收不少格式转换。LiteLLM 宣称统一返回 OpenAI Chat Completions 格式,但作者提到,含 $ref、anyOf 的工具 schema,以及推理块的保留,都曾出现适配问题。
请求格式统一,只解决了接通;任务行为是否一致,仍然要靠评测。
我的判断
我认同作者把迁移成本拆开估算的做法。相比笼统地问「支不支持多模型」,检查工具回传、上下文续接、权限和计费口径,更接近真实项目。
但文章没有给出迁移工时、成功率、延迟或维护成本的对照数据。关于拆分能节省多少工作,仍属于架构推论和案例经验。原文还称模型是 Agent 报价中最便宜的一项,也没有提供足以推广到一般团队的成本明细。
统一适配层与原生 SDK 各有代价。前者减少重复集成,同时增加依赖和调试层次,新能力也可能接入较晚;后者更容易直接使用供应商功能。团队已经确定长期使用一个模型家族时,选择配套 harness 完全合理,没必要为了可能发生的迁移提前建设一套平台。
时间边界也要看清。文章先说核查发生于 9 月 1 日,后面又加入 9 月的 Codex harness 服务化,以及 9 月 30 日 Gemini 4 Argon 的内容。文中提到 Argon 在表格的 19 项中领先 13 项,并与 GPT-6 Astra、Claude Opus 5.5 比较,却没有展开基准方法。这些后续描述不应都归入同一次核查,更不能据此替自己的任务选模型。
能拿来做什么
- 给现有 AI 编程流程补一页迁移清单,按请求、工具、上下文、权限、遥测五层,写明替换模型会改哪些代码、预计花多少天,并定期更新。
- 为仓库改码流程保留一组可重复任务,让候选模型完成相同的文件修改和测试,再检查工具调用、失败恢复与人工审批是否符合要求。
- 在 Node 或 TypeScript 项目引入统一适配库前,先验证实际使用的 schema、推理状态续接和缓存计费,别把一次普通对话成功当成 Agent 接入完成。
- 如果已经决定使用 Claude 家族,就把支持范围和部署入口写进项目文档;若依赖网关接入其他模型,也要明确记录这是官方不支持的配置。