AI SDK 7 升级中自动迁移漏掉的坑
一次真实应用迁移显示,自动脚本处理了接口改名,却只修复九个失败测试中的一个,剩余问题涉及用量统计、流事件和消息行为。文章还列出 Node.js 版本要求及遥测迁移步骤,提醒类型检查无法覆盖这些变化。
AI 深度解读
AI SDK 7 升级最容易误判的地方,是把「代码还能编译」当成「业务行为没变」。作者把一个模拟 Next.js 聊天产品的应用从 v6 升到 v7,codemod 用约 20 秒改了 15 行,却只修好 9 个失败测试中的 1 个。
剩下的问题集中在工具上下文、token 统计、聊天记录保存和链路追踪。对维护 AI 应用的前端与全栈开发者,这篇实测的价值是指出:哪些地方必须靠业务断言验收,不能交给自动改名。
自动迁移能改名字,改不了业务含义
作者使用 node:test 和 SDK 的 MockLanguageModelV3 编写了 13 个离线、确定性测试,覆盖工具循环、流式响应、结构化输出、历史聊天和 CommonJS 脚本。它们在 v6 上全部通过,TypeScript 也没有报错。
测试版本是 ai 6.0.309 → 7.0.143、@ai-sdk/openai 3.0.130 → 4.0.96、@ai-sdk/react 3.0.312 → 4.0.147,搭配 @ai-sdk/codemod 4.0.3、TypeScript 5.9.3、Node 24.22。原文称 AI SDK 7.0 于 2026 年 6 月 25 日发布,以下数字都应放在这组版本里理解。
运行环境先过门槛:v7 要求 Node.js 22+,移除 Node 18、20 支持,包只提供 ESM。作者建议使用 Node 24 LTS。不过,ESM-only 不等于 require('ai') 必然失败,作者的 Node 24 借助原生 require(esm) 仍能加载它。
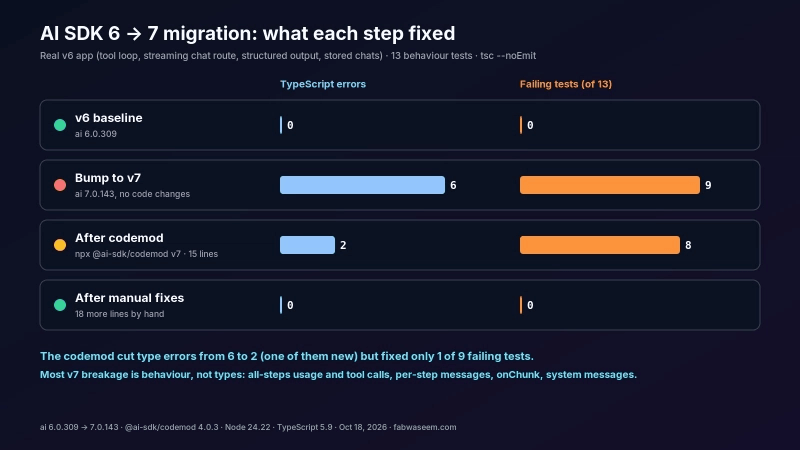
提交当前代码后,升级命令是 npm i ai@7 @ai-sdk/react@4 @ai-sdk/openai@4,其他 provider 也要同步升级。仅更新依赖,就出现了 6 个类型错误,13 个测试失败了 9 个。
接着执行 npx @ai-sdk/codemod v7 src test,耗时 19.8 秒,在 4 个文件里修改了 15 行,包括:
system → instructions、stepCountIs → isStepCount。onFinish → onEnd、onStepFinish → onStepEnd。experimental_telemetry → telemetry、experimental_output → output。usage.cachedInputTokens → usage.inputTokenDetails.cacheReadTokens。ToolCallOptions → ToolExecutionOptions。
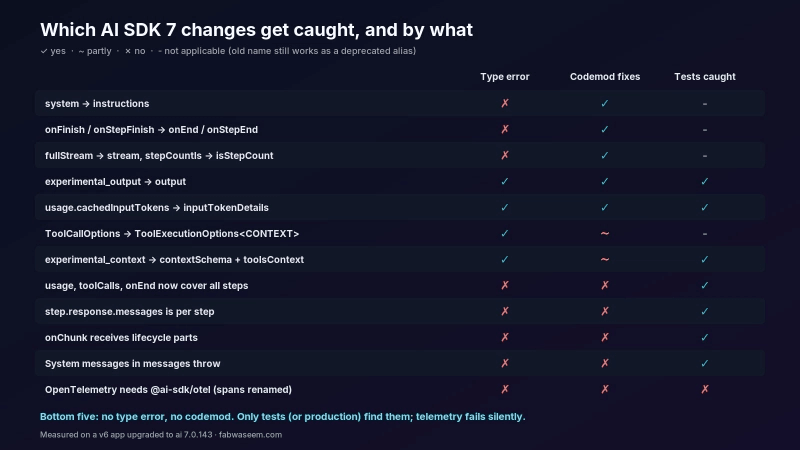
结果仍有 2 个类型错误、8 个测试失败。ToolExecutionOptions 需要泛型参数,调用处的 experimental_context 也没有自动迁完。许多旧名称还保留为弃用别名,因此编译通过也无法证明迁移结束。
为什么工具坏了,聊天还能正常回答
最危险的失败来自工具上下文。
v6 的天气工具读取 experimental_context。升级后取不到值,解构 units 时抛错,SDK 却把异常转成工具错误结果继续交给模型。作者的 mock 模型照样生成正常答案,于是「工具循环能回答」的测试通过了。
接口返回答案,只能证明生成流程走完,不能证明工具成功执行。
v7 要给每个工具声明 contextSchema,再通过按工具名组织的 toolsContext 传值。共享运行时数据则另有 runtimeContext。下面这段解决的是工具到底能收到什么:
export const weather = tool({
  inputSchema: z.object({ city: z.string() }),
  contextSchema: z.object({ units: z.enum(['c', 'f']) }),
  execute: async ({ city }, { context: { units } }) => getWeather(city, units),
})

await generateText({
  model,
  tools: { weather },
  toolsContext: { weather: { units: 'c' } },
  // ...
})
重点看 toolsContext: { weather: ... }:工具定义和调用处必须一起改,不能只调整 execute 的解构名称。
接下来是返回值语义。作者的两步工具循环中,result.usage.totalTokens 从 15 变成 30,缓存输入 token 从 4 变成 8。原因是 v7 的 usage 汇总所有步骤,v6 在这里返回最后一步。
这不是模型突然多消耗了一倍 token。
要保留旧口径,读取 result.finalStep.usage;onEnd 中对应使用 event.finalStep.usage。totalUsage 已弃用。如果代码已经逐步累加,又加一次新的汇总值,就会重复计数。
toolCalls、toolResults、content、files、sources、warnings 同样改为跨步骤汇总。作者的 result.toolCalls.length 从 0 变成 1,因为工具调用发生在第一步。只取末步应使用 result.finalStep.toolCalls。
聊天记录也要核查。v6 最后一步的 step.response.messages 包含完整交换,共 3 条消息;v7 这里只剩当前步骤的 1 条。保存整轮对话应改用 result.responseMessages。
流式处理则多了一类风险:onChunk 从收到 2 个 text-delta,变成收到 8 个事件,包含 start、start-step、text-start、text-end、finish-step、finish。处理文本前必须检查 chunk.type。fullStream 改名为 stream;旧的 result.toUIMessageStreamResponse() 仍可用但已弃用,无状态替代写法是 createUIMessageStreamResponse({ stream: toUIMessageStream({ stream: result.stream }) })。
历史聊天里的 system 消息也会触发变化:v6 警告,v7 抛出 AI_InvalidPromptError。作者将它们提取到 instructions,其余消息留在 messages。allowSystemInMessages: true 只适合消息全部来自可信服务端代码的情况,不能直接拿来放行用户数据。
为什么测试全绿,追踪仍可能消失
作者在相同 4 个文件里额外修改了 18 行,恢复到零类型错误、13 个测试全部通过,也没有弃用警告。但这组测试没有发现 OpenTelemetry 已经停止记录。
单独使用内存 exporter 验证后,结果是:
- v6 启用
experimental_telemetry: { isEnabled: true },记录 2 个 span。 - v7 沿用配置,记录 0 个,没有错误或警告。
- v7 安装
@ai-sdk/otel 1.0.143并注册集成后,记录 3 个 span。
Next.js 可以在 instrumentation.ts 中注册:
import { registerTelemetry } from 'ai'
import { OpenTelemetry } from '@ai-sdk/otel'

registerTelemetry(new OpenTelemetry())
关键是 registerTelemetry(new OpenTelemetry()),只保留 telemetry 配置不够。注册后默认追踪所有调用,需要排除时设置 isEnabled: false。
监控查询也要跟着改。旧名称是 ai.generateText、ai.generateText.doGenerate,新测试中变成了 invoke_agent mock-model-id、chat mock-model-id 和 step 1。只盯着旧名称,仪表盘仍可能空白。
作者没有实测的其他变化,也应按项目用法检查:prepareStep 返回的 instructions、messages 会延续到后续步骤;请求与响应 body 默认不保留,读取 result.request.body 需设置 include: { requestBody: true };createMCPClient 的 HTTP、SSE 传输默认 redirect: 'error',允许重定向需显式设为 redirect: 'follow'。
此外,needsApproval 改用调用级 toolApproval,图片部分改为 { type: 'file', mediaType: 'image', data };xAI 默认使用 Responses API,OpenAI 开启 reasoning 时摘要默认 'detailed',Google 的 createGoogleGenerativeAI 改名为 createGoogle。
我的判断
我认同作者把验收重点放在业务行为上。类型系统可以检查字段形状,却无法替团队决定:账单需要全步骤用量,还是末步用量;持久化需要当前步骤,还是整轮对话。这些决策必须写进断言。
不过,这是一套小型模拟应用的迁移实验。离线 mock 让数据可复现,也限制了结论范围。工具出错后真实模型会道歉还是猜测,原文没有实测;其他 provider 和生产部署链路也没有被这 13 个测试覆盖。
性能数据同样只能窄读:安装体积从 23.8 MB、18 个包变成 24.3 MB、26 个包,ai 自身体积从 7.2 MB 增至 8.2 MB。hyperfine 各跑 30 次,导入耗时从 113.5 ms 到 115.4 ms,空 Node 脚本为 23.8 ms。它支持「该环境下导入耗时接近」,不能推导出前端 bundle 或聊天响应性能不变。
相比全靠手改,codemod 适合先清理机械改名。作者还建议用 npx skills add vercel/ai --skill migrate-ai-sdk-v6-to-v7 安装迁移 skill,再让 coding agent 检查语义变化。原文没有提供两种流程的对照数据,它的效率优势仍是经验判断,最终要审查 diff 和验证结果。
能拿来做什么
- 升级前先固定工具入参、执行结果、token 口径和保存消息的断言,避免只测试聊天接口能返回文本。
- 给计费、限流、日志逐一确定统计范围,再选择
usage或finalStep.usage,同时检查是否与逐步累加重复。 - 在 Next.js 聊天路由中检查
onChunk类型分支、历史 system 消息和responseMessages,验证刷新页面后能否还原完整对话。 - 把追踪单独作为验收项:注册
@ai-sdk/otel后确认实际产生 span,并更新依赖旧名称的查询与告警。