Agent 上下文该放内存节点还是状态库
文章讨论有状态与无状态设计如何影响 AI Agent 的上下文记忆和系统扩展,并说明何时使用记忆节点、状态存储或两者结合。
AI 深度解读
AI Agent 能接着上一轮聊下去,不代表模型自己记住了对话。n8n 这篇文章讨论的是:历史消息、任务进度和业务数据应该存在哪里,才能兼顾连续交互、扩容和故障恢复。
作者给出的建议是先让执行过程保持独立,再把需要延续的信息放进合适的存储层。对正在搭建 AI 工作流的程序员来说,最有用的不是选边站,而是分清哪些信息只服务于当前对话,哪些必须跨进程、跨执行保留下来。
Agent 的记忆,到底是谁在保存
先拆开三个容易混用的概念。
状态(State)是一次交互结束后仍然存在的信息,比如登录状态、购物车和聊天记录。会话(Session)负责划定边界,告诉系统哪些交互属于同一个用户或同一段流程。上下文(Context)则是模型处理当前请求时实际拿到的信息,可以包含当前输入、历史消息和从存储中取出的资料。
三者相关,但不是一回事。数据库里保存了一百条消息,不代表模型这一轮已经读到了它们;同一个用户发来的请求,也未必应该归进同一段会话。
原文强调,LLM 不会自动在两次推理请求之间保留对话。应用想让模型参考过去,就得重新提供相关消息,或者从其他系统取回信息后加入输入。
Agent 表现得有记忆,靠的是模型之外的存储与检索。
这也解释了为什么聊天界面能连续追问,而背后的每次模型调用仍然可以独立执行。界面上的连续性,是应用拼出来的。
保存方式取决于信息要活多久,以及谁需要读取它。进程内的内存缓冲区可以保存近期消息;需要跨重启保留时,要用持久化存储;多个执行节点共同处理请求时,还需要它们都能访问的共享存储。
无状态执行,为什么还能支持连续对话
有状态应用会保留先前交互的信息,并据此处理后续请求。好处是能够接着上次的进度继续,代价是必须管理状态的存放位置,并保证下一次请求能拿到它。
无状态应用则独立处理每个请求。所需信息要么随请求传入,要么由本次请求从其他系统获取,不能依赖上一个请求留在当前实例里的临时数据。
这里最容易误解:无状态不等于整个系统没有数据库,也不等于每轮对话都要从零开始。
例如,一个处理请求的实例从共享存储读取聊天记录,完成推理后再写回结果。下次请求即使被分配到另一个实例,也能继续对话。连续性来自共享状态,处理实例本身无需一直绑定这段会话。
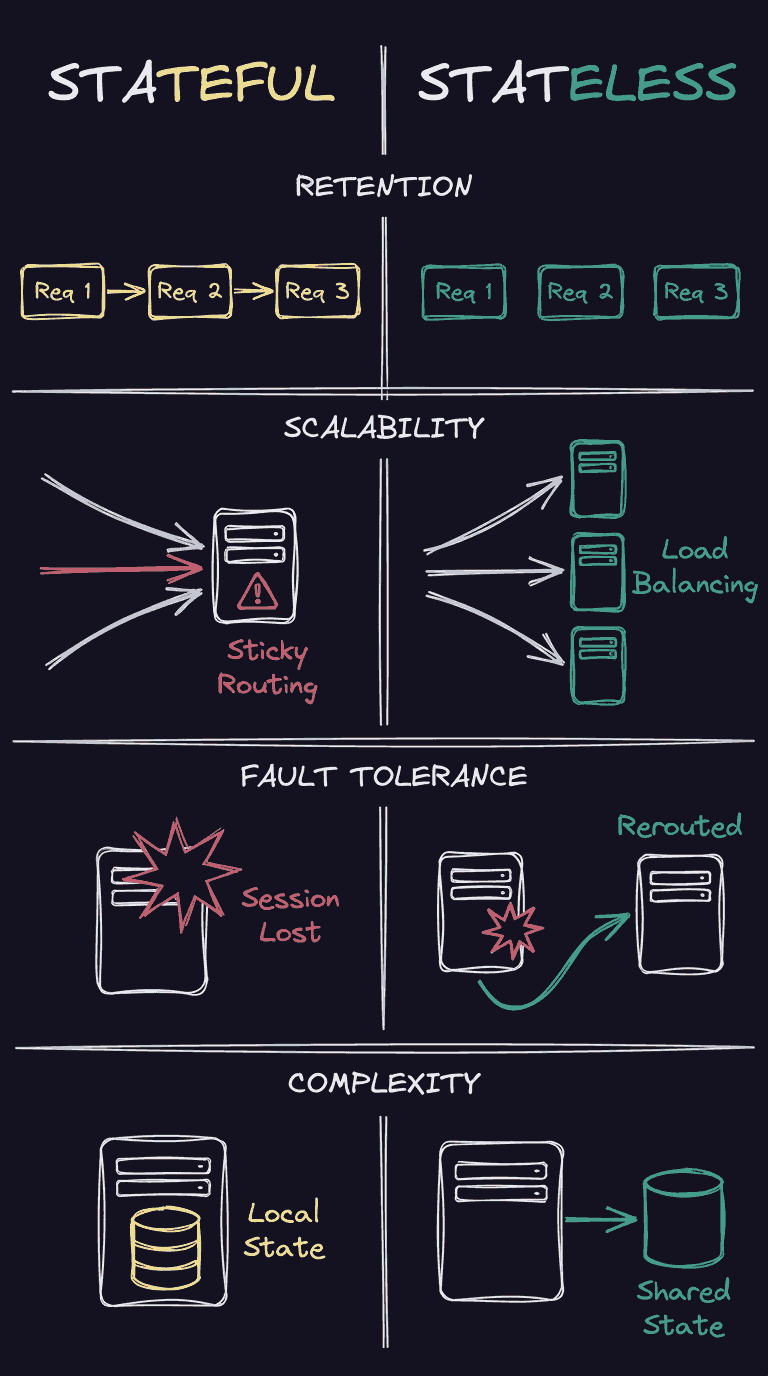
原文把 REST API 作为无状态请求的例子:每次请求都包含认证和处理所需的信息,因此更容易分发到多个实例。对于对话、多步骤流程,以及聊天、游戏等实时交互,作者认为有状态行为更适合维持连续性,并列举了基于 session-cookie 的认证 API、FTP API 等场景。
这些例子适合帮助理解,但不能直接拿协议或交互形式给整个系统定性。实时连接如何维持,与业务状态是否保存在当前实例,是两个需要分别回答的问题。
无状态处理层的主要收益是减少实例之间的绑定关系。它并没有消除状态管理,只是把责任移到了数据库、缓存或其他共享系统里。原文也没有给出扩容倍数、故障恢复时间或资源消耗的对照数据,因此这里讲的是架构取舍,不是性能实测结论。
在 n8n 里,聊天记录和业务数据要分开存
n8n 的每次 workflow execution 都是独立的,前一次执行的数据不会自动变成下一次执行的记忆。需要连续性时,开发者必须显式加入状态。
原文把这件事分成两层:Memory nodes 保存 Agent 使用的对话上下文,state stores 保存跨执行延续的工作流和应用数据。二者的区别在于用途,不能简单理解成前者全是临时存储、后者才支持持久化。
对话层有几个具体选择:
- Simple Memory 使用进程内缓冲区保存近期对话,但不兼容 queue mode。
- Postgres Chat Memory 使用持久化存储,通过 session ID 区分不同会话。
- Redis Chat Memory 可以让多个 worker 共享会话状态,适用于需要快速分布式缓存的情况。
- Chat Memory Manager 允许工作流显式加载、插入和清空消息,适合需要更细控制的场景。
其中最明确的部署约束是 queue mode。任务可能由不同 worker 执行时,不能指望某个进程的本地缓冲区始终可用;原文建议选择持久化 memory,让各个 worker 能访问会话状态。
另一层是业务与流程数据。某个信息需要跨会话保留,或者供多次工作流执行共同读写时,n8n data tables 提供持久化、结构化存储。原文还列出了 workflow static data、外部 Postgres 和 Redis,但没有详细说明它们各自的容量、并发或持久化配置边界。
因此,选了 Redis 也不能直接推导出重启后一定不丢数据,选了某种存储也不能自动获得完整的故障恢复能力。这些仍要结合实际配置判断。
n8n 的 execution history 则提供另一种帮助:查看每次执行流经的数据,便于定位状态从哪里读取、在哪一步发生变化。它提供的是排查线索,不能替代业务状态存储。
我的判断
我赞同作者把问题从「选有状态还是无状态」改成「哪些状态应该放在哪一层」。这比给整个系统贴一个标签更有用,也更适合逐步增加能力的 AI 工作流。
对于只跑在单个进程里的原型,内存保存近期消息确实省事。需要重启后继续、多 worker 执行,或者让多个工作流共享数据时,再引入相应存储,有明确的需求依据。
但这篇文章是一份选型入门,没有提供生产可靠性的完整设计,也没有展示团队实验。它未讨论并发请求如何更新同一会话、失败重试如何避免重复写入、历史消息如何裁剪,以及业务数据保存多久。不能把「增加持久化 memory」直接当成这些问题都已解决。
和把全部历史消息随请求传入相比,外部存储有利于集中管理,但会增加读取、写入和可用性方面的依赖;和把状态留在单个实例相比,共享存储更方便跨实例协作,却仍需要处理一致性与故障。原文没有给出这些方案的成本对照,推荐方向应当视为架构经验,而非已经证明的最优解。
无状态基础让执行更容易替换,可靠性仍取决于状态层怎么设计。
能拿来做什么
- 给现有 AI 对话功能列一份状态清单,分别标出当前输入、会话历史和跨会话业务数据,再检查每项信息的实际存放位置,避免把聊天记录当成所有数据的容器。
- 在 Node 服务中检查是否把会话历史只放在进程内;准备增加实例或引入 worker 时,先确认新实例能否读取同一会话,以及进程重启后需要恢复哪些信息。
- 用 n8n 从单进程部署切换到 queue mode 前,检查是否使用 Simple Memory;根据恢复与共享需求选择 Postgres Chat Memory、Redis Chat Memory 等方案,并验证 session ID 能否正确区分会话。
- 调试 Agent 忘记前文时,沿着「是否保存、是否取回、是否加入当前模型输入」逐步排查;在 n8n 中结合 execution history 查看实际流经的数据,再判断问题出在模型还是工作流。