微软用专用语言让智能体生成交互图表
微软研究院介绍 Flint-interactive,为 AI 智能体创建交互式数据可视化提供专用语言。生成的视图支持点击筛选、关联高亮和进一步探索数据。
AI 深度解读
AI 能画出图,离「图能用来探索数据」还有一段距离。框选一批国家,让另一张图同步高亮;点击表格,让散点图标出对应位置,这些交互往往比生成图表本身更难。
Microsoft Research 的 Flint-interactive 想把这部分工作交给编译器:用户或 Agent 描述选中了什么、希望怎样更新,系统负责处理底层视觉变化。它值得关注的地方,是给 AI 生成交互图表提供了一套更高层的表达方式。不过,原文展示了能力,没有给出成本和可靠性的量化对照。
为什么交互图表需要一门更高层的语言
静态图表替读者选好了观察角度,交互图表则允许读者继续追问:这一组数据有什么共同点?换一个年份还成立吗?图里的异常点对应报告中的哪段描述?
要支持这些问题,Agent 不能只生成坐标轴和数据点,还要处理选择状态、跨图关联、缩放以及文字联动。原文指出,即使使用能力较强的前沿模型,生成满意结果也常常需要多轮推理、编码和调试,消耗 token 和时间;修复某个交互,还可能引入新的布局或行为问题。
一些可视化库自带的交互,也未必足以表达定制需求。单图缩放容易,跨视图、跨组件的业务行为就复杂得多。
Flint-interactive 建立在 Flint 之上,用高层规格描述交互,把视觉依赖的处理交给编译器。它的基本思路可以概括为:让 Agent 描述数据上的意图,由系统落实画布上的变化。
例如,预设交互 linked-brush 可以让两张散点图联动。原文用 1952 年和 2007 年的国家数据演示:横轴是人均 GDP,纵轴是预期寿命,颜色区分洲别。在 1952 年的图里框选一组国家,2007 年的图会高亮相同国家,方便比较它们跨年的位置变化。
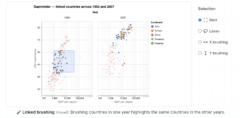
这里真正需要表达的是「关联这些国家」。至于选框碰到了哪些点、哪些图形应改变样式,都属于系统需要处理的视觉细节。
语义事件怎样把点击变成数据操作
Flint Canvas 是一个状态机,负责跟踪画布上的用户交互,并管理视觉渲染状态。Flint-interactive 将工作分成了两部分。
第一部分是视觉逻辑,由编译器管理。点击、拖拽、按键等原始触发,会被解析为包含图表元素和数据信息的语义事件(semantic events)。系统也负责命中检测,以及将更新操作落实为画布变化。
第二部分是交互逻辑,由用户或 Agent 指定:收到什么语义事件,执行哪些更新操作。
大白话解释,底层收到的是鼠标动作,上层需要知道的是「用户选中了哪个国家」。开发者拿到后者,才能直接编写数据层面的行为。
原文列出的更新操作包括:用 set style 高亮数据,用 set annotation 标注数据点,用 set viewport 平移或缩放视图。在定制交互的例子中,set-style 和 set-annotation 可以组合使用,让被点击的国家同时高亮并显示名称,无需直接操作特定渲染器的图形元素。
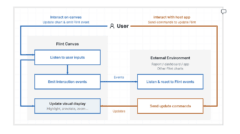
这套分工对维护也有意义。开发者描述的是「某组数据应该高亮」,不必亲自追踪它最终对应哪些图形,再逐个修改。
不过,复杂依赖并没有消失,而是由 Flint 的编译器和运行时承接。能否覆盖实际业务里的交互,仍取决于语义事件和更新操作的表达范围。
从聊天里的图,到应用里的双向联动
原文提供了三种使用路径,分别对应直接使用、应用集成和定制交互。
在聊天或 canvas 环境中,可以通过 Flint-MCP 和 MCP Apps 使用 Flint Interactive。按原文描述,在最新 release 中,用户告诉 Agent 要画什么、需要什么交互,Agent 就能在 Flint chart spec 之外生成 interaction_spec,并在对话里渲染交互图表。用户还可以通过选择数据,把上下文传给后续轮次。
这里的用途很直接:先选中一组点,再围绕选中数据继续提问。原文没有给出具体版本号,也没有展开不同聊天客户端的支持情况。
在独立应用中,Flint Interactive Canvas 可以连接图表以外的元素。应用通过 event handlers 接收语义事件,用它过滤表格、更新其他图表或修改应用状态;反过来,外部 widgets 也可以向 Flint Canvas 发送 update operators,控制图表更新。
原文的 2007 年 Gapminder 示例中,点击表格里的 United States,散点图会高亮对应气泡,并显示人均 GDP 为 $42,952、预期寿命为 78.2 年的标注。图表横轴使用对数刻度,气泡大小表示人口,颜色表示洲别。选择也可以从图表传回表格。
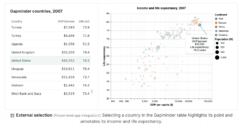
超出预设的需求,则通过 programming API 定义 trigger 和自定义 handle 函数,将语义事件映射为一组图表更新。
DimpVis 示例展示了更复杂的时间探索:用户沿城市的季节轨迹拖动数据点,所有城市同步切换到对应月份。图中包含 Chicago、Houston、Los Angeles、New York 和 Seattle,横轴为温度,单位 °C,纵轴为降水量,单位 mm/day。
Seattle 的轨迹从 January 延伸到 December,冬季降水接近 6 mm/day,夏季低于 1 mm/day。示例选中的 January 对应温度 4.2°C、降水量 5.7 mm/day。这个交互把「切换月份」放进了数据轨迹本身,读者可以边拖动边观察变化。
我的判断
我认同它对抽象层的选择。对于 AI 编程,直接生成底层事件和渲染代码,需要同时保证数据关系、坐标转换、选择状态和视觉更新正确。收敛为语义事件与更新操作后,Agent 要负责的事情更集中,也更容易形成可复用的预设。
但原文对「更可靠」「更省开发成本」的论证,主要来自设计解释和功能演示。它没有提供任务成功率、token 消耗、生成耗时或调试轮数,也没有给出与其他可视化方案的同题对照。
可以认可这套设计的合理性,暂时不能把收益当成已经量化验证的结论。
它的适用前提也很明确:团队愿意接入 Flint,并且业务需求能被它的规格、事件与操作表达。原文没有说明数据规模上限、运行性能、移动端体验或无障碍支持,这些都需要项目自行验证。
和直接使用图表库的内置交互相比,Flint-interactive 更吸引人的地方是跨图、表格、文本与应用状态的组合能力。如果需求只是单图缩放或提示框,现有方案已经满足,迁移收益未必明显。反过来,如果团队正在让 Agent 批量生成可探索的数据报告,这种统一表达方式就更有评估价值。
能拿来做什么
- 如果你在做聊天式数据分析,可以先验证「生成图表、选择数据、带着选择继续提问」这一条完整流程,检查 Flint-MCP、MCP Apps 和所用客户端能否顺畅配合。
- 如果你在做前端数据看板,可以用一张图和一张表测试双向联动:图表事件更新表格选择,表格操作再驱动画布高亮,重点检查两边状态是否一致。
- 如果 Agent 经常生成复杂的图表交互,可以先选一个重复出现的需求,尝试用
interaction_spec或预设表达,再与现有生成方式比较返工次数和实际成本。 - 如果确实需要定制交互,可以先用 programming API 将高亮与标注组合起来,验证事件和更新操作是否够用,再考虑更复杂的时间拖拽,并将稳定行为整理成可复用预设。