用 Supabase 搭建自动向量化笔记搜索
教程串起 pgvector、pgmq、定时任务与两个 Edge Functions,实现笔记入库后自动生成向量及语义检索。示例使用内置 gte-small 模型和简单 HTML 页面,作者称已在免费套餐中完整验证。
AI 深度解读
用「怎么添加同事」搜出「新员工账号在管理后台创建」,靠字面匹配很容易落空。作者用 Supabase 内置模型、Postgres 向量检索和任务队列,搭了一条从保存笔记到按语义搜索的完整链路,还接上了一个无需构建的 HTML 页面。
它的价值是把检索能力做成了能运行的小应用,也展示了失败边界:7 个改写问题中,6 个把正确笔记排在第一;但无关问题、否定表达和长文本都可能出错。读这篇最值得带走的,是实现路径,以及这些结果为什么还不足以支撑生产使用。
一条笔记如何自动变成可搜索的数据
作者把系统拆成两条路径:写入时异步生成嵌入向量(embedding),搜索时即时生成问题向量,再到数据库里找距离最近的笔记。向量可以理解为模型给文本生成的一组数字,用来比较内容是否接近。
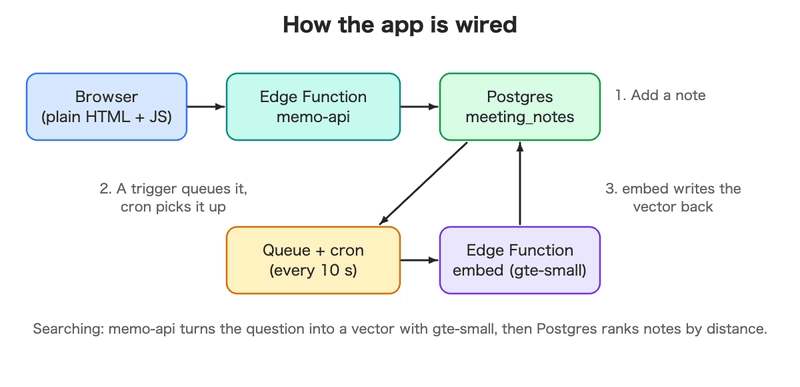
数据库需要四个扩展:vector 存储向量,pgmq 管理队列,pg_net 发起 HTTP 请求,pg_cron 定时执行任务。public.meeting_notes 保存标题、正文和类型,kind 只允许 meeting、interview,向量字段是 extensions.vector(384),并创建使用 extensions.vector_cosine_ops 的 HNSW 索引。
这里的 384 来自内置 gte-small:每段文本生成 384 个数字。embed 通过 Supabase.ai.Session("gte-small") 处理标题与正文,参数为 mean_pool: true, normalize: true,数据库连接使用 postgresjs@v3.4.5 和 SUPABASE_DB_URL。无需另接外部 AI 服务,但仍有平台调用额度。
插入笔记,以及更新 title、content,都会向 embedding_jobs 队列写入笔记 ID。下面的调度代码负责把任务交给 embed:
create function util.process_embeddings() returns void language plpgsql as $$
declare job record;
begin
  for job in select * from pgmq.read('embedding_jobs', 60, 10) loop
    perform net.http_post(
      url => 'https://<PROJECT_REF>.supabase.co/functions/v1/embed',
      headers => jsonb_build_object('Content-Type', 'application/json'),
      body => jsonb_build_object('id', (job.message->>'id')::bigint, 'jobId', job.msg_id));
  end loop;
end; $$;

select cron.schedule('process-embeddings', '10 seconds', 'select util.process_embeddings();');
重点看 pgmq.read('embedding_jobs', 60, 10):每次最多读取 10 个任务,读取后隐藏 60 秒。embed 写回向量之后,才调用 pgmq.delete 删除任务;如果前面失败,任务会重新出现。这是原文提供的全部重试机制,没有展示重试上限或失败任务处理。
作者的 8 条样本笔记在首次检查后的 15 秒内全部生成向量;页面新增笔记的一次测试约用了 8 秒。它们是运行观察,不能当成延迟保证。
搜出三个结果,为什么不代表找到了答案
查询端使用相同模型和参数生成问题向量,再让 Postgres 排序。下面这段实现了完整的近邻查询:
const sql = postgres(Deno.env.get("SUPABASE_DB_URL")!);
const session = new Supabase.ai.Session("gte-small");

Deno.serve(async (req) => {
  const { query } = await req.json();
  const embedding = JSON.stringify(Array.from(await session.run(query, { mean_pool: true, normalize: true })));

  const results = await sql`
    select id, kind, title,
           round((1 - (embedding <=> ${embedding}::extensions.vector))::numeric, 3) as similarity
    from public.meeting_notes
    where embedding is not null
    order by embedding <=> ${embedding}::extensions.vector
    limit 3`;

  return Response.json({ query, results });
});
要看清最后的 limit 3:它只负责返回最接近的三条,没有判断是否相关。<=> 是余弦距离,代码用 1 - distance 展示相似度,并保留三位小数;这个分数不是答案正确的概率。
作者准备了 5 条会议纪要、3 条面试笔记。7 个改写问题中,6 个把正确笔记排第一;剩下一个问题的正确笔记排第二,分数为 0.789,与第一名只差 0.002。「添加同事」的查询则命中新员工入职笔记,分数为 0.843。
对照实验中的六组子串查询全部零命中。不过,这证明了样例里语义检索能跨越措辞差异,还不能证明它优于完善的关键词搜索。 笔记和问题都由作者编写,数据只有 8 条,对照也没有覆盖全文检索等方案。
失败样例更能说明产品边界。无关问题「best pizza in town」仍得到 0.703,并返回三条笔记;询问「不想远程工作的候选人」,反而把询问过远程工作的人排第一,分数达到 0.869。
作者试过的分数集中在 0.70 至 0.92。约 0.80 的阈值碰巧能区分这批样本里的正确结果与错误结果,但作者也明确表示,不信任用自己的测试集调出的阈值。
页面容易接起来,内容和权限更容易踩坑
页面使用普通 HTML、JavaScript,通过额外的 memo-api 处理 list、search、keyword、add、status。因此完整应用涉及三个 Edge Functions:embed、search、memo-api。
把 app/config.example.js 复制为 app/config.js,填入项目 URL 和 publishable key 后,执行 cd app、python3 -m http.server 8765 --bind 127.0.0.1,即可打开 http://127.0.0.1:8765/index.html。
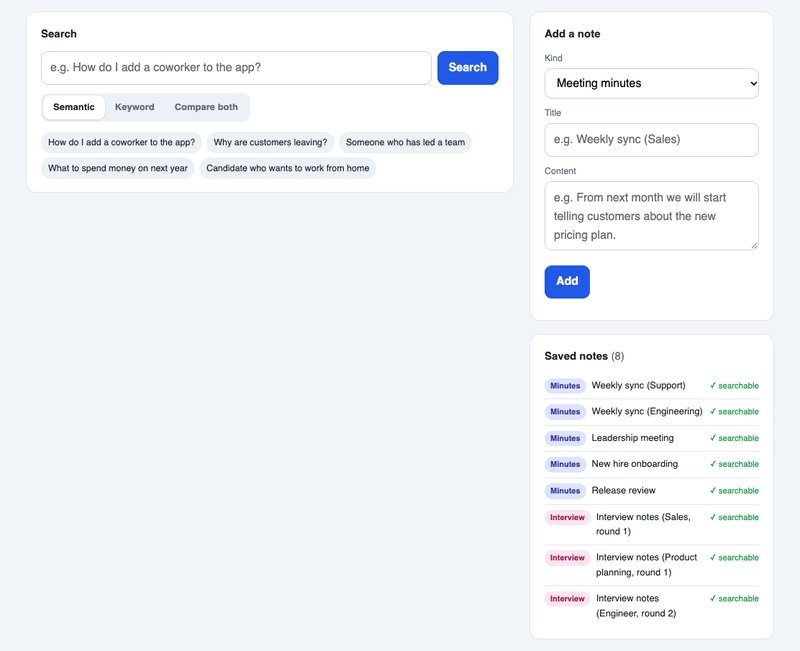
新增后,页面每 2 秒查询一次状态,直到向量存在。作者运行中约轮询 4 次。按作者在 2026-10-22 核对的文档,Free plan 每月包含 500,000 次 Edge Functions 调用;一次搜索是 1 次调用,新增还包含页面写入、后台生成和状态轮询。作者没有查看实际用量,因此这里是调用路径估算。
内容长度是更直接的限制。原文引用的文档说明,gte-small 仅支持英文,超过 512 tokens 会截断。作者构造了一条 4,600 字符的笔记,把野餐安排放在末尾,查询野餐时进不了前三;查询开头主题却以 0.924 排第一。页面限制为 2,000 字符,但字符数与 token 数不能直接等同,作者也没有测出开始丢内容的位置。
更新同样存在时间窗口:修改正文会排入新任务,旧向量却一直保留到替换完成。作者在修改后 5 秒查询得到 0.916,推测新向量已经生效,但没有直接验证旧向量存在多久。
权限方面,表开启 RLS 且没有策略,作者用 publishable key 直接请求 REST 得到 []。然而函数直接连接数据库,不能据此认为函数入口也受到同样保护。embed、search 关闭了 Verify JWT,前者还接受任意笔记 ID 和任务 ID;memo-api 检查的 apikey 来自 SUPABASE_PUBLISHABLE_KEYS,而该 key 就放在页面里。
公开 key 的检查不能代替用户身份与数据权限。 原文建议正式使用时让 cron 携带 Vault 中的秘密请求头,或开启 JWT 并使用不进入浏览器的凭据;service_role 和 secret key 不能放进 config.js 或仓库。
我的判断
这套方案适合学习自动向量化的完整流程。队列让写入请求不用等待模型,状态接口让用户看见处理进度,数据库负责存储和检索,职责划分清楚。
但它仍是 demo。作者没有验证超过 8、9 条笔记的效果,也没有验证其他浏览器或真实登录系统。HNSW 索引已经建好,不等于已经测过规模性能;100k 行测试、长文切块、混合搜索和 Auth 加 RLS,都是尚未验证的后续方向。
和单纯的子串搜索相比,它对改写提问更友好;和关键词、全文检索相比,否定条件、精确词语和无关问题又暴露了不足。混合搜索值得继续试,但原文没有对照数据,我不会替它保证效果。对国内团队,还有一个先决条件:这组英文实验没有证明中文资料可用。
能拿来做什么
- 给英文会议纪要或面试笔记做原型时,可以复用「写入触发队列、后台生成向量、前端轮询状态」的链路,同时把结果展示为候选资料。
- 前端应区分保存成功和可搜索两个状态,并把 HTTP 401、
Failed to fetch转成能指导检查 key、URL 或连接问题的提示。 - 接入真实资料前,先准备包含否定、无关问题、近似措辞和长文末尾信息的测试集,再决定是否切块、混合检索及设置阈值。
- 多人使用前,先实现用户身份和数据权限,并保护后台调用入口;不要把 demo 中公开 key 的校验当成登录系统。