用状态机约束 AI 编程流程
作者用 Python 脚本和状态机图控制 AI 编程步骤,处理跳过需求分析、遗忘阶段决策及跨会话进度丢失等问题。文章介绍团队实践,并提供源码入口。
AI 深度解读
AI 编程的麻烦,不只是代码写错,还包括流程走偏:要求先分析需求,模型直接开写;做到第三步,前两步的决定已经被忘掉;换个会话,又得重新交代进度。作者给 AIDLC 加了一套 Python 脚本,把流程推进交给状态机,把判断留给模型。
这套做法值得看的地方,是它把规格文档、按需加载、阶段依赖和断点恢复连成了一条执行链。不过,「流程不再漂移」是作者团队的使用结论,原文没有给出对照数据,也没有证明生成代码因此一定正确。
规格写得够细,为什么模型还是会跳步骤
作者推动团队使用 AI 编程已有半年多。最初只能做演示原型,引入来自 Amazon 的 AIDLC 后,经过几个月调整,才逐渐做出能在生产环境稳定运行的应用。
AIDLC 属于规格驱动开发(SDD):先把需求和设计写成规格文件,再让模型按文件实施。问题出现在任务变大之后。上下文拉长或切换会话,模型开始漏读规格,流程也不再严格执行。作者还试过 OpenSpec 和 Superpowers,观察到了类似现象。
他的解释是:流程规则本身也占上下文。按原文描述,这类框架由几十份 Markdown 文件组成,会话启动时可能占用 30k 到 50k tokens;开发前生成的规格文件还会继续挤占空间。
即使上下文窗口超过 100 万 tokens,也不能把「放得下」当成「每条规则都能稳定执行」。
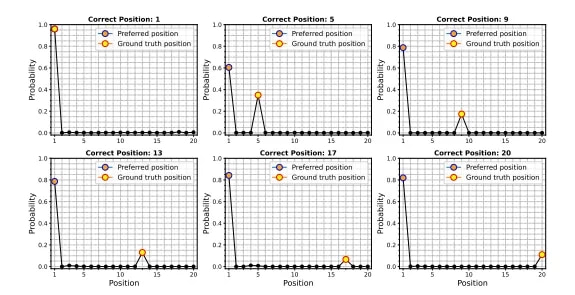
作者还以 deepseek-v4.1-flash 为例,认为长上下文和便宜缓存容易诱使使用者塞入过多内容,长会话下代码质量和指令遵循随之下降。这是作者的观察,原文没有交代测试任务、采样次数或质量指标,不能据此给模型下普遍结论。
但工程问题很明确:当「下一步做什么」也靠模型从长篇说明里回忆,流程就缺少一个可靠的执行者。
把流程写成机器能检查的规则
作者借鉴图执行引擎的思路,将阶段表示为节点,将依赖和分支表示为边。模型负责判断当前情况并输出结构化状态,脚本根据状态决定下一步。
模型提出判断,脚本执行流转,人保留决策权。
为避免每次调整流程都修改引擎代码,作者保留 AIDLC 原有的 14 份阶段 Markdown,在文件头部增加 frontmatter,也就是供程序读取的配置块。下面这段定义需求分析阶段的依赖、产物和适用范围:
---
slug: requirements-analysis
phase: inception
execution: ALWAYS
condition: Always executes with adaptive depth — every request needs its intent and requirements assessed; depth (minimal/standard/comprehensive) scales with clarity, complexity, and risk
gate: approve-continue
produces:
  - inception/requirements/requirements.md
  - inception/requirements/requirement-verification-questions.md
consumes:
  - artifact: inception/reverse-engineering/*
    required: true
    conditional_on: brownfield
  - artifact: inception/product-design/product-design.md
    required: false
requires_stage:
  - workspace-detection
  - reverse-engineering
  - product-brainstorm
depth: adaptive
scopes:
  classic: EXECUTE
  bugfix: EXECUTE
  refactor: EXECUTE
  security-patch: EXECUTE
  infra: EXECUTE
  express: EXECUTE
---
重点看 produces、consumes 和 requires_stage:它们把「应该先看什么、先完成什么、最后交付什么」变成了可供脚本检查的声明。gate: approve-continue 则声明了审批关口,但原文没有展开这个关口具体如何执行。
字段含义和取值记录在 reference/common/stage-contract.md,作为配置契约。修改阶段时,模型可以参考这份文件调整元数据。
流程图也不在运行时临时推导。作者在开发 skill 时运行 aidlc-workflows/scripts/generate.py,读取 frontmatter,生成保存在 aidlc-workflows/scripts/data/ 下的 JSON 图。--check 参数负责完整性检查,GitHub CI 在代码提交时自动执行检查。
这样,流程定义中的结构问题可以在交付前暴露,而不必等模型执行到一半再发现依赖缺失。
六种流程与状态文件,分别解决什么问题
AIDLC V1.0 只有一条包含 14 个阶段的流程。阶段即使不会执行,对应提示词也可能在 skill 加载时进入上下文。
作者将其拆成 6 个 scope:classic、bugfix、refactor、security-patch、infra、express。模型识别当前任务范围后,只加载需要的阶段文件。快速验证 MVP 可以走 express;产品逐渐进入稳定运营后,再参考审计日志和历史规格切到 classic,纳入用户故事、非功能需求、安全和扩展性等阶段。
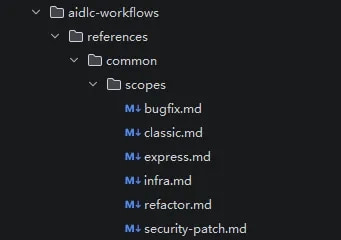
这里有两个独立收益:减少无关上下文,以及减少不必要的流程步骤。小修复不必承担完整产品开发的全部成本。
运行时则由 engine.py 提供 4 个关键命令:
init初始化工作流和状态文件。next根据已完成阶段及其产物,计算下一节点。report在阶段完成后更新状态。status读取当前 scope、可选阶段和团队协作模式等全局配置。
引擎作为 CLI 放在 skill 的 scripts 目录,遵循 AgentSkill 规范。作者希望借此避免针对二十多种 harness 分别适配 hooks;harness 可以理解为承载模型、工具和会话的运行环境。
持久化载体仍叫 aidlc-state.md,分为流程配置和任务清单两部分。前者记录项目类型、scope、产物目录和扩展功能;后者由引擎生成和更新。
清单用 <!-- BEGIN ENGINE-STATE 与 <!-- END ENGINE-STATE --> 标记,引擎要求模型不得直接编辑其中内容。每次更新还会生成 sha256 摘要;发现异常变动时,脚本发出警告,并尝试根据已有产物重建清单。
原文最后用 OpenCode 演示记账应用:先执行 status,发现空项目后执行 init,阶段完成后用 report 上报。生产任务则建议先准备产品设计文档,或在 OpenCode 的 plan mode 中讨论并整理设计,再进入 build mode 启动 aidlc-workflows。所提供原文在演示末尾截断,没有展示完整交付和验收结果。
我的判断
我认可它把流程控制从长篇提示词中抽出来的方向。规格文件解释「要做成什么」,脚本检查「能否进入下一步」,两者配合,比单纯追加「必须遵守流程」更容易检查和恢复。
相比直接用 LangGraph API 编写流程,frontmatter 更适合围绕 Markdown 维护的 skill;相比另建一份 YAML,它也减少了两套定义同步的负担。代价是团队要维护字段契约、图生成器和状态恢复逻辑,这已经是一套需要维护的软件。
但「脚本确定执行」不等于「整个任务不会出错」。模型仍然参与 scope 选择、状态判断和 CLI 调用。如果模型绕过引擎直接改代码,或者把未完成的阶段报告为完成,效果取决于引擎是否有足够的验证和约束。原文没有把这些边界讲清。
sha256 能帮助发现清单变化,却不能证明产物正确。需求文件存在,不代表需求理解准确;根据产物恢复进度,也需要可靠的完成判据。
作者关于框架历史和能力边界的叙述同样应谨慎看待,包括将 OpenAI Swarm 的发布放在 2025 年初,以及把 LangGraph 概括为 DAG 引擎。所给材料不足以核验这些说法,也不影响我们理解其具体实现。
这是一套值得借鉴的流程工程经验,还不是经过对照实验验证的质量保证方案。
能拿来做什么
- 如果前端或 Node 项目已经有规格开发流程,可以先把阶段依赖、输入文件和交付文件改成结构化声明,再让脚本检查能否继续,逐步减少对模型记忆的依赖。
- 给日常任务划分适用流程,让 bugfix、重构和完整功能开发加载各自需要的规则。先减少无关上下文,再判断是否需要更长的上下文窗口。
- 将进度记录交给工具维护。新会话先读状态,再加载当前阶段需要的规格;完成阶段后通过命令上报,避免模型凭聊天记录猜测进度。
- 把阶段完成条件写具体。文件生成可以作为检查项,但涉及代码交付时,还应结合项目已有的构建、测试或人工验收结果,避免把「有产物」当成「已完成」。