编程智能体的故障记录为何无人处理
团队审阅智能体保存的 802 条笔记,发现其中七条反映命令输出压缩工具 rtk 破坏了输出,但问题始终未传递给人类维护者。相关修复已公开 47 天,说明节省上下文之外,还需要让故障记录进入人工处理流程。
AI 深度解读
AI 编程代理发现了工具缺陷,找到了绕法,还把经验写进了记忆。问题是,人一直不知道。Cloud ex Machina 团队检查了 802 条代理记忆,才发现其中 7 条都在描述 rtk 的输出损坏,而上游修复已经公开了 47 天。
这件事值得看,不只是因为输出压缩可能丢信息,更因为代理太擅长继续完成任务:一次绕过成功,可能就把一个应该修复的问题,变成长期沿用的工作习惯。
输出压缩什么时候会变成数据损坏
rtk 是一个用 Rust 编写的开源命令代理,放在 AI 编程代理与 shell 之间。Claude Code 的 hook 会把 git diff 改写成 rtk git diff,由 rtk 执行真实命令,再返回过滤后的结果。测试输出可以只留下失败信息,Git 输出也能压缩。
收益有实测支撑:仅作者的一台笔记本,rtk 就替代理上下文省去了 670 万 tokens,占它处理的命令输出总量的 13.8%。作者明确表示,他们仍会继续使用。
风险出在输出的用途发生变化。
给模型阅读的结果,压缩后可能更清楚;用来生成补丁、统计数量、传给另一个代理的结果,却需要保留完整数据。少几行未必引发命令报错,却可能改变后续结论。
供阅读的摘要,不能直接当作完整数据使用。
团队的发布代理就踩中了这个边界。它根据提交标题编写发布说明,10 月 7 日发布的首版说明却只列出了不到一半已交付的 PR。有人发现缺漏,在部署后 44 分钟修正。交付代码没有问题,内部发布说明出了错,而且没有命令失败或告警。
代码评审流程相对稳住了:review skill 在脚本内部获取 PR diff,而他们的 hook 只改写代理直接输入的命令。9 月 28 日那条关于 diff 截断的记忆,来自代理手动获取 diff。两条路径看似做同一件事,是否经过 hook,却决定了拿到的数据是否完整。
为什么七次发现都没变成团队的问题
代理会保存跨会话的私人记忆,让下次执行任务时继续使用已有经验。这次发现的 7 条记录,来自两名开发者的代理,最后都指向同一个绕法:通过 rtk proxy 执行命令,跳过过滤。
代理发现问题、解决当前阻塞、留下操作说明,这套流程每一步都很合理。缺的是把问题交给人的出口。记忆文件只由对应开发者的代理加载,其他人不会自然看到。
原图为 Randall Munroe 的 xkcd 1172「Workflow」,采用 CC BY-NC 2.5 许可。
命令样本说明,这个绕法已经相当常见:206,965 次 shell 命令中,7,128 次经过 rtk proxy,六名开发者中有五人的代理在使用它。与此同时,5,952 次失败命令里只有 33 次提到 rtk。
这组数据不能证明所有代理调用都在规避缺陷,却解释了为什么只查失败日志不够:输出不完整,命令仍可能成功退出。
作者也没有把记忆直接当作事实。10 月 28 日,他们用代理当时的 rtk 0.37.2 和 hook 脚本重新执行相关命令。空搜索结果和一次原因不明的 push 失败没有复现,被排除在后续分析之外。代理记忆能提供线索,仍需要复测。
升级二进制,为什么还不算修完
团队使用的是 4 月 20 日发布的 rtk 0.37.2;检查时,最新版本已经是 10 月 25 日发布的 1.1.0。hook 更旧,是 2 月安装、自己匹配命令的 shell 脚本。
新版提供了 rtk rewrite,负责判断哪些命令可以安全改写。但升级二进制不会替换已安装的 hook,旧脚本也就不会调用新逻辑。更麻烦的是,rtk init --show 显示了 [ok] Hook: rtk hook claude (native binary command),实际配置却仍在运行旧脚本。
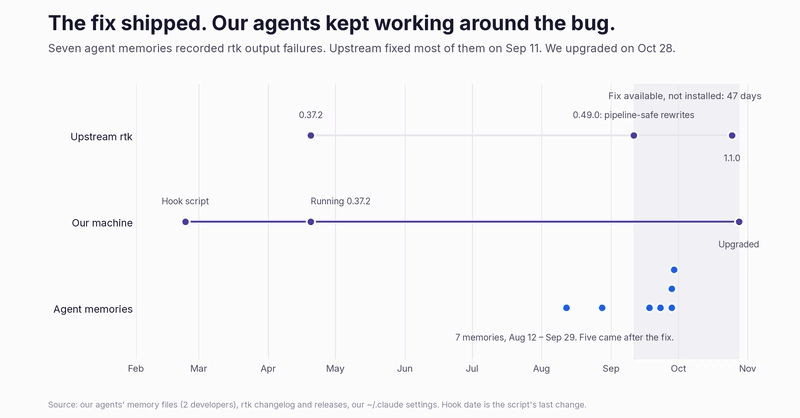
按 changelog,重定向输出相关修复在 9 月 11 日的 0.49.0 中已经发布,7 条记忆有 5 条产生于此后。作者测试的 1.1.0 中,rtk rewrite 会放过那些把输出写入文件,或传给 wc、head 的命令。
不过,新版也有残留问题。直接读取 gh pr diff 时,代理只能看到 25 个文件中的 14 个,末尾提示 ... (more changes truncated),并建议执行 rtk git diff --no-compact。这个提示指错了命令:在干净检出目录里,它没有输出,容易让代理误以为没有更多内容;rtk gh pr diff --no-compact 才能返回全部 25 个文件。
git show 的同类错误提示已有 rtk#4817,两个命令共用相关提示代码。原文还提到大型 diff 静默丢失、退出码被吞和管道生产者被改写的公开问题,不能据此认定升级解决了所有风险。
团队最终升级到 1.1.0,并用 rtk init -g 重新生成 hook。原先只保留 1% 提交标题的 git log,恢复了完整输出;rtk 和 hook 也被纳入依赖更新管理。
我的判断
作者最有说服力的地方,是把「继续完成任务」和「推动缺陷修复」拆开看。代理能够绕过问题,并不能保证维护者知道问题存在。
但「代理不会烦躁,所以不会报 bug」只是作者的解释,没有对照实验。原文没有比较加入明确上报规则后,代理是否仍然只写记忆。可以确认的是,他们现有工作流缺少上报出口,不能直接推导成代理都不会报告缺陷。
rtk proxy 也不是越多越好。全部绕过会放弃已验证的压缩收益。更合理的取舍,是按用途区分:供模型浏览的输出可以摘要,作为后续处理输入的内容优先保真。通过脚本避开 hook 在他们当前配置下有效,换一套 hook 规则未必成立。
更大的隐患来自内部工具:802 条记忆中,93 条,也就是约 12%,记录了缺陷绕法,多数涉及团队自己的代码和工具。作者计划让每周记忆审查把这些记录送进工单,但尚未给出落地后的修复率或时间变化。这是值得借鉴的治理方向,还不是已验证的收益。
能拿来做什么
- 检查 AI 编程流程里用于补丁、PR 评审和发布说明的命令,确认下游拿到完整输出;使用 rtk 时,可以参考作者用
rtk proxy绕过过滤的处理。 - 把 hook 当作依赖配置一起维护。升级工具后,核对实际加载的脚本,并用带文件重定向和管道的真实命令验证行为。
- 定期检查代理记忆中的绕法,复现后建立工单。保留临时操作说明,同时让问题进入有人负责的维护流程。
- 评估输出压缩时,同时检查信息完整性。命令成功退出之外,还要核对文件数、提交条目和下游产物是否齐全。