单卡部署Nemotron的显存账与加速陷阱
作者在48GB A40上用llama.cpp部署Nemotron 3.5 Bolt,开启视觉与草稿模型后实占约27GB,单用户生成速度由70提升至136 token/s。文章拆解24GB标称容量的覆盖范围,并提醒关注编译版本与草稿模型的适用条件。
AI 深度解读
Nemotron 3.5 Bolt 把 74B 参数模型压进了约 22 GB 的文件,但「24 GB」不等于图像、长上下文和加速组件全开后,还能塞进一张 24 GB 显卡。作者用单张 A40 跑通了服务,发现真正影响部署的,是显存口径、llama.cpp 版本,以及辅助模型是否适合请求类型。
这篇实测适合正在搭建本地 AI 编程服务的程序员看:它给出了速度收益,也记录了冷启动、GPU 健康检查和隐藏推理的坑。不过,24 GB 显卡能否运行,作者并没有验证。
24 GB 到底包含什么
Nemotron 3.5 Bolt 74B-A9B 能读取文本和图像,总参数量是 74B,每个 token 约激活 9B。大部分参数按约 2 bit 存储,因此权重文件只有约 22.0 GB。激活参数少,减少的是每步计算量,并不代表只需存下 9B 参数。
NVIDIA 的 23.83 GB 预算由三部分组成:22.01 GB 权重、约 128,000 token 对话所需的 0.87 GB 工作内存,以及 0.96 GB 的 drafter。额外 1.68 GB 的图像读取组件不在其中。
「24 GB」首先是面向单用户的纯文本预算。
单位还会改变余量。原文按显卡实际容量为 24 GiB 计算:若 NVIDIA 的预算是十进制 GB,约剩 1.9 GB;若是 GiB,就只剩约 0.2 GB。更关键的是,作者在 A40 上测得 drafter 接近 2.4 GB,高于预算中的 0.96 GB,原文没有解释差异原因。
他们实际使用的是 48 GB A40,开启图像组件和 drafter,按快速入门设置使用 98,304 token 上下文,占用约 27 GB,即 25.2 GiB。这既不能验证纯文本预算,也不能证明 24 GB 卡装得下。NVIDIA 发布的 llama.cpp 配方包含图像组件,最小要求是 32 GB 卡。
跑通模型之前,先把版本和冷启动算清楚
Bolt 需要包含 10 月 15 日发布当日支持代码的 llama.cpp。NVIDIA 工程师 Kartik Gulia 添加了模型和图像组件支持,ggerganov 当天合并了 PR #30520;旧版本会拒绝加载文件。
作者的平台 InferenceKey 用 worker 自动配置 GPU 机器,但固定版本比该合并落后 1,920 次提交,最后手动指定 v0.7.0。
版本解决后,等待又卡在编译上。新机器从请求到就绪用了 764.8 秒,其中 705 秒花在 9 核 CPU 编译 llama.cpp。worker 调用 cmake --build 时,若没有设置 CMAKE_BUILD_PARALLEL_LEVEL,就不会指定并行任务数。
作者手动设置 12 个任务后,编译仍占等待时间的 92%;换到 31 核机器,同一构建缩短到 2 分 41 秒。已经完成构建的机器再启动一份服务,只需 15.6 秒。
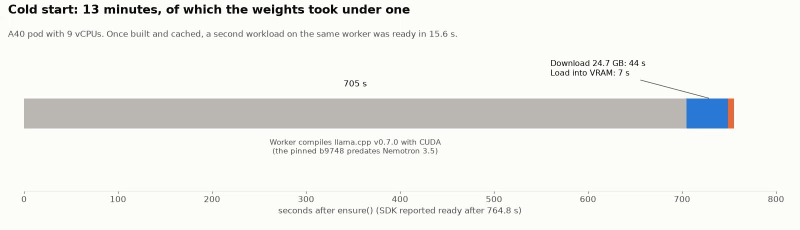
这里该优化的是构建流程和产物复用。只比较 GPU 型号,会漏掉冷启动里最大的开销。
drafter 能翻倍提速,为什么长文档反而变慢
Bolt 配套的 LiLiCorr drafter 约有 1.1B 参数,文件约 1.0 GB。它先猜后续多个 token,再交给 Bolt 一次验证;Bolt 接受首次不匹配之前的连续结果,并自行生成不匹配位置的 token。这就是推测解码(speculative decoding)。
以下参数在服务启动时启用 drafter:
--spec-draft-hf nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
--spec-type draft-dflash --spec-draft-n-max 6 --spec-draft-ngl 999
留意第二行的 --spec-draft-n-max 6,它设置最多草拟 6 个 token;整段配置属于服务启动参数。
短、中等提示词的收益很直接:25 次请求中,生成速度中位数从 70 提升到 136 tokens/s,开启后的最低速度为 110 tokens/s,草拟 token 接受率为 70%。
但生成快,不保证整次请求更快。作者测得 drafter 会让提示词读取速度降低约四分之一。面对一份 25,000 token 文档,同一个问题不开 drafter 用时 17.5 秒,开启后反而用了 21.5 秒。
是否启用 drafter,要看输入长度和输出长度共同决定的总耗时。
v0.7.0 中,按请求控制 drafter 的功能被编译禁用了,因此不能靠请求参数临时切换。混合流量需要先分别测试,再决定服务配置。
部署还有两个容易误判的地方。作者最初拿到的两台 RTX 5090 机器都能响应 nvidia-smi,但 CUDA 初始化失败,平台仍把模型标为就绪,因此没有得到 32 GB 卡的实测数据。另一次,一句话答案消耗了 374 个生成 token 的时间,原因是隐藏推理。NVIDIA 模型页记录了关闭思考的开关,但 InferenceKey 当时还没有转发它,原文也未给出具体参数。
我的判断
这篇最有用的是部署记录,而不是模型排名。显存预算区分组件、冷启动区分编译与加载、性能区分输入处理与输出生成,这些做法能直接减少误判。
但证据范围很窄:作者总共约测了 50 次请求,单张 GPU,每次只处理一个请求。两工具退款任务在 5 次运行中都正确调用了两个工具,只能说明这条流程跑通,无法据此判断复杂编程任务的可靠性。
质量对比来自 NVIDIA:Bolt 在多数 agent 基准上超过 Qwen3.6-35B-A3B,例如 Terminal-Bench 2.1 得分为 50.98,对方为 44.38,但事实回忆表现落后。NVIDIA 自己的速度表里,Bolt 也落后于 Qwen3.6 和 Gemma 4。
作者没测并发,也没测另一条部署路线 vLLM。原文提到并发时 drafter 通常收益更小,但没有提供本次对照数据。选 llama.cpp、选 Bolt,仍要结合自己的请求测试。OpenMDW-1.1 允许商业使用,也不能替代性能和质量验收。
能拿来做什么
- 搭建本地 AI 编程服务前,分别测量纯文本、图像组件和 drafter 的显存占用,统一 GB 与 GiB 口径,别把文件大小当成运行容量。
- 给短问答和长文档问答分别测试 drafter,记录整次请求耗时;涉及长代码或长文档输入时,尤其要观察读取阶段。
- 自动拉起 GPU 服务时,固定已验证的 llama.cpp 版本,设置编译并行度,并复用构建产物,把首次启动纳入部署验收。
- 健康检查加入真实 CUDA 推理请求,并核对隐藏推理耗时和参数透传情况,避免状态显示正常、业务却无法使用。