从选型到实战的编程Agent使用指南
文章以Claude Code为例,讲解编程Agent的选型、提示词、记忆管理、权限配置和数据保护。后半部分通过LinkLite小项目演示从开发到1.0.0版本的完整过程。
AI 深度解读
让 AI 写出代码,和让 AI 可靠地完成开发任务,是两件事。作者围绕 Claude Code 给出了一套工作方法:先明确目标和边界,再让代理读取项目、修改代码、运行检查,最后由人审查结果。工具选型只是其中一环,任务拆分、项目记忆和权限配置同样重要。
对前端和全栈开发者,这篇最有用的部分是如何把一次模糊的对话,变成可以验收的工程任务。不过,提供的原文没有包含目录里承诺的完整项目实战,不能把这些建议当成已有完整实验支撑的结论。
Agent 的价值,为什么不能只看模型
作者区分了助手和代理(Agent):助手给出建议,代理还能调用工具,在环境里执行操作,并根据结果继续行动。
例如修复注册测试,助手可能解释失败原因;代理则可以读取测试和实现、修改文件、运行测试,再根据报错调整。模型负责判断下一步,工具负责执行,检查结果提供反馈。
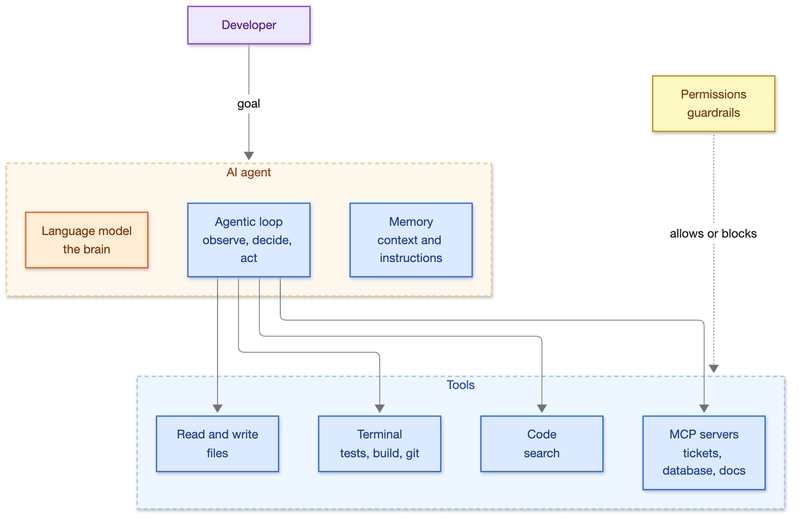
这里有个实际区别:语言模型按 token 预测后续内容,生成的代码可能很像正确答案,却引用了不存在的 API。接上测试、编译和 lint,才有机会把错误暴露出来。模型训练知识还有截止时间,涉及新 API 时,项目文档和当前官方资料也需要进入上下文。
能生成代码只是起点,能获得有效反馈才构成开发闭环。
围绕代理的几个概念,也应分清用途:
- 子代理有独立上下文,适合承担安全审查等相对独立的任务,完成后返回摘要。
- Skill 是可加载的操作知识,例如如何根据提交记录写发布说明,不会自己独立工作。
- MCP(Model Context Protocol)连接外部工具和数据,解决接口接入问题。
- Hook 用于在流程节点执行检查,命令则提供可重复调用的操作入口。
作者用 USB-C 类比 MCP 的通用连接能力,这有助于理解协议的作用,但接入方便不代表连接器可信。MCP server 仍是能访问工具和数据的第三方代码,需要单独判断来源与授权范围。
怎样把一句需求,变成可以验收的任务
作者建议的开发顺序是:探索、计划、实现、验证、审查、提交。人的职责是决定目标、约束和验收标准,代理负责在这些边界内推进。
最值得保留的是下面这段分页提示词。它把「加一个分页」变成了有范围、有约束、有完成条件的任务:
Context: Next.js application, module src/features/users.
The user list loads every record, which slows the page down.

Goal: add server-side pagination (20 items per page).

Constraints:
- follow the existing architecture (repository > service > action);
- do not change the database schema;
- no new dependencies.

Success criteria:
- service unit tests for the first page, an intermediate page and the last page;
- all tests and the lint pass.

Start by proposing a plan, without modifying any file.
注意最后一行:先给计划,不修改文件。它给开发者留下了纠正方向的机会,避免代理在错误假设下连续修改多个文件。
这里真正有效的也不是提示词够长,而是信息足够具体:位置在 src/features/users,每页 20 条,遵循 repository > service > action,不改数据库结构,不加依赖,并覆盖首页、中间页和末页测试。
作者推崇测试驱动开发(TDD):先写失败测试,再实现,最后重构。测试给代理提供了明确目标。不过,测试是否覆盖真实需求,仍要由人判断。代理可以围绕错误理解写出一套自洽的实现和测试。
任务范围同样重要。一次请求混入重构、新功能和缺陷修复,既难定位回归,也难审查。作者建议一个请求对应一个可验证目标,理想情况下对应一个提交。
选工具也沿用这套思路:找两三个候选,在同一个真实任务上比较结果、人工审查时间和测试质量。演示里的生成速度,不能直接代表团队实际节省的时间。
项目记忆和权限,应该怎样落到仓库里
作者把上下文窗口比作会议期间的工作记忆,把持久化文件比作每天开工前翻阅的日志。对开发团队而言,后者最适合存放稳定规则:安装与检查命令、目录约定、架构决策及已知陷阱。
原文的 CLAUDE.md 示例包含 bun install、bun run test、最低覆盖率 95%,以及 bun run lint && bun run typecheck;还约定按 src/features/<name>/ 组织功能,修改通过 Server Actions,并用 Zod 校验。
这些是示例项目的约束,不是所有团队都该照抄的标准。尤其是 95% 覆盖率,原文没有解释选择依据。
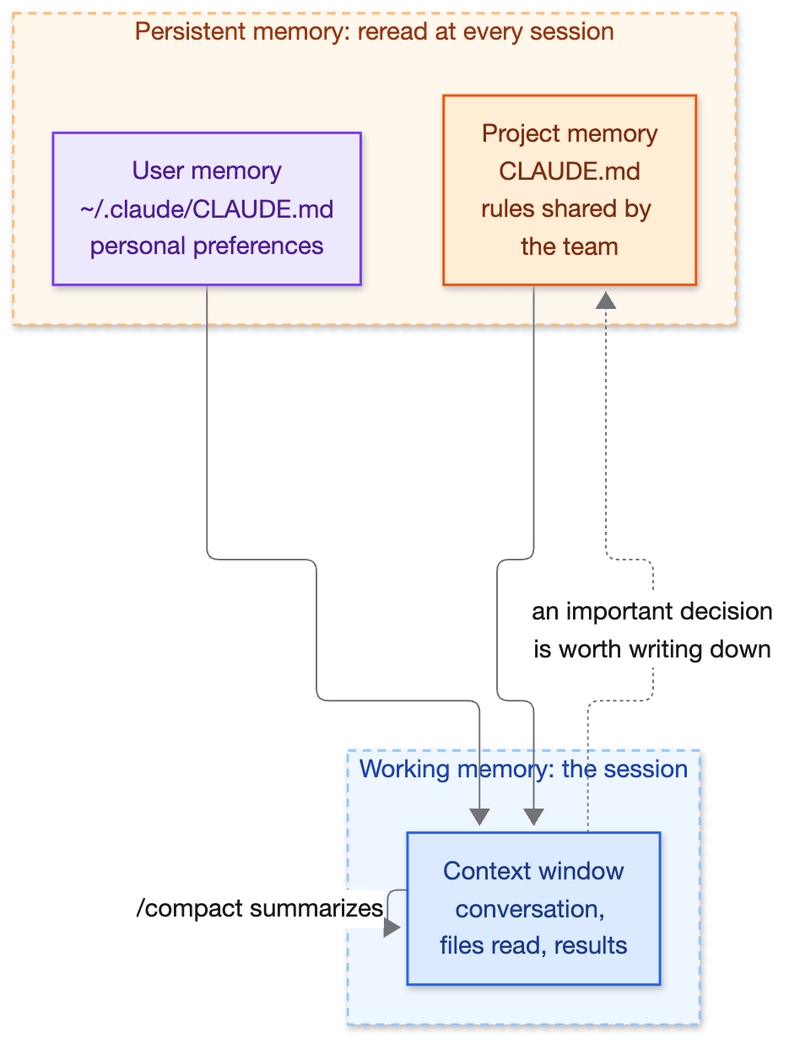
作者强调记忆文件应短、准确、及时更新。规则越多,每次占用的上下文越多;过期规则还会让代理持续沿用错误前提。个人偏好放在 ~/.claude/,团队约定放在项目内,能减少彼此干扰。
项目的 .claude/settings.json 保存共享权限和 hooks,settings.local.json 保存不入库的个人设置;commands/、agents/、skills/ 分别放命令、子代理和技能。项目 MCP 配置放在 .mcp.json,其中不能包含明文密钥。
权限不能只靠一句「别动敏感文件」。下面的配置把常用操作与禁止操作写成了规则:
{
  "permissions": {
    "allow": [
      "Bash(bun run test:*)",
      "Bash(bun run lint)",
      "Bash(git status)",
      "Bash(git diff:*)"
    ],
    "deny": [
      "Read(./.env)",
      "Read(./.env.*)",
      "Read(./secrets/**)",
      "Bash(git push --force:*)",
      "Bash(rm -rf:*)"
    ]
  }
}
重点看 deny:敏感文件读取、强制推送和递归删除被明确禁止。作者给出的原则是,预先允许常见低风险操作,禁止危险操作,其余操作请求确认。具体匹配语法仍应以实际使用的工具版本为准,原文没有注明 Claude Code 版本。
此外,网页、工单和文件里的文字可能包含提示注入。它们应该作为待处理的数据,不能自动成为代理的新指令。测试数据尽量虚构、凭证使用最小权限、修改保留 Git 历史,也都属于同一套边界管理。
我的判断
我认同作者把重点放在工程流程上。对现有前端或 Node 项目,明确范围、沿用架构、运行检查、人工看 diff,比反复琢磨一句提示词更容易形成稳定协作方式。
但文章里几处表述需要收紧。「能运行测试就能修复自己的错误」说得太满。测试只反馈它覆盖到的问题,无法替团队确认需求理解、权限边界和长期维护成本。
「TDD 是代理最好的盟友」「任务范围是首要成功因素」,也更接近作者的方法主张。提供的内容没有对照实验,没有不同工具的成功率、成本或耗时数据,不能据此判定某一种流程普遍最优。
每次修改都先审批计划,也有适用范围。涉及多个模块、数据库或外部副作用时,计划很有价值;改一处明确文案,则可以用清楚的验收条件减少往返。
原文把 Machine Learning、Deep Learning、NLP、LLM 和生成式 AI 画成层层包含的关系,也只是入门近似。NLP 是任务领域,生成式 AI 可以覆盖多种模态,不能把所有概念严格塞进一组套娃。
另一个限制是材料不完整:目录列出了 LinkLite、Context7、frontend-design、PostgreSQL、Docker 和 v1.0.0 交付,但提供的正文在常见陷阱处截断。能确认作者计划讲这些内容,无法确认具体实现和验证结果。
能拿来做什么
- 给下一个 Next.js 或 Node 修改任务写清楚目标、相关路径、禁止改动和验收条件。涉及多个文件时,先让代理提交计划,再按步骤实施。
- 为项目整理一份简短的
CLAUDE.md,只保留团队实际执行的命令、架构约定和已确认的陷阱;不要把示例中的 Bun、Server Actions 或覆盖率要求直接搬进去。 - 按原文的思路配置权限,让代理顺畅运行测试和检查,同时限制敏感文件及危险命令。接入 MCP 时,单独核对 server 来源与凭证权限。
- 用同一个真实缺陷比较候选工具,把人工读 diff、纠正方向和补充测试的时间一起记下来,再决定哪个适合团队。