Olala 本地部署:量化内存与框架兼容实情
Olala 是 Apache 2.0 授权的 6.8B 总参数、约 1B 激活参数 MoE 模型,8GB 显存宣传需结合量化版本理解,BF16 文件达 13.59GB。主流推理框架尚未原生支持其架构,需要厂商分支;文章未实测,速度数据来自厂商。
AI 深度解读
Olala mini 每个 token 只激活约 1B 参数,却不能按「1B 小模型」估算显存。它有约 6.8B 总参数,BF16 权重文件达到 13.59 GB,宣传中的 8 GB 门槛需要量化版本才能解释。
这篇分析的价值,是把显存、速度和运行条件拆开核算:模型为什么可能跑得快,长上下文为什么可能省缓存,以及为什么下载了权重也未必能用熟悉的工具启动。作者没有实际运行模型,文中的性能数字均来自厂商,计算结果用于检查宣传口径是否合理。
1B 激活参数,为什么仍然装不进 8 GB?
OVHcloud 于 2026 年 11 月 17 日发布 Olala mini,Hugging Face 上提供 base、SFT 和后训练检查点,权重采用 Apache 2.0 许可。
Olala-v1.0-mini-7A1B 属于混合专家模型(MoE)。每层有 256 个路由专家,每个 token 选中其中 6 个,再加 1 个共享专家,因此单次计算约激活 1B 参数。
但参与当前计算的参数少,不等于其他权重可以从显存预算里消失。
safetensors 元数据显示,它包含 6,756,461,568 个 BF16 参数和 16,662,576 个 F32 参数,合计 6,773,124,144 个。按约 6.77B 参数、每个参数 2 字节计算,权重已经需要约 13.5 GB,与 13.59 GB 的 BF16 文件吻合,还没算运行状态。
「1B active」用于估算每步计算和读取量,不能直接当作模型的存储规模。
8 GB 的解释来自量化:Q5_K_M GGUF 文件为 5.99 GB,MLX 构建为 5.4 GB,Q8_0 为 6.88 GB。作者将 5.99 GB 换算后得到平均每个权重约 7.08 bit,推测部分张量保留了更高精度。这个推测有数字依据,但模型卡没有明确确认。
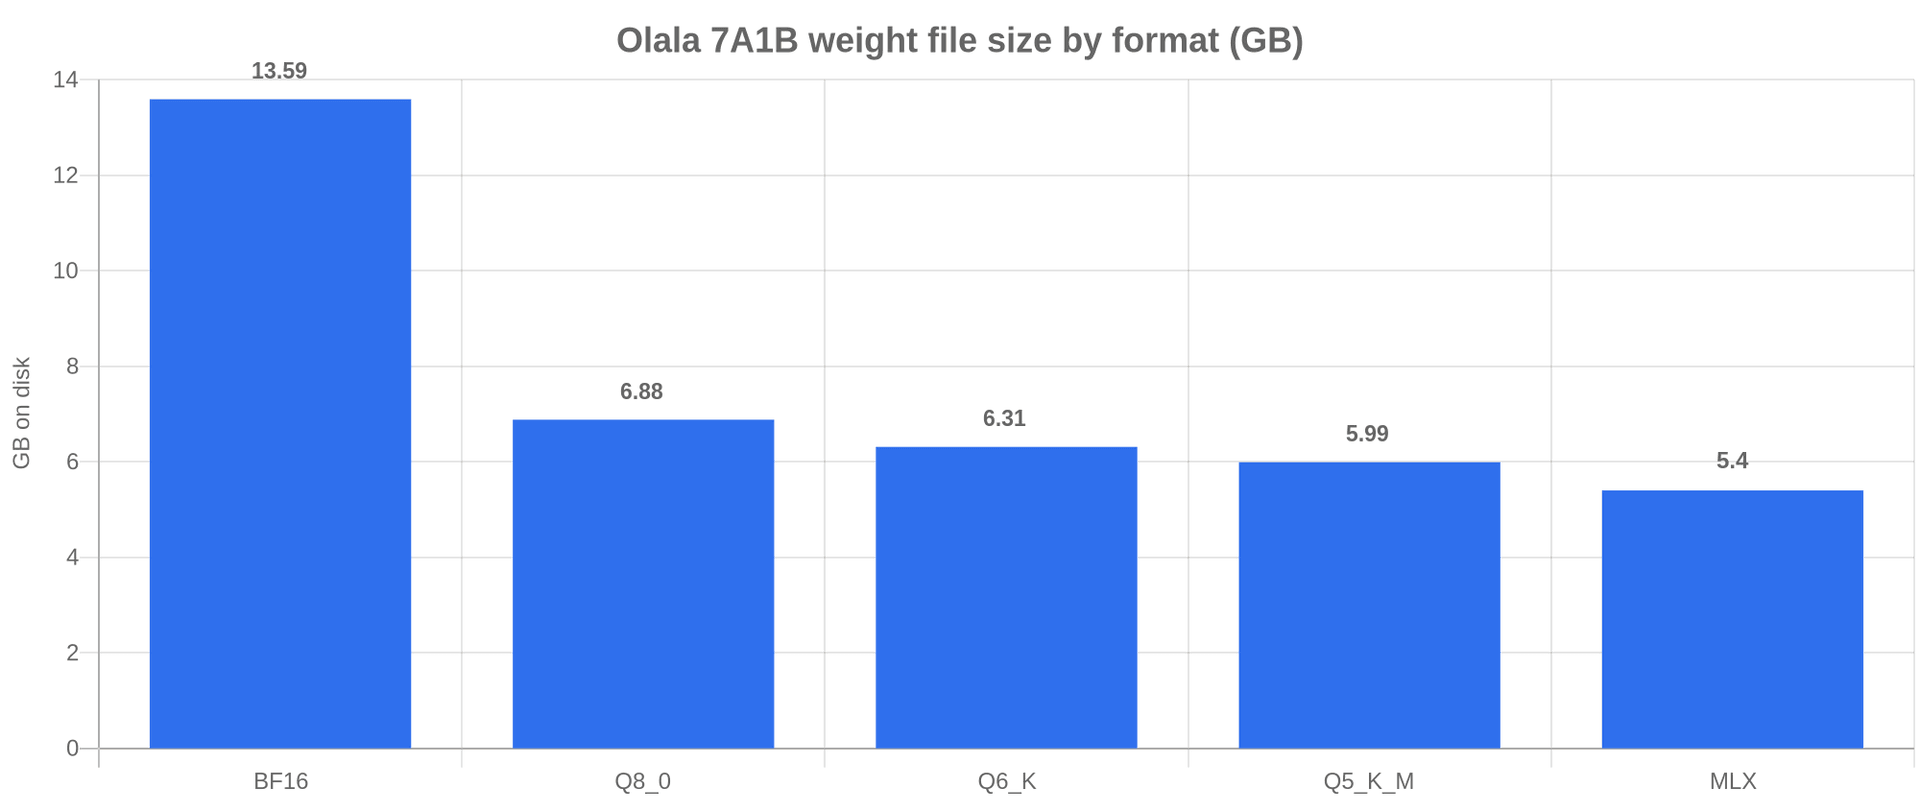
Q5_K_M 装入 8 GB 显卡后,粗算还剩约 2 GB,供状态、缓存和运行时使用。完整 32K 上下文是否够用,原文没有给出测量。模型卡对 NVIDIA 上的 vLLM 路径反而建议使用至少 24 GB 显存,并提到在 L4、L40S 上测试过。
所以,「量化权重放得下」和「目标任务能稳定运行」需要分别验证。
160 tokens/s 合不合理,先问它用了什么精度
厂商给出的速度是 RTX A4500 20 GB 显卡上 160 tokens/s,以及未注明型号的 CPU 上 50 tokens/s。
作者用带宽上限估算检查这些数字:单路逐 token 解码,每一步需要读取活跃权重;可用内存带宽除以每个 token 的读取量,就得到一个粗略速度上限。
约 1B 活跃参数使用 BF16 时,每个 token 读取约 2 GB。达到 160 tokens/s,至少需要约 320 GB/s 有效带宽;换成 8-bit 文件约为 163 GB/s,按 Q5_K_M 与 BF16 的文件比例估算则约为 141 GB/s。
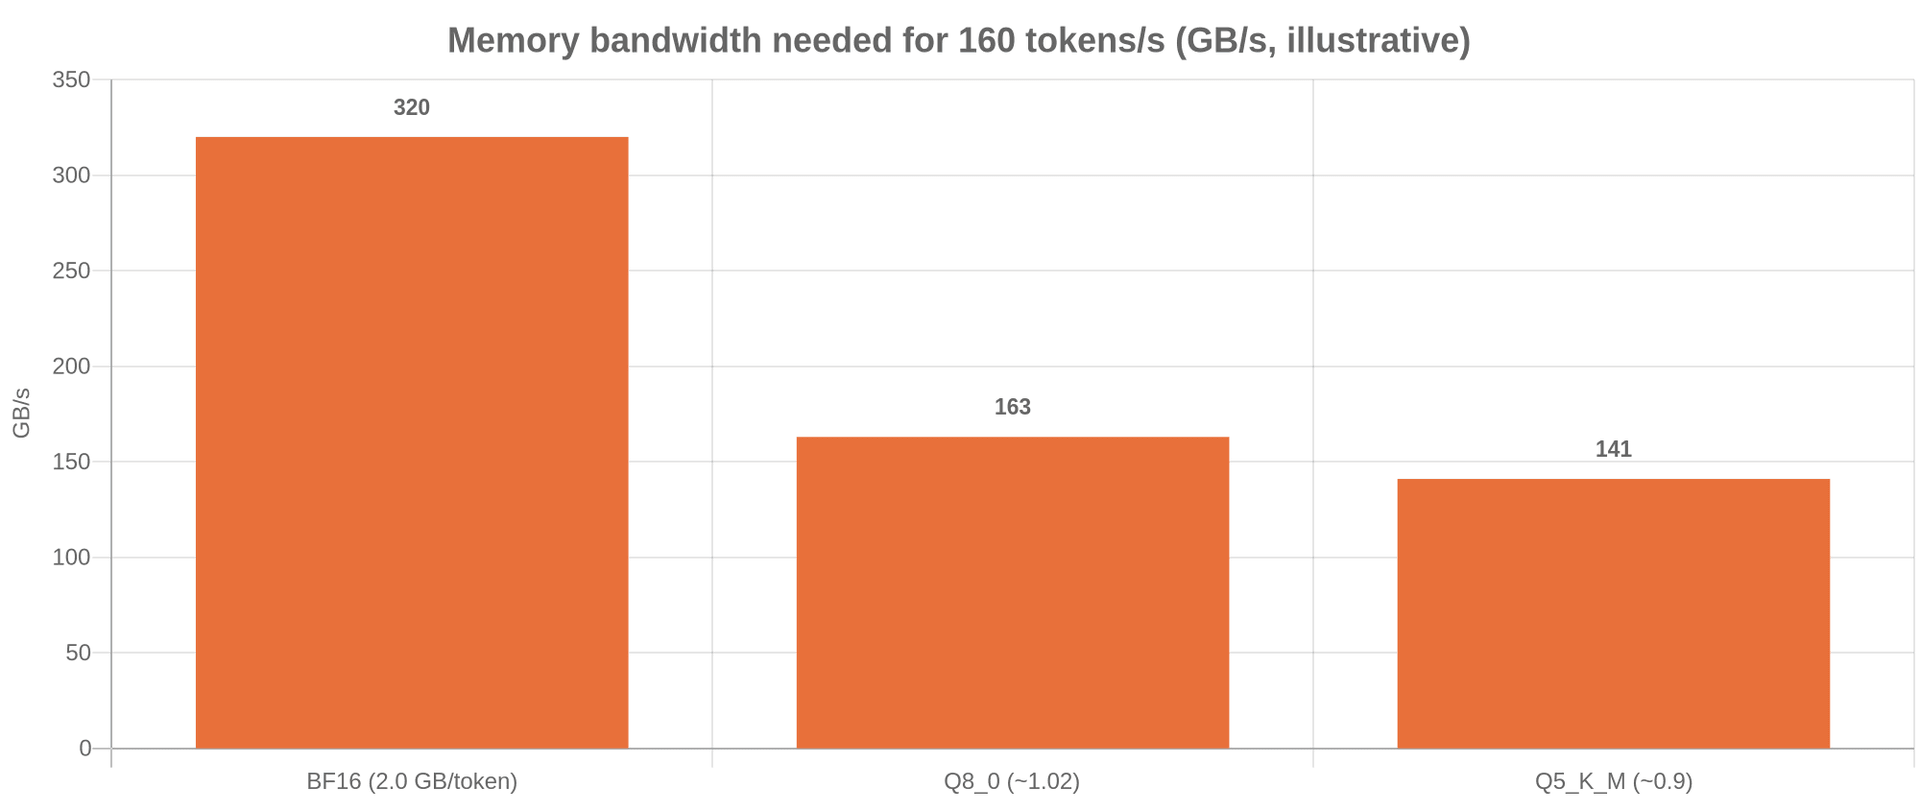
同一个速度,背后的带宽要求可以差一倍以上。厂商没有说明测速使用哪个构建,因此目前只能判断数字是否可能成立,无法据此公平比较其他模型。实际执行还要读取注意力和状态张量,专家路由也会带来分散读取,上面的数值只是带宽需求的下限。
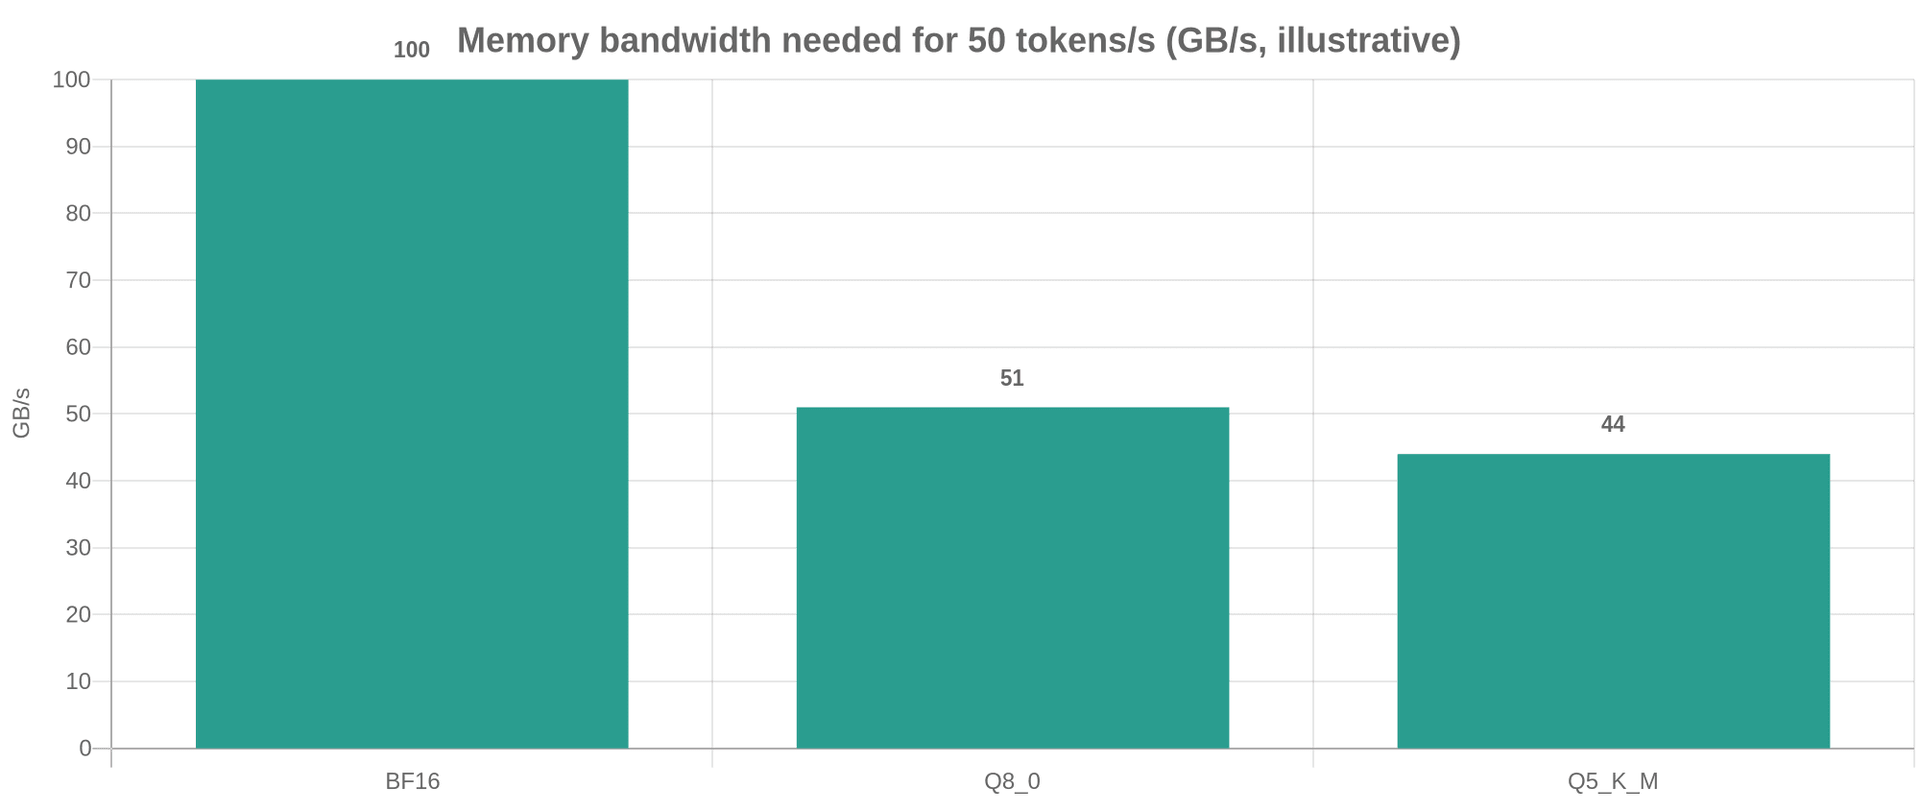
CPU 的 50 tokens/s 更依赖条件:BF16 需要约 100 GB/s,5-bit 约需 44 GB/s。作者据此判断,普通桌面平台要接近这个数字,需要量化权重和足够的内存带宽。
模型卡还给出另一组数字:普通 PyTorch 研究代码在 64 核服务器 CPU 上约为 6 tokens/s,Mamba-3 和专家层没有使用优化内核。
这能说明执行路径很重要,却不能严格证明 6 到 50 的全部差距都来自内核,因为两组测试没有交代统一的 CPU、精度和负载条件。
长上下文省缓存,但部署要跟着厂商走
Olala 的 36 层中,只有 7 层保存 KV cache,另外 29 层是维护固定大小循环状态的 Mamba-3。
如果假设每层缓存大小相同,相比全部 36 层都保存缓存的 Transformer,它的逐 token 缓存增长约为 7/36,即 19%。这是缓存增量的比较,不能理解成整机显存只需要普通模型的 19%。
作者没有进一步计算缓存字节数,因为 config.json 中的 num_key_value_heads 为 0,不能直接套用常见公式。目前上下文预算是输入加输出合计 32K;128K 仍是预告,报道中的路线图指向 2026 年底。
循环状态还有精度陷阱。厂商警告,vLLM 默认使用 bf16 保存 Mamba 状态,长生成可能退化成重复循环。启动时需要显式改成 float32:
vllm serve OVHaiLLM/Olala-v1.0-mini-7A1B --trust-remote-code \
    --mamba-ssm-cache-dtype float32 \
    --reasoning-parser olala --tool-call-parser olala --enable-auto-tool-choice \
    --max-model-len 32688 --port 8000
关键是 --mamba-ssm-cache-dtype float32。它也会增加每条序列的状态内存,所以共享服务需要测量并发增长后的占用,不能只看单请求。
软件兼容性是另一道门槛。按原文描述,Ollama、LM Studio,以及上游 llama.cpp、vLLM、mlx-lm 都还不能直接加载该架构,需要厂商 fork。vLLM 首次启动编译 GPU 内核约需 8 分钟,镜像要求驱动 580 或更新版本,以及 CUDA 13.0。
如果先验证业务效果,可以使用模型卡给出的 Hugging Face 托管调用:
import os
from openai import OpenAI

client = OpenAI(base_url="https://router.huggingface.co/v1", api_key=os.environ["HF_TOKEN"])
response = client.chat.completions.create(
    model="OVHaiLLM/Olala-v1.0-mini-7A1B:ovhcloud",
    messages=[{"role": "user", "content": "Explain how a heat pump works."}],
    temperature=0.8, top_p=0.9,
)
print(response.choices[0].message.content)
这里要保留 model 中的 :ovhcloud 后缀,并配置 HF_TOKEN。模型的推理强度分 disabled、low、medium、high 四档,默认 medium;high 被推荐用于数学,但会降低速度。输出还区分 analysis、final、tools 通道,接入时应使用厂商的 olala 解析器。
我的判断
作者最有用的做法,是把三个容易混淆的指标分开:总参数决定权重体积,活跃参数影响逐步读取量,混合架构改变缓存增长方式。这比单看「7B」「1B active」「8 GB」更接近真实部署问题。
不过,这仍是一篇基于模型卡和文件元数据的核算,不是实测报告。文件大小可以直接检查,带宽估算也能复核;生成质量、量化损失和真实吞吐还缺少独立验证。
例如,厂商称 6-bit 文件可在 16 GB MacBook Air M5 上达到约 70 tokens/s,8、6、5-bit 在代码和数学上的表现与 BF16 差异处于噪声范围。原文没有复现这些结果。Qwant 的短摘要业务据称回答快 20%、成本降至三分之一,但对照模型没有公开,也不能当作通用收益。
与成熟运行时已支持的模型相比,Olala 当前多了一层维护厂商 fork 的成本。对于需要稳定部署的团队,这项成本应与省下的缓存、可能获得的吞吐一起计算。发布报道没有给出评测分数,作者也没有复现仓库技术报告,因此现在还不能回答「它是否更适合写代码」。
能拿来做什么
- 给本地 AI 编程工具选模型时,把权重精度、文件大小、运行时支持和上下文预算一起记录。不要看到约 1B 激活参数,就按 1B 稠密模型安排显存。
- 如果目标是摘要等短文本任务,可以先通过托管接口验证输出质量和延迟,再决定是否投入厂商 fork 的部署维护。保留任务样本,方便之后比较本地版本。
- 部署 vLLM 时保留 float32 状态参数,并分别测量长生成是否重复、目标上下文能否装下,以及并发增加后的内存占用。
- 比较 160、70 或 50 tokens/s 时,要求同时提供硬件、量化格式、运行时和输入输出长度。缺少这些条件,就先把数字当作特定环境下的厂商声明。