百万页扫描件的文字识别成本已低于130美元
据 The Decoder 报道,使用可免费获取的 OCR 模型,百万页扫描件的文字提取成本已降至 130 美元以下,约为 18 个月前的五分之一。
AI 深度解读
开放获取的 OCR 模型,已经能把百万页文档的 GPU 租金压到 65 至 130 美元。The Decoder 报道的这组测试还给出一个更实用的结论:换新模型能省钱,把运行流程调顺,省下的钱可能同样多,甚至更多。
但这个价格有明确边界:测试针对特定历史书籍和档案,统计的是 GPU 租赁费用。对准备做文档数字化的程序员,它能帮助判断计算成本,也提醒我们把识别质量和异常处理一起算进去。
百万页不到 130 美元,是怎么算出来的
Hugging Face 的 Daniel van Strien 对比了 8 个能从图像中识别文字的开放模型,测试材料共 850 页,包括旧版自然史书籍、1771 年版《大英百科全书》,以及打字和印刷的档案文件。
所有模型都运行在同一款 Nvidia RTX PRO 6000 GPU 上,通过 Hugging Face 租用,价格为每小时 2.75 美元。在相同图像尺寸下:
- 最早的 RolmOCR 发布于 2025 年 4 月,每处理 1,000 页约花费 0.51 美元。
- 最新的 LightOnOCR-3-0.8B 发布于 2026 年 10 月,每处理 1,000 页约花费 0.095 美元,不到 0.10 美元。
两个端点相隔 18 个月,单位页成本降到原来的约五分之一。根据文档来源不同,处理 100 万页所需的 GPU 租金约为 65 至 130 美元。
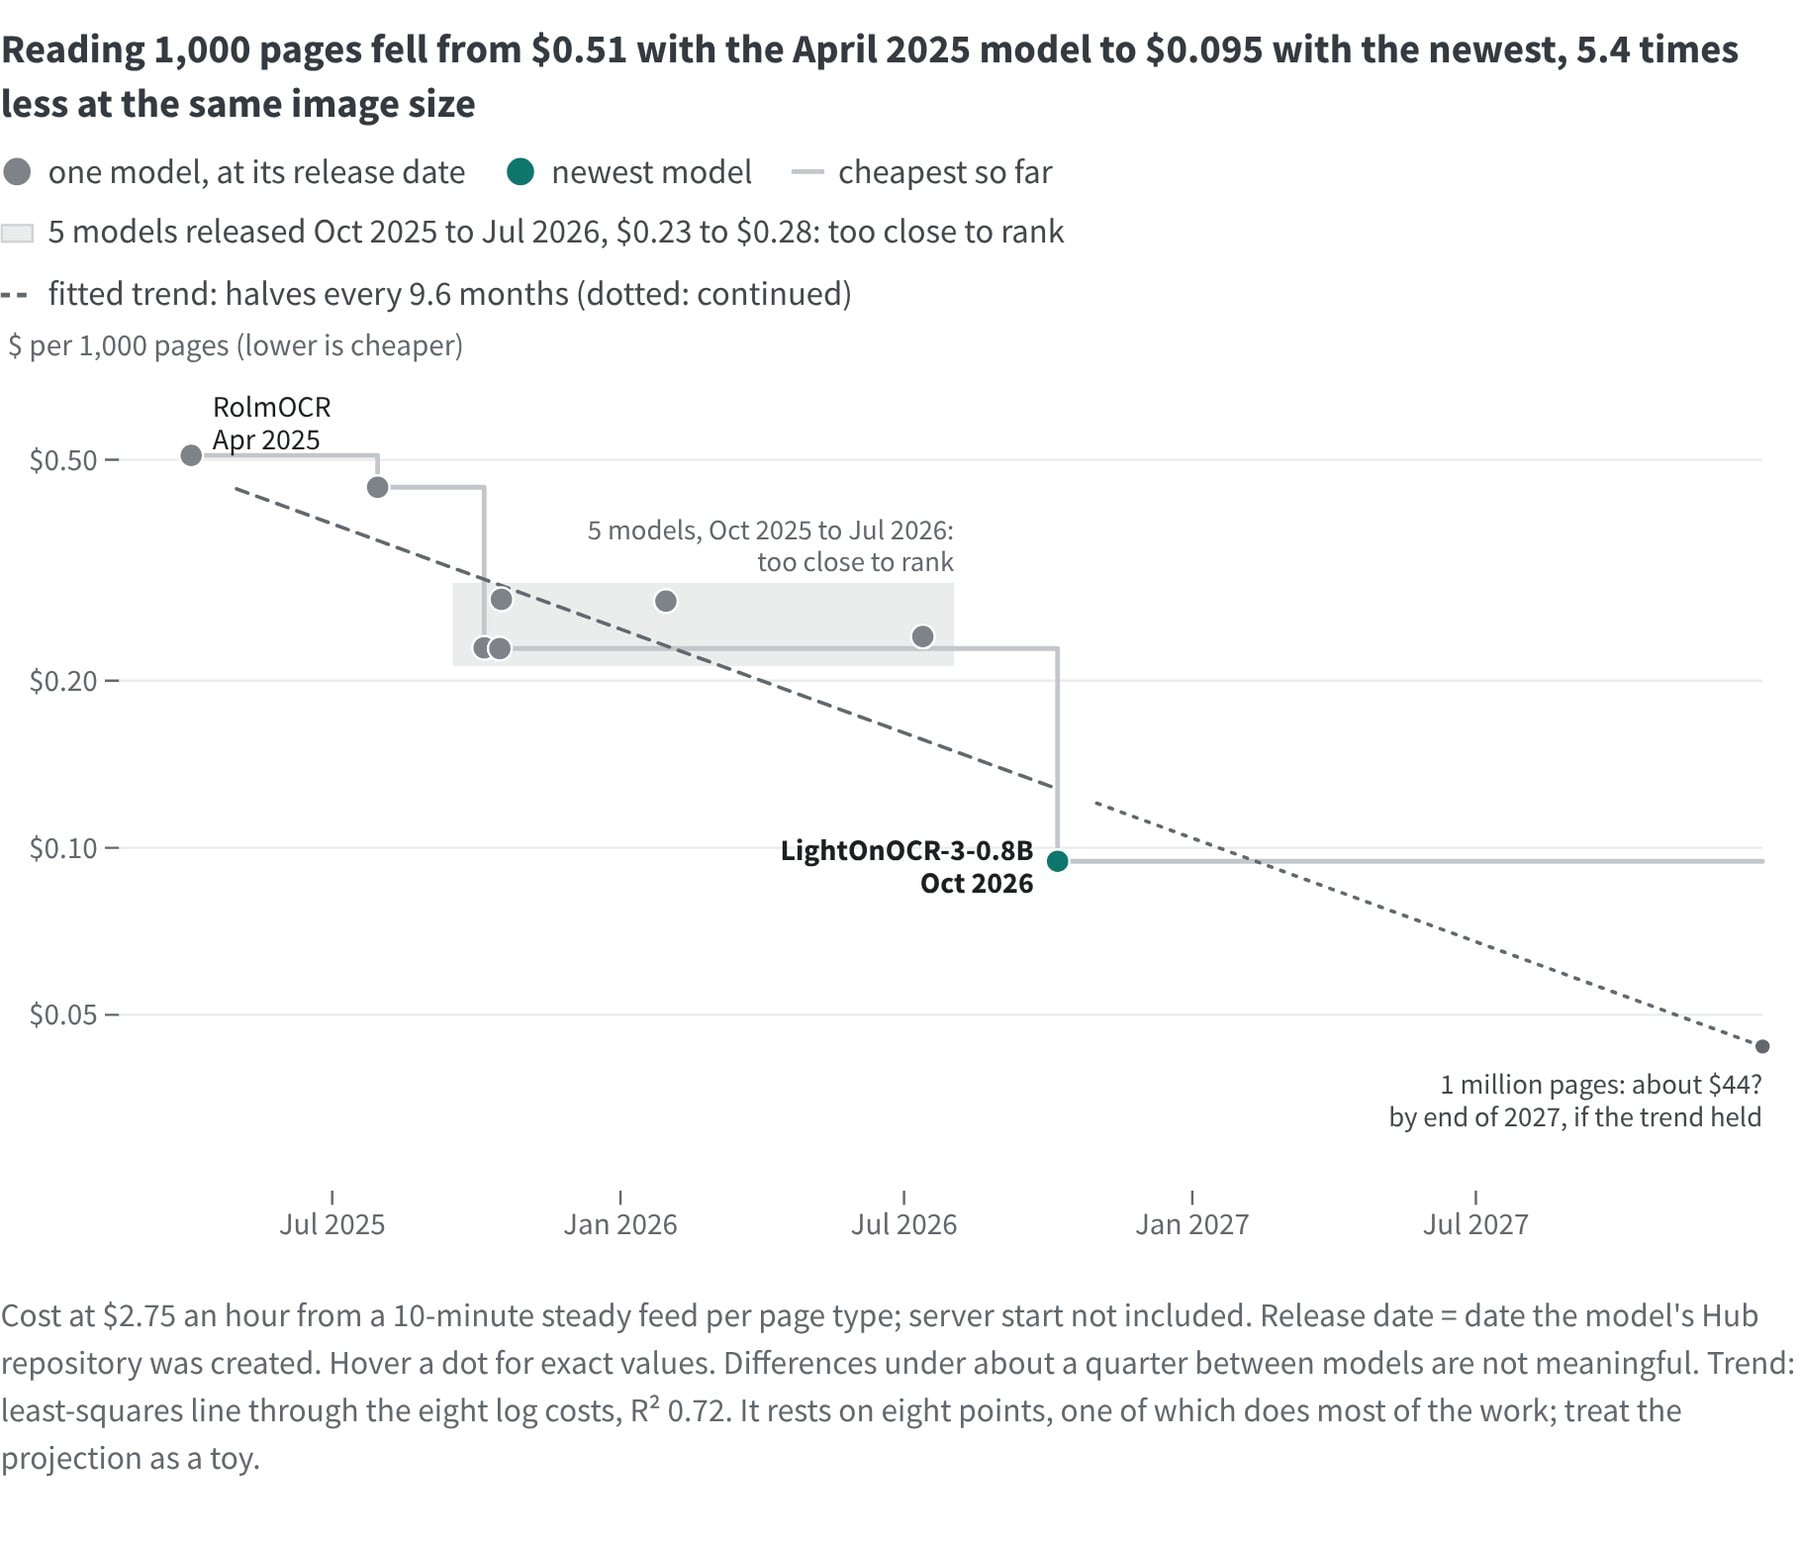
这里比较的是模型从扫描图像中提取文字的计算开销。扫描采集、存储、数据清理、人工校对和服务开发等费用,报道没有给出。
百万页不到 130 美元,是 GPU 租金的量级,不是数字化项目的总报价。
图中的下降趋势也不能直接当成未来报价。虚线延伸到了 2027 年底,但实际测试覆盖的模型发布于 2025 年 4 月至 2026 年 10 月。
为什么把运行流程调顺,也能省下一大笔钱
作者认为,优化模型的运行方式,节省的费用与换用新模型相当,甚至可能更多。他提到四类做法:更均匀地送入页面、缩小扫描图像、更新软件,以及使用更快的 GPU。
这些做法分别影响任务供给、输入规模和执行效率。页面送入不均匀,可能让 GPU 等待;图像尺寸越大,通常需要处理的内容也越多。模型即使没有变化,运行流程仍会影响每页成本。
不过,报道没有给出具体的图像分辨率、软件版本、调度参数,也没有逐项列出这些优化各省了多少钱。读者能拿走的是优化方向,还不能照着复现整套结果。
这里也要分清两组比较:8 个模型的横向测试使用同一款 GPU;「换更快的 GPU」则属于作者讨论的运行优化。原文没有交代后者的完整硬件对照结果。
成本降低也没有解决所有质量问题。最新模型识别书籍页面的准确度至少不逊于最早模型,但部分模型会在空白页上生成不存在的文字,或者反复输出相同内容。
对数字化流程来说,这两类异常很麻烦:任务可能显示成功结束,得到的文本却已经污染了后续检索和归档。
我的判断
这组测试最有价值的地方,是把模型更新和工程优化放进了同一笔成本账。选模型之外,输入尺寸、任务供给和运行环境都值得测。对于已有大量扫描件的团队,这比只看模型排行榜更接近实际问题。
但「便宜且准确」仍有适用范围。850 页覆盖了几类历史材料,却不能据此判断中文文档、复杂表格或手写内容的效果。报道也没有提供准确率数值、评分方法,以及异常发生的比例。「最新模型至少不差」是这组书籍页面上的结论。
优化运行方式能省下同样多的钱,则是作者的实验判断;当前报道缺少分项对照数据,不能把它当成所有团队都能获得的收益。
如果要在这些开放模型、传统 OCR 工具和托管 API 之间选型,原文没有提供直接比较。已有 GPU 批处理环境的团队,可以用这组数字估算计算预算;从零搭建的团队,还需要另算部署、维护和校对成本。
能拿来做什么
- 准备批量处理扫描件时,先选一批自己的文档试跑,同时记录每千页耗时、GPU 费用和识别错误,再估算全量预算。
- 给 Node 文档处理流水线做优化时,可以逐项测试页面供给方式和图像尺寸;缩图之后要复查小字,确认节省的计算没有换来更多校对工作。
- 在 OCR 输出进入检索或归档之前,增加空白页异常和重复文本检查,并保留原始页图,方便回查有问题的识别结果。