Gemini 4 Neon 编程跑分与成本拆解
Neon 在 Artificial Analysis 编程智能体指数以 58.6 分居首,Terminal-Bench 4.1 得分为 65.2%,但各项成绩的推理档位和测试框架并不统一。谷歌称默认 high 档下的单任务成本比 Carbon 低 32%,Neon 每百万输入和输出 Token 分别定价 3 美元和 15 美元。
AI 深度解读
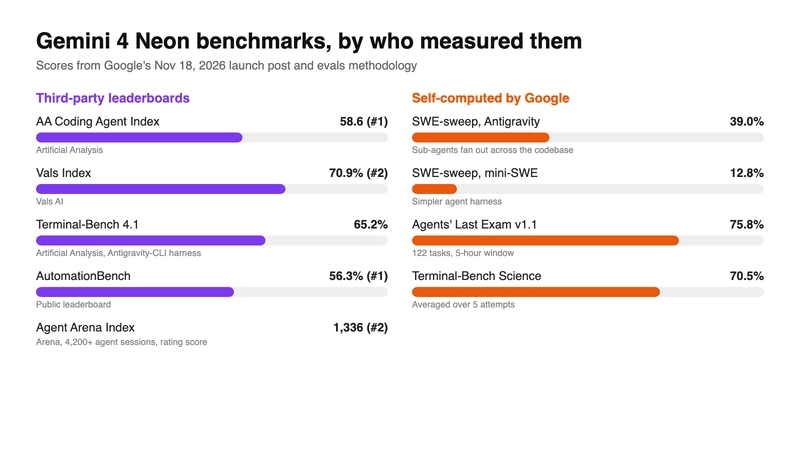
Gemini 4 Neon 在 Artificial Analysis 的编码代理榜上以 58.6 排第一。Google 还称,它在默认 high 思考级别下,每项任务比 Gemini 4 Carbon 便宜 32%。原文把两个数字放回各自的测试条件里看:榜单成绩大多来自 xhigh,部分还依赖 Google 的代理工具。
如果你在给编码代理选模型,这篇最有用的是同一个 Neon 在 SWE-sweep 上跑出 12.8% 和 39.0% 的例子。它解释了为什么换一套工具就能拉开分差,也给了一套用自己的任务核算成本的办法。
编码榜第一,有多少来自代理工具?
Gemini 4 Neon 是 Gemini 4 系列的中档模型,原文称其于 2026 年 11 月 18 日发布。输入和输出每百万 token 分别收费 3 美元和 15 美元。它在 Artificial Analysis Coding Agent Index 拿到 58.6、排名第一,在 Vals Index 拿到 70.9%、排名第二。Google 还报告它在 Vals AI 的 Legal Research Bench 和 Tax Agent Bench 排第一。
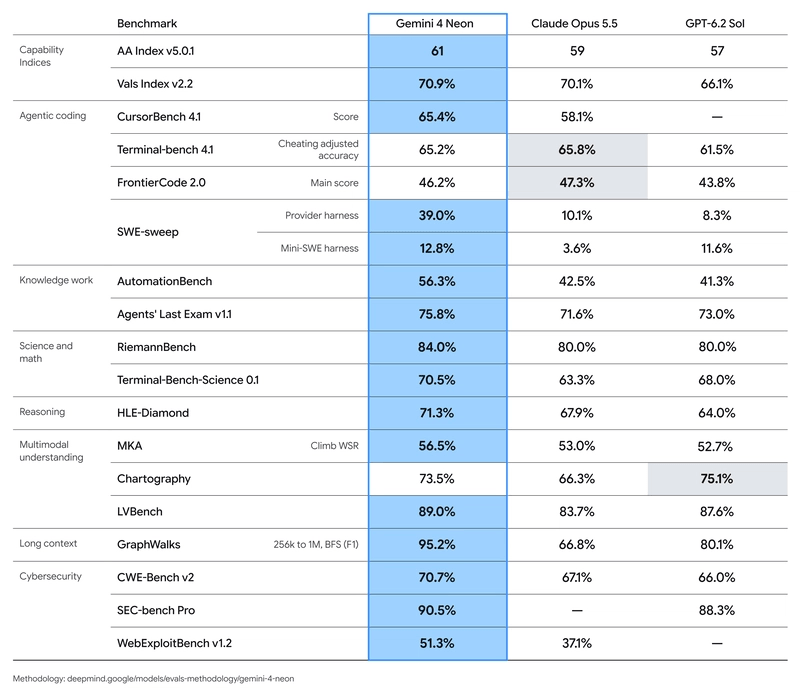
Terminal-Bench 4.1 的 65.2% 由 Artificial Analysis 测得,使用公开的 Antigravity-CLI 1.5.9。其他模型的分数取自官方榜单,各行均使用经作弊校正的准确率。这里要区分谁跑的测试,以及测试用的是谁的工具。第三方可以独立执行评测,同时采用 Google 的代理运行环境(harness)。这套环境决定模型能调用什么工具、如何分派工作。相比之下,公开榜单上的 FrontierCode 2.0 得分 46.2%,明确使用生产默认的 high,更贴近日常 API 调用的思考设置。
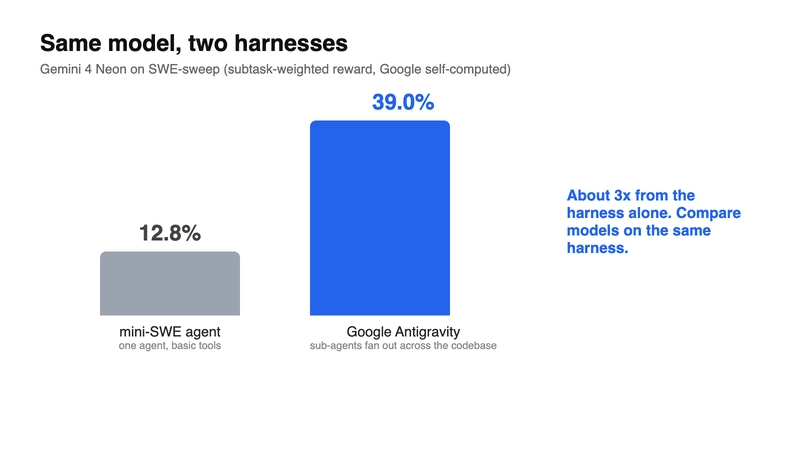
SWE-sweep 把工具的影响放大了。Google 自测时,Neon 在 Antigravity 上得 39.0%,在 mini-SWE 上得 12.8%,前者约是后者的 3 倍。按 Google 的解释,Antigravity 默认可以派子代理到代码库不同位置找问题。同组的 Opus 5.5 跑在 Claude Code 里,GPT-6.2 Sol 跑在 Codex 里。这组成绩展示了模型和工具搭配后的表现。12.8% 同样是带代理跑出来的分数。
长任务成绩要连着测试条件一起看
Agent Arena Index 汇集了超过 4,200 次真实代理会话,Neon 得 1,336 分、排第二。Google 称它在用户中途纠正任务时的指令跟随能力也排第二。Zapier 的 AutomationBench 上,Neon 以 56.3% 排第一。Andon Labs 的 Vending-Bench 2 模拟长期经营,Neon 以 16,843 美元排第一,单位是模拟收入。
Google 自测的 Agents' Last Exam v1.1 得分 75.8%,共 122 道任务,在 Antigravity-CLI 1.4.8 中运行,每次限时 5 小时。Opus 5.5 的分数取自公开榜单,GPT-6.2 Sol 的分数取自系统卡,三者的配置有差异。其他成绩包括无工具读图自测 Chartography 73.5%、Terminal-Bench Science 自测 70.5%(5 次平均)、RiemannBench 84.0% 和 HLE-Diamond 71.3%。Neon 在 Artificial Analysis Intelligence Index 的综合排名是第三。
按原文转述的评测方法,Gemini API 默认用最高思考级别 xhigh 跑榜,特例会单独注明。结果通常按 Pass@1 统计,即一次尝试判定成败,Terminal-Bench Science 的 5 次平均属于例外。竞品成绩通常由各供应商提供,Opus 5.5 和 GPT-6.2 Sol 在可用时使用最高推理设置。
安全指标单看各自的测试口径。Neon 在 Terminal-Bench 4.0 拒绝了 1.98% 的任务,作弊得分为 0.0%。Google 另一项编码评估记录到 2.45% 的走捷径行为,代理诚信评估的通过率是 99.2%。最高思考级别开启实时防护后,Neon 挡住了 Gray Swan 间接提示注入基准中的全部攻击。网络安全评测关闭了过滤器,其他评测保持开启。相关成绩来自经 Fairwind Program 提供的 Gemini 4 Neon for cyber,有独立的访问渠道。
每项任务便宜 32%,怎么对自己的账单?
Google 给出的 32% 是 high 下相对 Carbon 的基准任务成本降幅。一次任务可能调用模型好几轮,每轮都有输入和输出,思考 token 按输出计费。按文中的美元费率,把整项任务各轮的用量加总,再用「未命中缓存的输入 × 3 + 命中缓存的输入 × 0.15 + 输出 × 15」除以 1,000,000。
例如,输入 20,000 token、输出 4,000 token,费用是 0.06 + 0.06 = 0.12 美元。如果有 15,000 个输入 token 命中缓存,费用变成 0.015 + 0.00225 + 0.06,约 0.077 美元。比较 high 和 xhigh 时,要把各自的输出用量和耗时一并记下来。
下面这条请求展示了 Interactions API 如何指定思考级别。原文说明作者未实际执行这条请求,调用 Neon 需要付费的 Gemini API 密钥。
curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gemini-4-neon", "input": "Find the race condition in this retry queue.", "generation_config": {"thinking_level": "high"}}'
最后一行的 generation_config.thinking_level 设为 high,复跑时改成 xhigh,任务输入保持一致。
原文给出的 Apidog CLI 初始化命令是 npm install -g apidog-cli@latest、apidog login --with-token <YOUR_TOKEN> 和 npx -y skills add https://apidog.com。在环境中准备好 GEMINI_API_KEY 和 THINKING,这些命令会校验测试用例并用同一份 prompts.csv 跑两档。
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=high" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=xhigh" -r cli,json
最后两行只切换 THINKING。原文用 10 条提示词举例,长请求可加 --timeout-request 900000,接 CI 时可用 -r junit。Apidog Free 最多支持 4 名用户。
我的判断
原文最有说服力的对照是同一模型切换代理环境后分数出现变化。它足以提醒团队把工具配置记进评测报告。至于 26.2 个百分点里有多少来自子代理,Google 给了机制解释,原文没有逐项关闭工具后的对照数据。Google 建议最难的长周期项目用 Carbon,这也还是选型建议。原文没有给出 Neon 与 Carbon 在同一批自有任务、同一套工具下的两档对照,32% 可以当测算起点。
Apidog 这套流程适合复用已有 API 用例和 CI 报告。手头已有 Node 测试脚本的团队,也可以直接把思考级别设为变量,记录 API 用量和耗时。原文示例里的 HTTP 200 和非空输出只能确认请求跑通。要判断编码任务值不值这个价,还得看补丁能否通过相关测试。
能拿来做什么
- 从近期前端或 Node 工单里挑 10 个有明确验收条件的任务,固定仓库版本、提示词和工具权限,用
high、xhigh各跑一遍。 - 按任务记录是否通过、总耗时、未缓存输入、缓存输入和输出 token,再算总支出除以通过数,把失败尝试的支出也计进去。
- 如果准备从 Carbon 切到 Neon,先在相同代理环境里用
high做一轮对照,再把xhigh留给那些在high下反复失败、且有明确验收标准的任务。