用差分测试验证大模型网关迁移
让新旧路由器运行同一组用例,再归一化结果,对比部署选择、重试、跨供应商调用、回退以及流式响应行为。这样能发现仅比较 HTTP 200 时容易漏掉的回归。
AI 深度解读
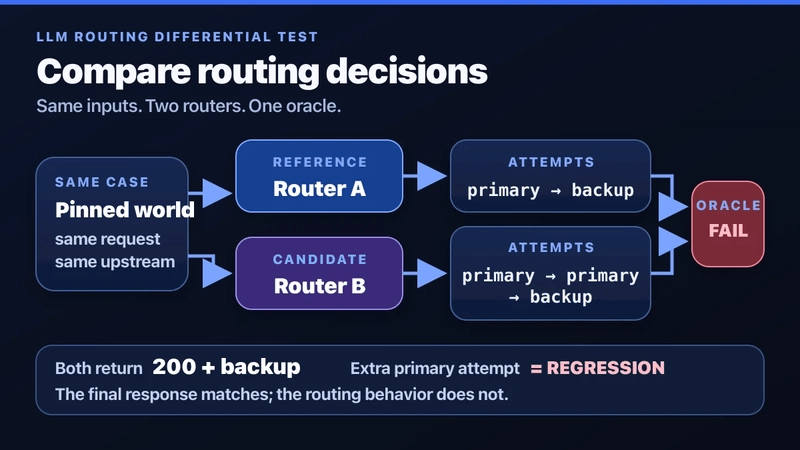
一次 LLM 网关升级后,请求仍然返回 200,也仍由备用部署处理,但新路由器在切过去之前多打了一次主部署。只检查状态码和最终目标,这次回归就会漏过去。
作者给出了一套差分测试做法:让旧版和新版路由器跑同一批受控用例,再比较请求发给了谁、试了几次、流在哪一步结束,以及状态有没有按预期变化。它适合用在网关重写、版本升级、配置迁移和策略重构里,尤其是团队承诺调用方行为保持不变的时候。
两边都返回 200,哪些行为还得对上
LiteLLM 在 2026 年 11 月 11 日分享了把路由迁往 Rust 核心的过程。据原文转述,他们为每个要求保持行为的迁移步骤做了差分测试,检查范围超过了最终选中的部署。作者把这个思路整理成了一套网关验收方法,前提是你能观测到路由决策和每一次上游调用。
先写清楚哪些行为属于契约。调用方关心 HTTP 状态、结构化错误码、响应形状和流式终态。网关运维还要看请求解析到了哪个模型别名、上游尝试的顺序、有没有跨供应商、访问策略放行了谁,以及冷却、限流、会话绑定和用量记录怎么变。同样由备用部署返回 200,["primary", "backup"] 和 ["primary", "primary", "backup"] 就是两种不同的行为。多出来的一次调用会占用重试预算,也可能改变用量。
作者把测试拆成四块。World 固定起始条件,包括部署、别名、健康状态、冷却状态、Redis 数据、凭据和模拟上游。Case 描述一串有顺序的客户端请求与上游响应。Channels 是取证位置,包括客户端、网关日志、模拟上游、状态存储和用量账本。Oracle 是判定规则,决定两份记录在约定的行为上是否等价。比如上游实际收到几次请求,应以模拟上游的接收记录为准。
用例要卡在路由决策会变的地方
先固定两边的镜像、tag、commit 或构建标识,再记录配置与密钥修订哈希、模拟上游版本及场景文件、数据库与缓存种子、客户端协议和流式模式。用 AISIX 时,还要记录别名对应的是直连模型、多目标模型还是语义路由,以及网关是独立部署还是托管部署。失败后能否复现,取决于这些条件是否跟着用例一起保存。
接着按分支造用例。正常走主部署是一种,主部署返回 503 后切到备用部署是一种,未授权和请求格式错误还要断言没有上游调用。区域标签、团队覆盖、按价格排序、粘性分配、语义路由和供应商特定请求头,则按实际启用的策略补上。流式请求尤其要拆开测。按原文转述的 AISIX 文档,响应字节提交前还可以换目标,流开始后则不会故障转移。测试要把故障分别放在首字节前和开始交付后,并以实际运行的端点、策略和版本为准。
取证也有版本细节。AISIX 1.10.0 的 x-aisix-served-by 需要在启动时读取 proxy.expose_debug_headers: true,默认关闭。开启后,它也只出现在符合条件且成功的 /v1/chat/completions 路由响应里。原文建议默认用 x-aisix-request-id 关联访问日志里的 served_by_model,或者直接查模拟上游的捕获记录。
比较前先过滤噪声,再让旧版和自己跑两遍
请求 ID、时间戳、生成的响应 ID、临时端口和日志顺序都可能变化。哪些字段可以过滤,要在看新版结果前定下来。目标、尝试顺序、上游方法与路径、模型、工具字段、关键请求头和策略结果,只要关系到契约就应该保留。日志可以按稳定标识整理,上游尝试的先后顺序则要单独记录。
下面两行是原文的 reference.jsonl,把主部署直出和主部署 503 后切换的预期保存成可比较的记录。
{"case_id":"primary-200","status":200,"attempts":["primary"],"target":"primary","terminal":"complete"}
{"case_id":"primary-503-fallback","status":200,"attempts":["primary","backup"],"target":"backup","terminal":"complete"}
看第二行的 attempts,候选结果即使同样得到 200、backup 和 complete,多一次 primary 也会被查出来。
原文用下面的命令按 case_id 比较两份 JSON Lines,并报告差异以及缺失或多出的用例。
python3 compare_routes.py reference.jsonl candidate.jsonl
这行命令默认逐字段比较,已经判定为噪声的字段才通过可重复传入的 --ignore 指定。按原文示例,候选结果多一次 primary 时退出码为 1,改回 ["primary", "backup"] 后退出码为 0,输出 PASS: 2 cases are equivalent。比较器吃的是已经整理好的记录,采集要另外接。所给原文里的 Python 脚本排版有损,无法直接复制运行。
在比较新旧版前,先用同一个旧版跑两遍。如果结果已经不同,优先查共享 Redis 状态、随机权重、真实供应商响应、TTL、退避、异步日志,以及客户端 SDK 是否也在重试。固定种子、隔离状态、使用受控时钟或给时间断言设范围,都能让失败更好定位。如果随机分配就是产品契约,就单独测分布。
我的判断
我最认同的是把上游尝试序列放进验收标准。只看请求成功率看不到额外的重试,而去模拟上游数收到几次请求,比从网关的一条成功日志推断更直接。比起只写一组针对新版的规格测试,差分测试可以借旧版的行为快速补齐迁移用例。不过旧版有错也会通过,所以会影响权限或重复调用的规则,仍然值得单独写规格断言。
原文展示的是构造出来的两条样例,以及 LiteLLM 的迁移经验。它没有给出生产回归检出率、新旧版的成本或延迟对照。即使用量账本出现差异,也得先弄清一行记的是客户端请求还是上游尝试。要比较延迟或成本,还得控制供应商、模型、缓存、并发、地理位置和定价。
预期变化适合写方向明确的断言。比如新策略要求鉴权失败时停止重试,就把用例标成 expected_change,要求只发生一次返回 401 的上游尝试,并且没有 fallback。必须等价的用例标成 must_match,暂时只收集结果的标成 informational。这种区分也方便上线前给差异指定处理人,并确认回滚时能恢复与旧版兼容的状态和配置。
能拿来做什么
- 如果你维护接 LLM 的 Node 网关,先用模拟上游覆盖主部署成功、
503后切备用、未授权和请求体格式错误。对成功用例断言上游尝试顺序,对拒绝用例断言零上游调用。 - 如果前端通过网关接收流式输出,用两条用例分别制造首字节前失败和已经收到内容后的失败,同时记录客户端看到的终态与网关的实际尝试顺序。
- 把旧版对旧版的稳定性检查接进 CI。让客户端 SDK 和网关之间只有一处负责测试中的重试,并让每个用例从隔离的状态开始。
- 确定性用例通过后,可以用获准且已脱敏的代表性请求形状做小规模影子回放。候选响应不发给用户,涉及副作用的工具调用只有在获得明确授权并具备控制措施时才允许复制。