英伟达开源 Flora,降低机器人视频标注成本
据报道,Flora 基于三个微调的 Qwen3.5 模型,将每小时机器人视频的标注费用从 GPT-6 Astra 的 88 美元降至 0.72 美元。其整体质量评分略高,动作错误识别表现突出,但描述准确性仍有短板。
AI 深度解读
机器人训练视频的难点,不只是识别画面里发生了什么,还要标清动作起止、判断中途是否出错,以及最后完成得怎么样。Nvidia 开源的 Flora,把这些工作交给了三个经过微调的模型,并宣称每小时视频的标注成本可降到 0.72 美元。
但「比 GPT-6 Astra 便宜 125 倍」需要拆开看:成本来自估算,效果也随任务变化。它更有价值的地方,是展示了专用模型如何在大规模视频处理中,把时间定位、文字描述和奖励评分分别做好。
三个模型,解决的不是同一种标注
按照 Nvidia GEAR 实验室的划分,机器人视频需要三类标签:动作在什么时候发生,用来筛选训练素材;每一步做得怎么样,用来支持试错学习;整段任务是否成功,用来监控部署中的机器人。已有工具往往只覆盖其中一类,通用大模型能兼顾多类,但批量处理成本较高。
Flora 使用三个微调后的 Qwen3.5 模型。9B 模型负责切分动作,27B 模型结合动作前后的上下文生成描述,另一个 27B 模型 Flora-Rewarder 负责评分。
Flora-Rewarder 会根据提示词切换三种工作:给整段任务打 1 到 5 分;每隔半秒,把步骤分成正常、欠佳或失败;按照自定义评分标准打分。最后一种就是 rubric,可以理解为先写清评判条件,再让模型逐项判断。
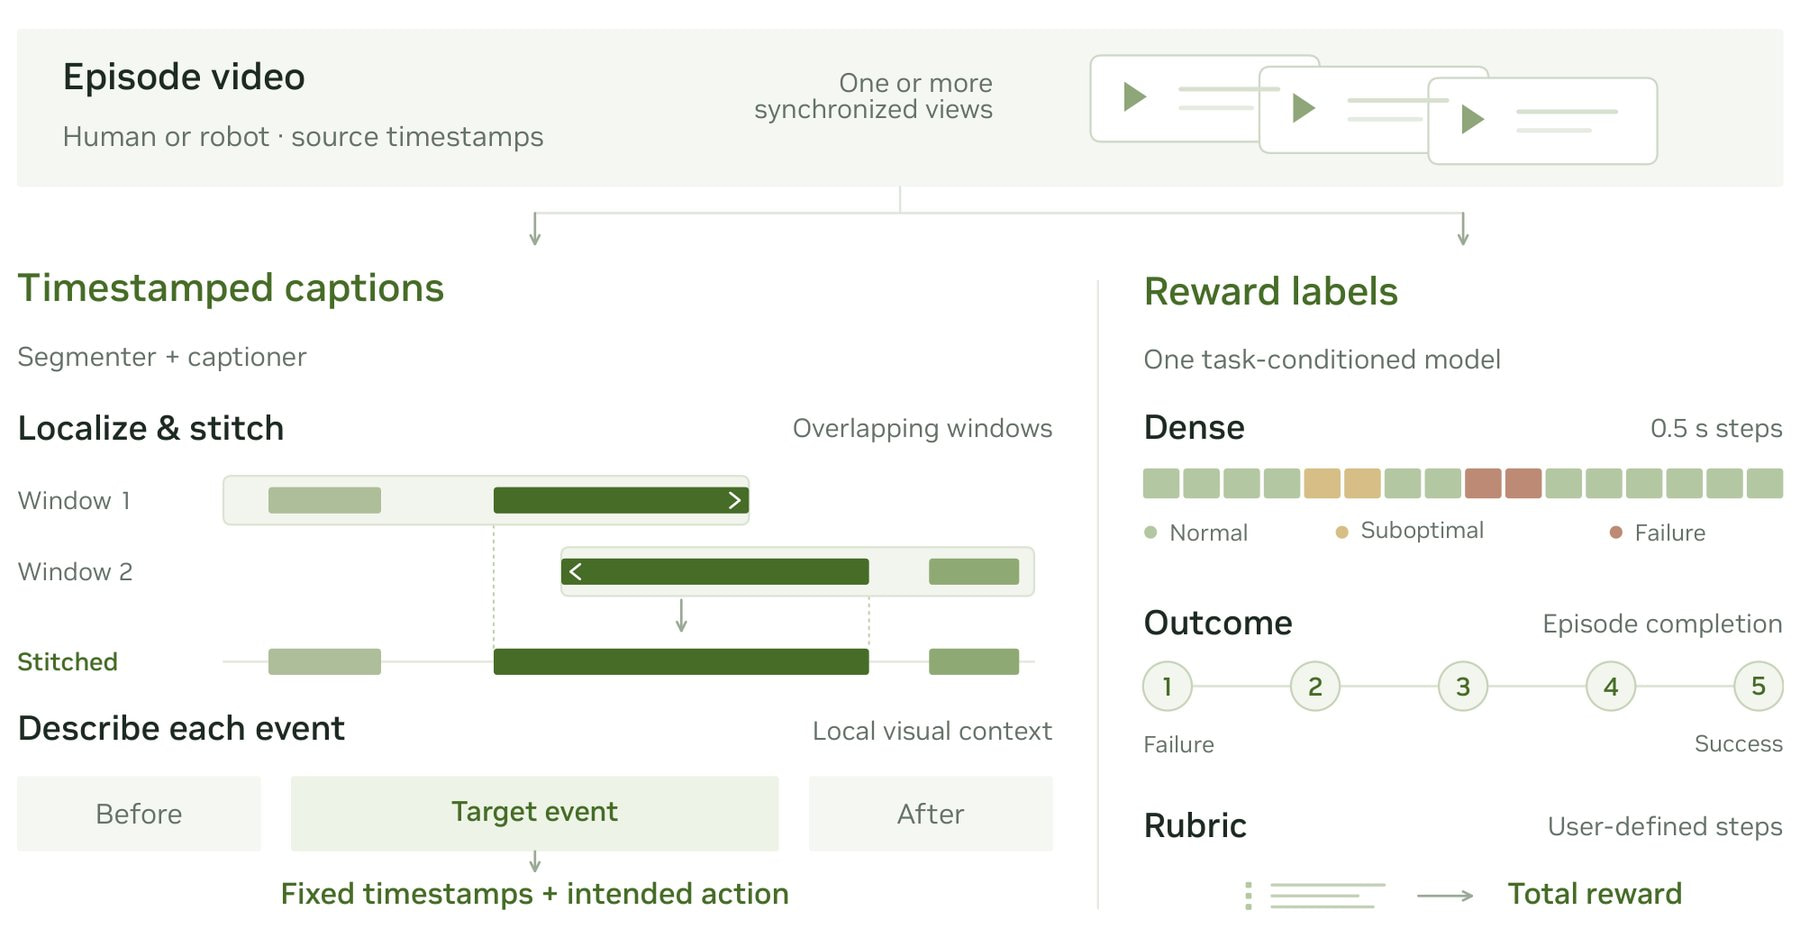
这种拆分有实际理由。动作边界找得准,不代表文字一定写得对;最终完成了任务,也不代表中途没有失败。让同一套评价覆盖所有问题,容易把不同能力混在一起。
Nvidia 称,Flora 已用于 GR00T 模型训练,在 512 块 GB300 GPU 上每天最多标注 200,000 小时视频,模型已在 Hugging Face 提供。这说明它服务于具体的数据生产流程。不过,这一吞吐量是 Nvidia 的披露,原文没有提供独立验证。
「便宜 125 倍」成立到哪一步
在 Nvidia 的一项 50 段视频测试中,Flora 的标注质量为 57.1%,GPT-6 Astra 为 53.7%。后者获准使用完整推理能力,仍略低于 Flora。
成本差距更显眼:每小时源视频,Flora 约为 0.72 美元,GPT-6 Astra 为 88.49 美元,正文另取整为约 88.50 美元;Claude Opus 5 约为 42 美元,在该测试中的成绩也更差。
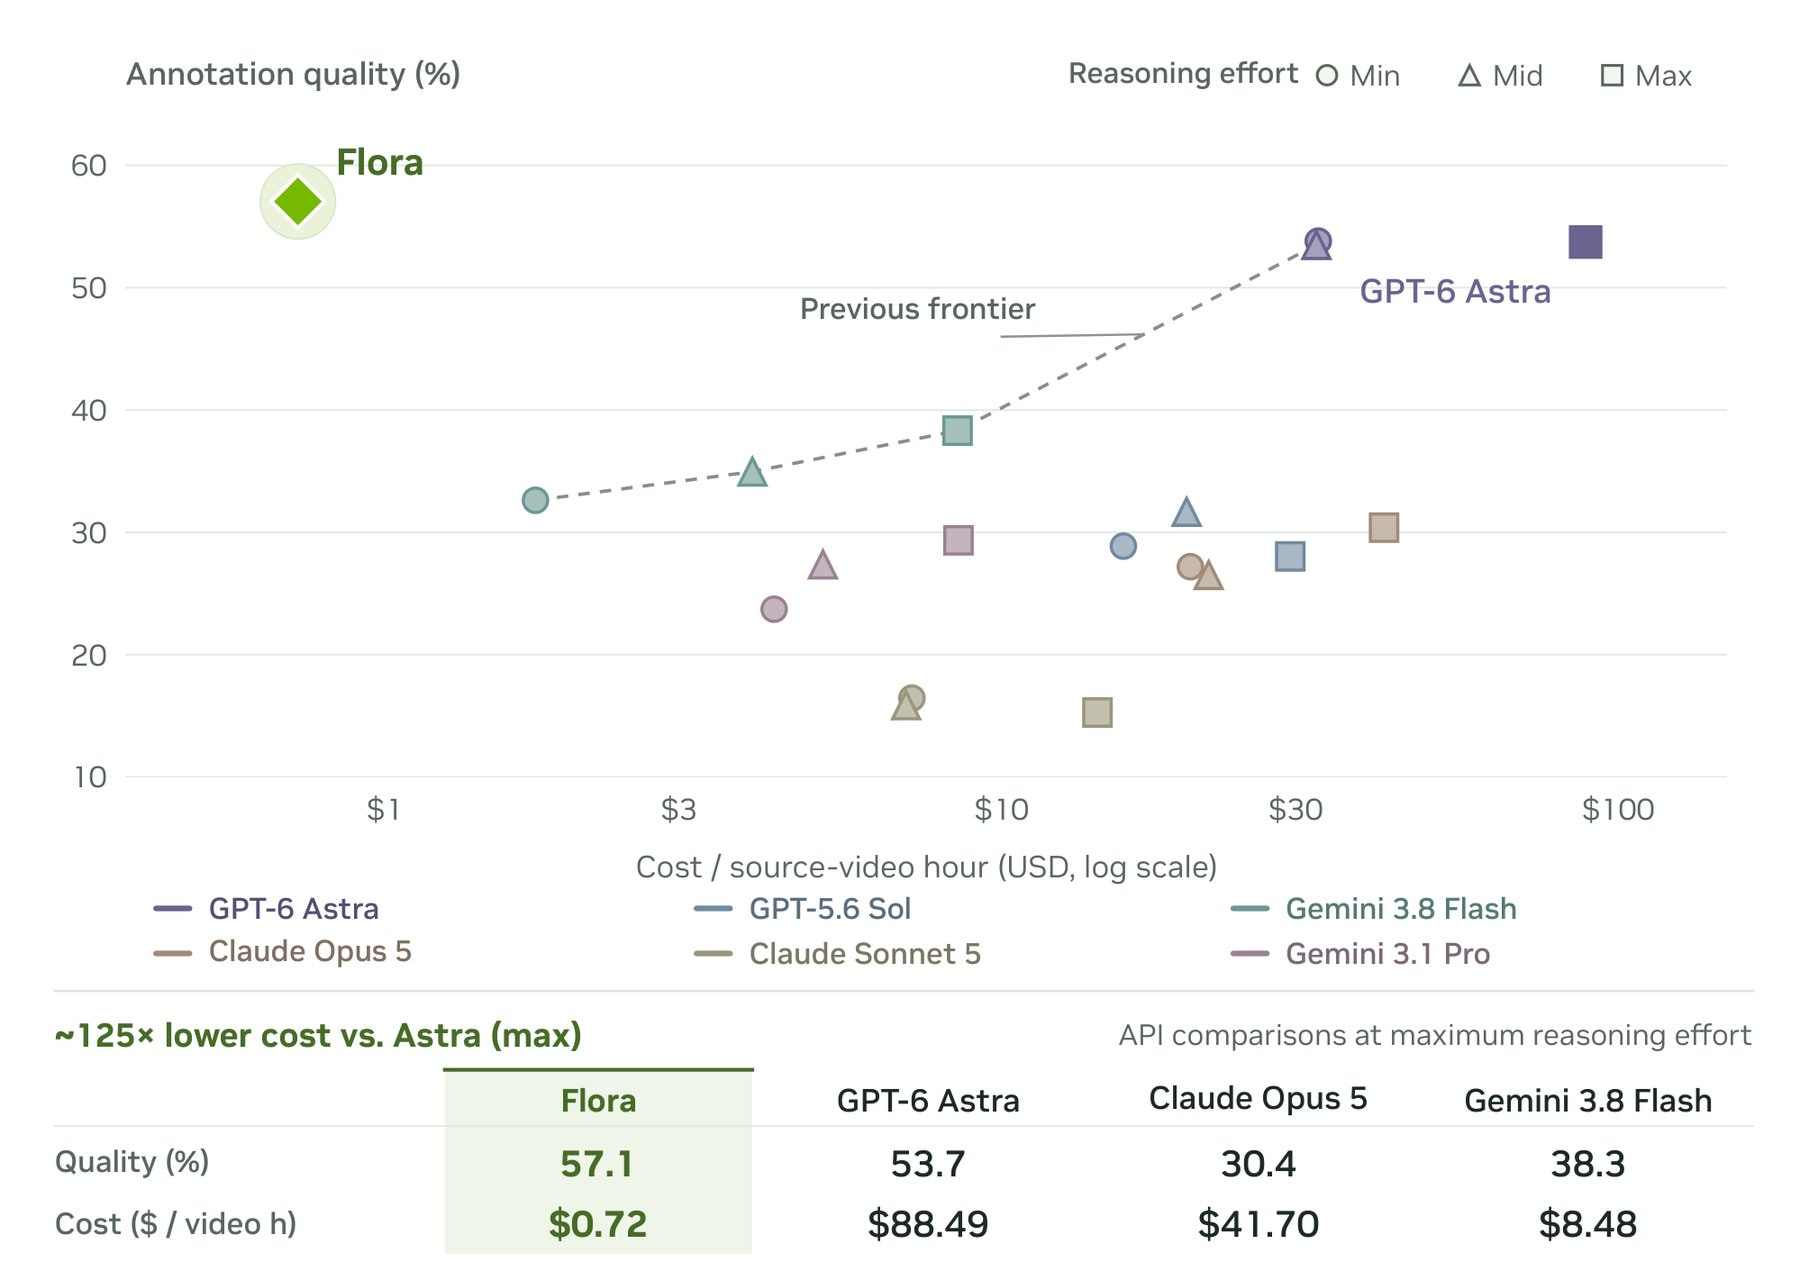
0.72 美元是基于每块 GPU 每小时租金 10 美元推算的成本,不是生产环境的实测账单。
因此,标题中的「最高便宜 125 倍」适合用来理解量级,不能直接放进采购预算。一般团队未必能获得相同的硬件利用率和批量规模,原文也没有交代成本是否完整包含视频预处理、存储、调度及人工复核。
质量数字同样不能当成通用胜率。换到公开的 WGO-Bench,Flora 最擅长检测动作边界,但总分落后于 GPT-6 Astra,纯描述准确性也低于 Gemini 3.8 Flash。研究者认为,它的主要增益来自时间定位,也就是把动作发生的区间找准。
在 Nvidia 自建的 DenseCaptionBench 中,Flora 在人类视频的各项指标上领先,但机器人视频仍排在 Astra 后面。研究者还承认一个评价方法上的问题:GPT-6 Astra 既参加测试,也负责评价描述。这个安排可能影响结果,但仅凭原文,无法判断影响的方向和幅度。
真正拉开差距的是中途失败检测
Flora 最突出的表现,出现在「任务没有彻底失败,但也没有完整成功」的情况。
例如,目标是把瓶子碰落桌面,机器人却只把瓶子推倒。Flora 给出 3/5 分,与人工参考一致,Astra 则只给 1 分。在 RoboRewardBench 上,Flora 的错误率比 Astra 低 27.8%。这里是相对降幅,不能读成降低了 27.8 个百分点。
逐步检查的差距更大。Flora-Rewarder 能检出一段任务中 53.3% 的失败步骤,其他参评模型都没有超过 11.7%,Astra 在这项测试中没有检出失败步骤。
代价也很明确:Flora 会把约 11% 的正常步骤误报为错误。若这些标签直接进入训练流程,就需要考虑误报会怎样影响后续学习。对于自定义标准评分和轨迹排序,Astra 仍然领先。
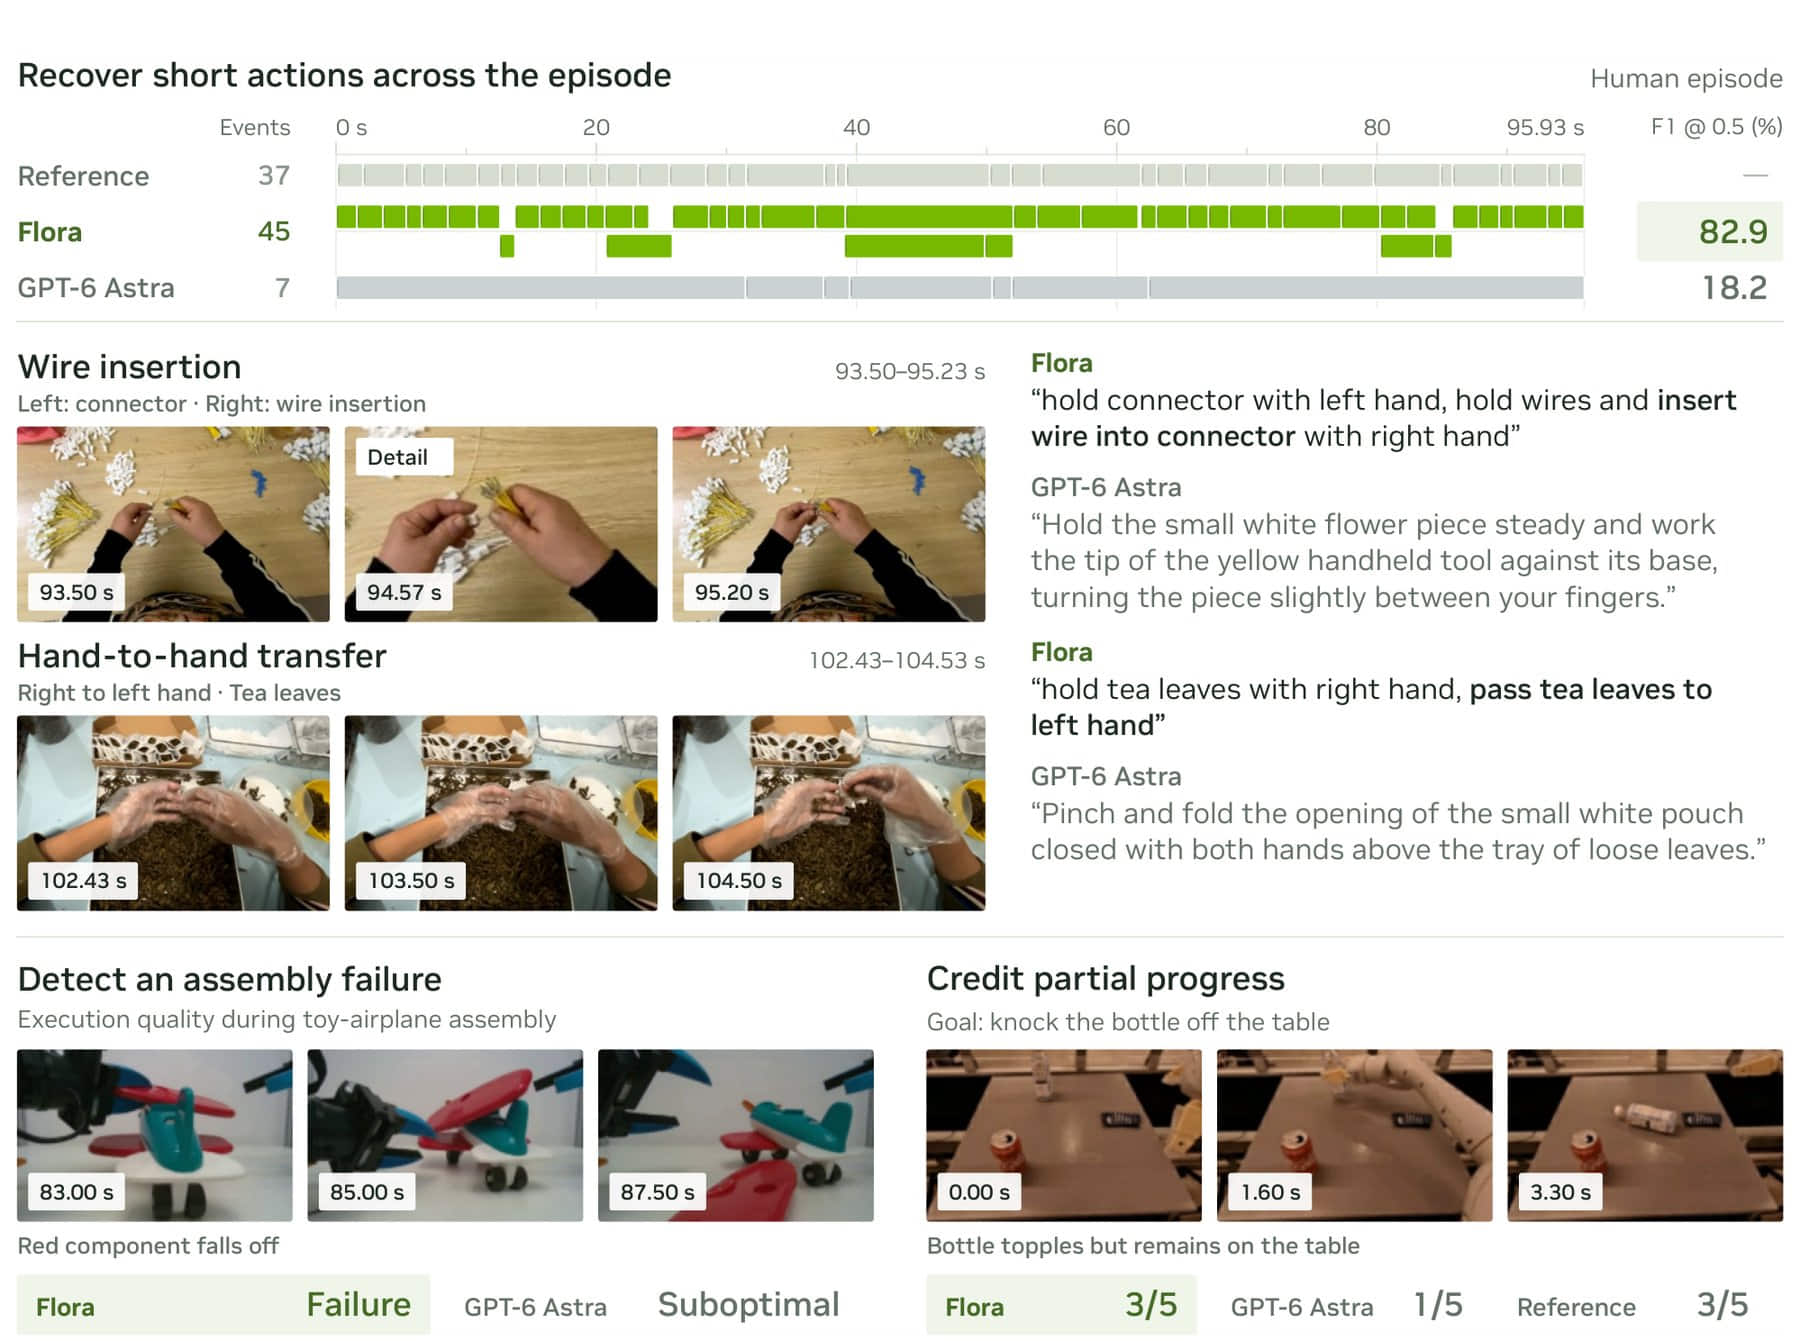
另一个短动作密集的视频中,Flora 找到了 37 个参考动作中的 34 个,Astra 只找到 4 个。但 Flora 有时也会把长动作切得过碎,还曾把机械手用布擦盘子描述成折餐巾。
Flora 的优势是更细地检查过程,不能据此推导出它对每个动作都理解得更准确。
我的判断
我认为,这篇最有参考价值的是任务拆分,而不是价格标题。对于需要时间戳、步骤标签和成败评分的数据流水线,专用模型有机会比一次性调用通用大模型更合适。原文中的动作定位和失败检测结果,为这个方向提供了证据。
但证据还不足以支持「全面替代」。50 段视频测试的覆盖范围有限,自建基准和模型兼任评委也需要谨慎解读。原文没有给出完整生产成本,更没有直接比较 Flora 与 Scale AI 的 Physical AI Data Engine 在人工复核、交付质量上的差异。
与通用模型相比,Flora 展示了更强的部分专项能力;与人工标注服务相比,原文尚未提供足够对照数据。把它当作可试验的开源数据引擎,比把它当作已经证明最便宜的完整服务更稳妥。
Nvidia 的动机也清楚:把硬件、训练数据、仿真和模型串起来,持续吸引开发者使用其计算平台。此前 GTC 展示的数据准备、扩增与评分流水线,加上 Flora 的细粒度标签,服务于同一方向。Google 最近公布的 Gemini 4 Argon 也在识别训练视频步骤、标记失败动作,说明这一环节正在成为竞争重点。
能拿来做什么
- 如果团队正在处理机器人演示视频,可以先选一批已有人工标签的素材,分别验证动作边界、描述准确性和失败检出率,再决定哪些环节适合交给 Flora。
- 如果用 Node 搭建视频标注任务队列,可以参考它的拆分方式,把切分、描述和评分做成独立阶段,分别记录耗时、失败重试和复核结果,方便定位质量问题。
- 如果前端需要展示或审核这类标注,可以把时间轴、动作描述、步骤评分和最终结果并排呈现,让审核者能直接定位到对应视频片段。
- 如果准备估算处理成本,应按自己的视频量和硬件利用率重新计算,并单独计入复核工作;0.72 美元适合作为待验证的参考值。