LINE Agent 从原型走向生产的工程实践
系列以 LINE 名片助手为例,介绍 Go 与 Google ADK 工作流、并行研究、人工介入及多渠道接入。摘录还涉及无状态容器中的会话持久化和跨实例暂停恢复,呈现 Agent 生产化的关键问题。
AI 深度解读
AI Agent 能识别名片、补全公司信息、等待用户确认,还不算完成上线。真正接入业务后,团队还得回答:环境能否重建,改坏 Prompt 能否拦住,哪一步拖慢了请求,部署失败后能否定位到具体版本。
这篇系列收官文章,讲的是作者如何给 LINE AI Card Assistant 补上 Terraform、评估门禁、分阶段发布和节点追踪。它的价值在于把这些环节接成一条交付链;不过,原文展示的验证证据,还不足以证明系统已经经受住真实生产流量。
上线需要补齐的,是一条可重复的交付链
作者此前用 Go 和 Google ADK 2.0 搭建了名片助手:Vision OCR 识别图片,通过 AddFanOut / AddFanIn 并行补充信息,再用 NewRequestInputEvent 实现人工介入(HITL)。随后拆出 Cloud Run LINE Webhook Gateway,把执行交给 Agent Runtime,用 GCS 保存图片、Agent Platform Sessions 恢复会话,并将名片库迁至 Cloud SQL PostgreSQL。
最后的 Phase 5 要解决四件事:基础设施配置漂移、PR 缺少 AI 质量检查、测试环境到生产环境的发布控制,以及工作流内部耗时不可见。
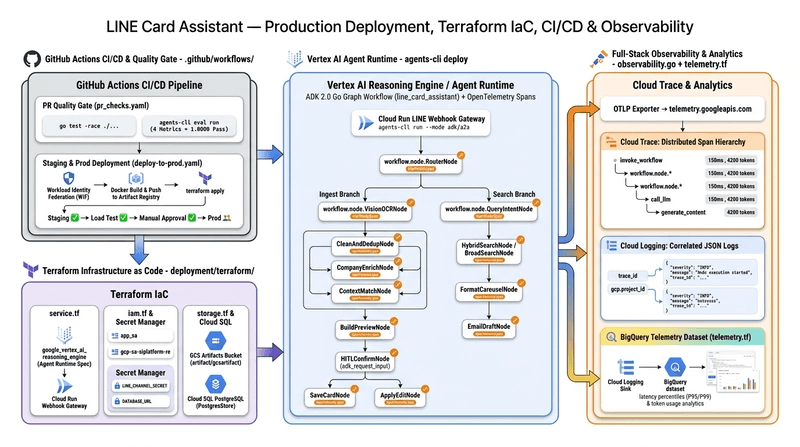
作者用下面的命令,为已有项目补充生产部署骨架:
uvx google-agents-cli@1.10.0 scaffold enhance . \
  --cicd-runner github_actions \
  --region asia-east1 \
  --yes
这里要看 scaffold enhance .:它根据 agents-cli-manifest.yaml 中的 adk_go 和 agent_runtime 配置增强现有工程。按作者描述,原来的 app/、internal/、eval/、sessions/ 保留,同时新增 Terraform、GitHub Actions 和端到端测试目录。
接下来仍需定制 LINE 凭据、数据库权限及区域配置。脚手架交付的是起点,业务所需的权限和发布约束还得自己补。
Terraform 使用 google-beta provider 的 google_vertex_ai_reasoning_engine 声明运行实例,再把日常代码更新交给 agents-cli deploy。其中 lifecycle.ignore_changes 实际忽略了 spec[0].source_code_spec 和 spec[0].container_spec。这种分工可以减少两套工具互相覆盖,但也要求团队清楚:被忽略的字段,后续不能指望 Terraform 自动纠偏。
凭据则进入 Secret Manager。作者为 Vertex AI Service Agent 和 Agent Identity Principal 授予 roles/secretmanager.secretAccessor、roles/cloudsql.client,部署时通过 --secrets="LINE_CHANNEL_SECRET=line-channel-secret,LINE_CHANNEL_ACCESS_TOKEN=line-channel-access-token" 注入 LINE 凭据。原文也声明了数据库连接串对应的 secret,但这条部署参数没有展示 DATABASE_URL 的注入方式。
请求耗时 2.8 秒,必须知道慢在哪个节点
原文用一次名片处理耗时 2.8 秒提出问题:到底是 OCR 慢,还是公司信息检索慢?这个数字是问题示例,不能当成性能测试结论。
已有的 observability.go 配置了指向 telemetry.googleapis.com 的 OTLP HTTP Exporter,并通过 Google ADC 自动认证。但请求级追踪只能看到整体,作者因此在每个工作流节点外增加 OpenTelemetry Span,也就是一段带起止时间和属性的执行记录。
下面是搜索节点的接入方式:
func newHybridSearchNode(cardStore store.CardStore) *workflow.FunctionNode {
    return workflow.NewFunctionNode(
        NodeHybridSearch,
        func(ctx agent.Context, _ any) (ev *session.Event, err error) {
            spanCtx, span := startNodeSpan(ctx, NodeHybridSearch, AttrInvocationID.String(ctx.InvocationID()))
            defer func() {
                routeAttr := ""
                if ev != nil && len(ev.Routes) > 0 {
                    routeAttr = ev.Routes[0]
                }
                endNodeSpan(span, err, AttrWorkflowRoute.String(routeAttr))
            }()
            // ... execute cardStore.HybridSearch(spanCtx, filter) ...
            span.SetAttributes(AttrSearchMatches.Int(len(cards)))
            // ...
        },
        workflow.NodeConfig{},
    )
}
重点是向下传递 spanCtx,让数据库调用等后续操作有机会接入同一条追踪链;defer 则统一记录错误和出口路由。这是省略业务逻辑的片段,不能直接复制运行。
作者给 Span 加入节点名、Invocation ID、Session ID、名片信息、搜索命中数及 HITL 动作等属性。示意图中,OCR 为 640ms,并行分支分别为 8.5ms、780ms、310ms。它说明并行流程要沿关键路径找瓶颈,不能直接相加;原文没有提供这些耗时的采样条件。
作者还使用 tracetest.NewInMemoryExporter() 检查 Span,覆盖名片识别、HITL 修改与保存,以及搜索零结果后降级模糊查询。这样的测试能验证埋点结构,但无法证明云端导出、采样和查询链路都已正常工作。
分析侧,Terraform 创建保留 365 天、开启 enable_analytics = true 的 Cloud Logging Bucket,再通过 google_logging_linked_dataset 关联 BigQuery。这里展示的是日志分析通路;P95/P99 和 Token 成本能否算准,还取决于实际记录了哪些字段,原文没有给出完整查询。
评估门禁要进 PR,生产发布仍要有边界
作者把 CI 分成三层:
go test -race -v ./...检查单元测试、并发问题、工作流轨迹和 Span。go test -v -tags=e2e ./e2e/integration/...启动真实 ADK Universal Launcher 子进程,验证/.well-known/agent-card.json、/a2a/invoke和/apps/app/app-info。agents-cli eval run执行 6 个黄金案例,要求四项指标均为1.0000。
四项指标分别是 workflow_trajectory_accuracy、ocr_and_enrichment_quality、duplicate_and_hitl_precision、search_and_email_grounding。它们把业务行为放进 PR 检查,比只检查程序能否编译更接近 Agent 的实际风险。
评估进入 CI 很有价值,但小样本满分只能说明既定案例通过。
合并到 main 后,流水线通过 Workload Identity Federation(WIF)获取短期凭据,使用 uvx google-agents-cli@1.10.0 deploy 部署 Staging。随后运行基于 tsenart/vegeta/v12 的 e2e/load_test/load_test.go,持续压测 30 秒,检查 HTTP 200 成功率、P50/P95/P99 延迟及 429 比例,报告归档到 gs://${LOGS_BUCKET_NAME_STAGING}/load-test-results/。通过后触发生产流程,再由 GitHub production Environment 的 Required Reviewers 审批。
但原文没有给出压测请求速率、并发数、通过阈值和实际结果,也没有说明回滚策略。它还写了 OTEL_RESOURCE_ATTRIBUTES=service.version=$,版本值明显不完整,不能据此复用配置。
作者明确报告的本地验证包括:带 --project line-vertex --region asia-east1 --dry-run --no-confirm-project 的部署预检、go test -v -tags=e2e ./...,以及 DRY_RUN=true make eval。预检和测试全部通过,6 个案例的四项指标仍为 1.0000。这些证据支持「相关检查通过」,尚不能推出生产部署和高并发验证已经完成。
我的判断
这套方案最值得借鉴的,是把基础设施、业务评估和问题定位一起纳入交付流程。对于有并行节点、外部检索、人工确认和持久化状态的 Agent,只看接口成功率,确实很难判断业务是否正确执行。
但「生产级」需要更多证据。6 个黄金案例不足以覆盖 OCR 噪声、检索波动和长尾输入;DRY_RUN=true 的具体执行范围,原文也没说清。四项满分是项目内的回归结果,不是通用质量保证。
与普通容器部署相比,托管 Agent Runtime 加 Terraform 更贴合作者现有的 Google Cloud 技术栈,但文章没有提供运维成本、费用或故障恢复的对照数据。选型优势仍属作者的实践判断。
另外,追踪属性包含用户、公司和搜索关键词,365 天日志保留也会带来成本与数据管理问题。原文没有展开脱敏、采样和保留策略,照搬前需要补齐这些约束。
能拿来做什么
- 给日常 AI 编程项目建立一小组业务回归案例,把「重复数据如何处理」「用户修改后是否保存正确」「零结果如何降级」放进 PR 检查,并逐步吸收线上失败样本。
- 在 Node Agent 或后端工作流中,先给模型调用、外部搜索、数据库查询和人工等待边界补 Span,沿调用链传递上下文,让耗时能够归因到具体步骤。
- 已有 Staging 的团队可以增加压测报告归档和生产审批,同时明确请求速率、延迟阈值、429 容忍度及回滚条件,让发布判断有据可查。
- 使用脚手架增强已有项目时,先核对 Terraform 与部署命令各自管理哪些字段,再检查凭据注入和版本标记,避免生成配置与真实发布流程脱节。