用Python拆解文本转SQL执行准确率
作者自报NL2SQL系统在BIRD Mini-Dev的500题中答对419题,较同一基础模型使用官方固定提示词多答对78题,但仍低于文中列出的三项官方基线。文章用25行Python评估器展示结果去重、顺序忽略、条件碰巧等价及超时对评分的影响。
AI 深度解读
83.80% 看起来是一个模型成绩,拆开后却更像一份工程诊断报告:同一个模型,固定提示词拿到 68.20%,接上执行与修正流程后升到 83.80%。提升既来自查询结果的修正,也来自空响应和超时的恢复,期间还有 11 道原本正确的题被改错。
这篇来自系统开发方 VIDRAFT 的自测,值得读的不是排名,而是它展示了该怎样读懂 NL2SQL 成绩:结果一致不等于逻辑正确,输出预算、超时和机器负载都可能进入分数。
83.80% 证明了系统有效,但没有证明排名领先
BIRD Mini-Dev 是自然语言转 SQL(NL2SQL)基准,包含真实数据库上的 500 个问题。输入通常包括问题、数据库结构,有时还附有上下文说明(evidence),模型负责生成 SQL。
作者在 2026 年 10 月 29 日,用 10 月 28 日修订版数据集评测 Darwin-180B-NL2SQL,报告 SQLite 上答对 419/500,准确率为 83.80%。
同一版数据集的官方固定提示词基线中,Claude Opus 5.5 为 90.00%,GPT-6.1 Sol 为 88.00%,Claude Sonnet 5.5 为 86.60%,都高于这个结果。作者也明确承认,两边的调用方式不同:基线每题只调用一次,他们的系统会执行查询,再根据结果决定是否修正。
系统使用已发布的 Darwin-180B-RSI 权重,没有为这次结果新增训练。作者声明,不使用参考 SQL,不获取上下文说明之外的「预知答案」,没有针对 BIRD 微调,每题只提交一个最终候选。
因此,更有价值的比较是同一底座:官方固定提示词得到 341/500,系统得到 419/500,净增 78 题。
这个结果支持执行与修正流程能改善该模型的成绩,不能支持它领先于其他模型。
版本也不能省略。公开表里的另一项 81.00% 标注日期为 10 月 19 日,早于此次修订九天,作者未能确认它使用哪个版本。修订涉及问题、上下文说明、参考 SQL,还替换了部分问题,不能直接拿两个百分比判断进步。
截至作者最后检查的 2026 年 10 月 31 日韩国时间 08:00,该成绩还未进入 BIRD 官方榜单,登记申请仍在处理中。
EX 判断的是结果相同,不是 SQL 逻辑正确
执行准确率(Execution Accuracy,EX)的做法很直接:在同一个数据库上执行候选 SQL 和参考 SQL,再比较结果。
作者提供了一个用 sqlite3 编写、实际运行过的简化评估器:
import sqlite3, time

def rows(con, sql, limit=None):
    if limit:
        end = time.time() + limit
        con.set_progress_handler(lambda: time.time() > end, 10000)
    try:
        return set(con.execute(sql).fetchall())
    finally:
        con.set_progress_handler(None, 0)

def judge(con, pred, gold, limit=1):
    if not pred:
        return "sin_sql"
    try:
        return "ok" if rows(con, pred, limit) == rows(con, gold) else "mal"
    except sqlite3.OperationalError as e:
        return "tiempo" if "interrupted" in str(e) else "error_exec"
重点看 set(con.execute(sql).fetchall()):结果被转成集合,行顺序和重复行都不计入比较。set_progress_handler 则每隔 10000 个 SQLite 虚拟机指令检查时间,从查询内部中断执行。示例的默认时限是 1 秒,后面完整评测使用的查询时限是 60 秒,别混为一谈。
返回值也保留了失败类别:sin_sql 是没有 SQL,mal 是结果不匹配,tiempo 是超时,error_exec 是执行错误。只记录一个准确率,会丢掉这些诊断信息。官方评估器还会以只读方式打开数据库,示例没有展示这一步。
下面这组数据说明,为什么结果吻合仍然可能掩盖逻辑错误:
con = sqlite3.connect(":memory:")
con.executescript("""
CREATE TABLE pedidos(id INTEGER, cliente TEXT, total REAL);
INSERT INTO pedidos VALUES (1,'ana',30),(2,'ana',50),(3,'luis',20),(4,'luis',20),(5,'eva',90);
""")
gold = "SELECT cliente FROM pedidos WHERE total >= 30 ORDER BY cliente"
要留意 ana 同时有金额为 30 和 50 的订单。问题要求找出有至少一笔订单金额达到 30 的客户;如果模型把 >= 30 错写成 > 30,虽然排除了金额恰好为 30 的订单,ana 仍会通过另一笔 50 的订单进入结果,最终客户集合不变。
作者用九个候选查询运行了这个实验。它揭示的局限很具体:EX 能证明 SQL 在当前数据上返回相同结果,无法证明它在其他数据上仍然正确。用于业务验收时,金额边界、重复记录等情况还需要专门构造数据验证。
提升的来源,藏在空响应、超时和改错里
作者使用官方 baseline_inference 固定提示词、温度 0 做基线时,先碰到了输出预算问题。
第一次将输出限制设为 12,000 tokens,留下 98 个空响应,成绩只有 58.60%。随后只重新生成这些空响应,将限制提高到 32,000 tokens,恢复了 75 个回答,最终达到 68.20%。
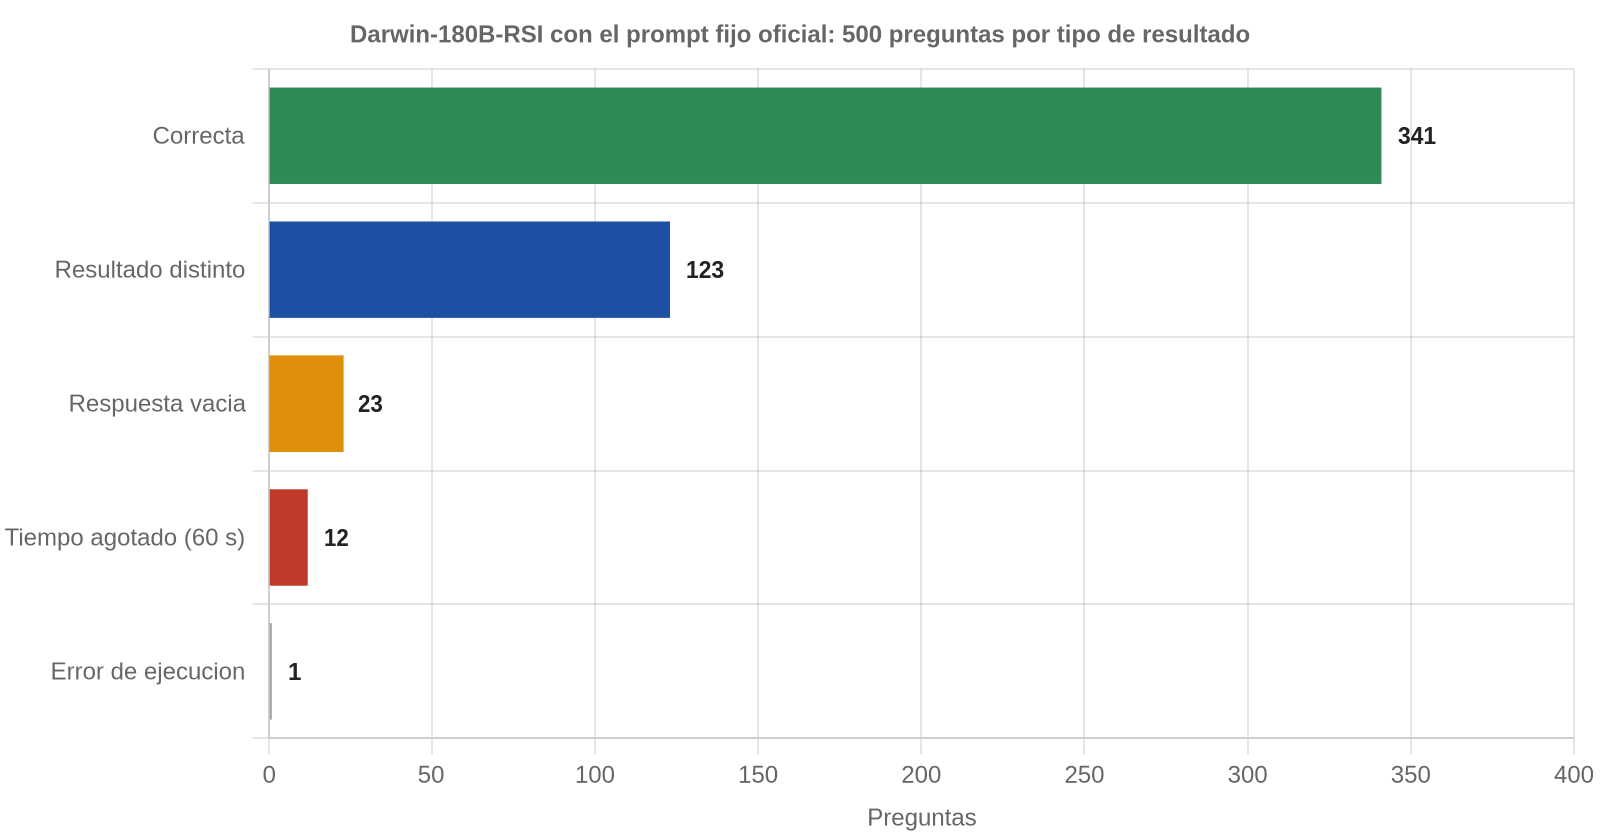
这说明推理模型的输出预算也是实验条件。限制过短,最终 SQL 可能还没产出就被截断。不过,68.20% 是经过空响应补跑后的结果,理解调用成本时也应该把这一步算进去。
接着逐题比较基线与系统结果:89 题从错变对,11 题从对变错,净增 78 题。
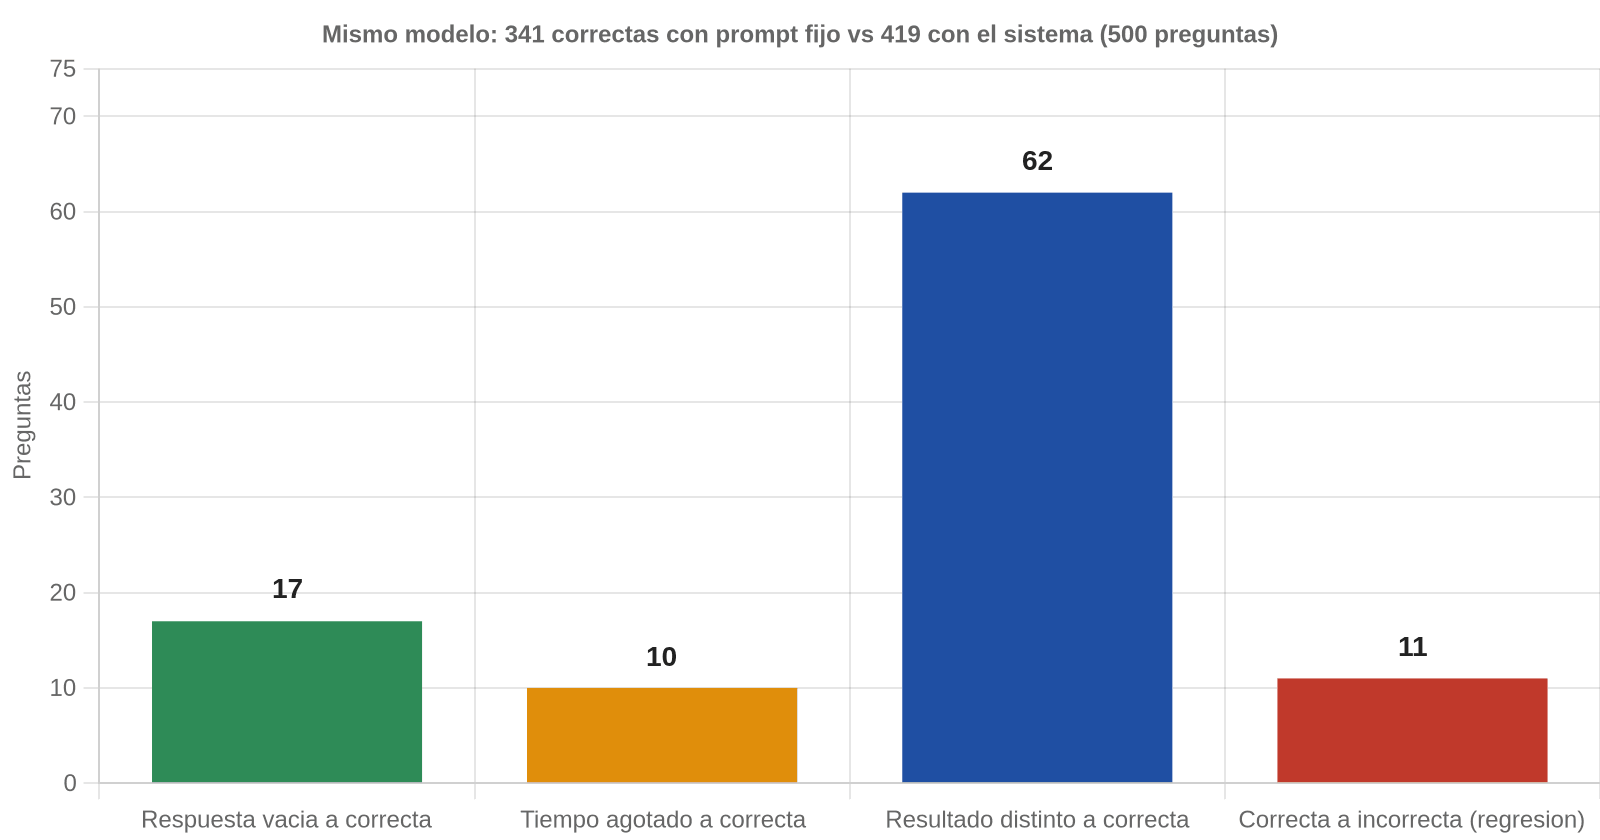
89 道改善的题里,62 道原本结果错误,17 道没有回答,10 道执行超时。后两项合计 27 道,占 89 道改善题的约 30%。这个比例的分母是所有从错变对的题,不能直接说成净增 78 题的 30%。
所以,提升并不全是「更懂问题了」。其中一部分是流程恢复;另外 62 题则从结果错误变成了 EX 判定正确,仍需接受前面提到的指标边界。
机器负载又带来了另一层变化。模型说明记录的是空闲机器上两次得到 419/500;作者拿公开预测文件和 score_ex.py,在内部 PC 上开 8 个并行进程,两次都得到 418/500,即 83.60%,并出现三个超时。
差异落在 Q93:单独执行时,29 秒得到正确结果;与其他进程竞争资源时,超过了 60 秒时限。500 道题里每题占 0.2 个百分点,单题超时就足以改变末位成绩。
复现入口是 birdsql/bird_mini_dev 的 data/mini_dev_sqlite.jsonl,数据库来自 BIRD 的 minidev.zip。数据集说明提供了 sha256,用于核对版本。将数据文件放到 score_ex.py 旁边后,命令是 python score_ex.py predictions.jsonl ruta/a/MINIDEV/dev_databases。
我的判断
我认可作者把收益拆到逐题变化,也公开了预测文件和评估器。与只展示总分相比,这些材料更方便检查结论,11 道退步题尤其值得保留。
但公开材料能复核的是预测结果的得分,不能完整复现生成这些结果的系统。验证引擎没有公开,修正策略、调用次数、耗时和成本也没说清。它与单次调用相比是否划算,目前缺少对照数据。
同样,Q93 足以说明这次评测受到并行负载影响,却不足以证明所有系统之间 0.2 个百分点的差距都属于噪声。那需要重复测量支持,原文的推广判断仍带有经验成分。
执行成功和结果匹配,适合作为修正反馈,不能单独承担业务正确性的验收。
相比反复改写提示词,执行反馈提供了可观察的信号;相比直接换更强模型,它是否更省成本、延迟是否可接受,这篇文章没有给出答案。
能拿来做什么
- 做自然语言查库功能时,把没有 SQL、执行错误、超时和结果不匹配分别统计,再决定优先修改提示词、输出预算还是查询流程。
- 用 Node 编排推理模型生成 SQL 时,记录输出限制、截断状态与补跑次数,避免把没有完整输出误判为模型不会做。
- 给自动修正流程保留逐题回归记录,同时统计从错变对和从对变错的数量,并单独检查被改坏的查询。
- 验收生成的 SQL 时,补充金额恰好等于阈值、重复记录等测试数据;复现基准成绩时,同时记录数据版本、查询时限和并行进程数。