翼型生成实验:查表胜过扩散模型
作者尝试用扩散模型生成翼型,最终发现查找表表现更好,并公开代码、数据与实验结果。实验将问题限定为二维翼型,用NeuralFoil代理求解器验证升阻力目标,明确未实现完整流体仿真。
AI 深度解读
想用扩散模型替代耗时数天的 CFD,最后发现查表更强,关掉扩散模型还能提高命中率。作者这次零成本实验的价值,在于把失败继续做下去:保留检索,用优化修正候选,再逐个验证。
对程序员来说,这篇值得读的不是翼型知识,而是一套判断 AI 方案是否值得保留的方法:先跑简单基线,检查评估前提,再把复杂模块拆掉试试。
先缩小任务,才能判断模型有没有用
作者最初想让扩散模型受 Navier-Stokes 方程约束,根据风洞或飞行遥测实时生成气动外形。约束是预算 $0、立即开工,并让设计决策有 18 篇论文支撑。
真正落地时,任务收缩成小型配送无人机的二维翼型,用 11 个 CST/Bernstein 参数描述。计算工具选了 NeuralFoil,它是 XFOIL 的神经网络替代模型,并不是 Navier-Stokes 求解器。
实验范围是雷诺数 2×10⁵ 到 3.5×10⁵、攻角 0–10°。输入飞行条件和目标升阻力,输出翼型;NeuralFoil 确认升力误差在 1% 内、阻力误差在 5% 内,才算命中。这组容差来自 Geng 等人的研究。
实现全用 NumPy,不用 PyTorch,跑在免费的 2-CPU 云沙箱里。数据来自 12,000 个随机翼型、每个 44 种飞行条件,作者称约 350k 条标注。不过,这两个数量直接相乘并不等于 350k,原文没有解释差额。数据按翼型划分,测试外形没有出现在训练集中。
第一轮,条件 DDPM 使用 Airbus 论文中的架构,对手则是从训练集找最接近目标的翼型。增加数据对两者都有帮助,但扩散模型始终没追上查表。
生成模型是否有价值,要看它能否超过已有数据的直接复用。
为什么「先查再改」赢了,从头生成却没赢
作者随后改成 retrieve → refine → verify:
先检索训练翼型,再通过一个小型 MLP 代理模型计算优化方向,用梯度下降调整参数,最后交给 NeuralFoil 验证。也可以先用轻量扩散做一次初始调整,但每次 NeuralFoil 检查都计入预算。
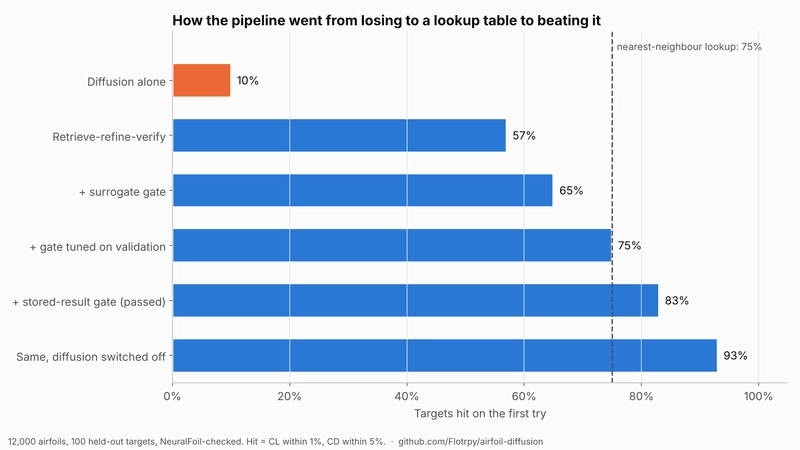
第一版在允许尝试 10 次、100 次时胜出,首次尝试却只有 57%,低于查表的 75%。原因很具体:它把已经合格的翼型又改坏了。
于是作者加了一道门,代理模型判断已经达标,就跳过优化。然而,代理误差与 1% 的升力容差差不多大,分不清哪些候选真的合格,最终只追平基线。
有效的修复来自已有数据。测试目标与训练数据使用同一套雷诺数、攻角网格,每个训练翼型在对应条件下的 NeuralFoil 结果早已存好。直接读记录,就能准确判断候选是否达标,还能校正代理偏差,无须新增求解器调用。这里的「准确」,仅指与已有 NeuralFoil 结果一致。
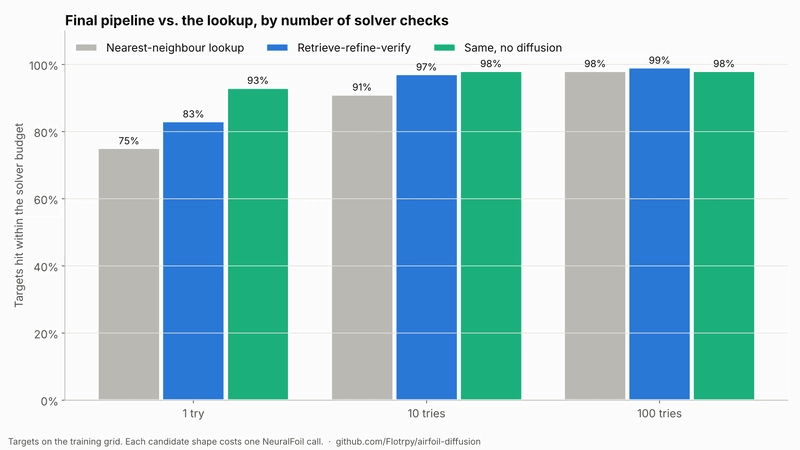
在 1、10、100 次尝试预算下,流水线达到 83% / 97% / 99%,查表为 75% / 91% / 98%。
但更关键的消融实验是:关掉扩散模型,首次命中率反而达到 93%。验证集上的扩散强度扫描也表明,不加扩散优于所有测试过的扩散设置。
离开规则网格,才看得到方法的实际价值
真实遥测不会恰好落在训练网格上。测试条件移到网格点之间后,查表首次命中率降到 1%,10 次内只有 16%;检索、优化、验证流水线则约为 50% 和 98%。
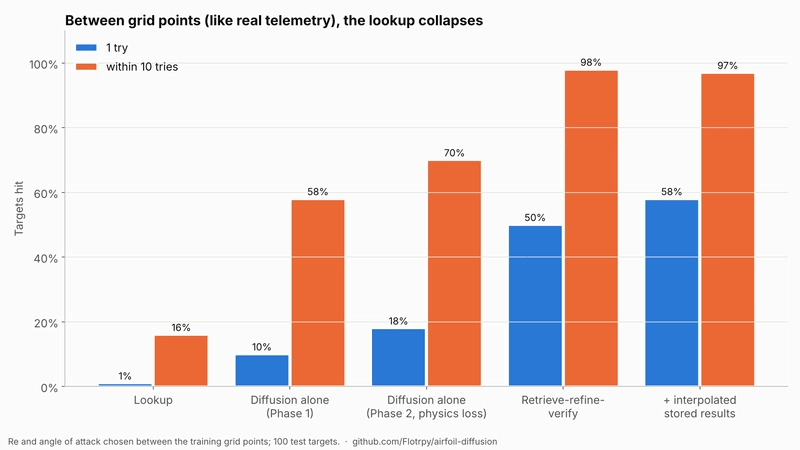
这时无法直接读取同条件下的存储结果。Iteration 7 改用周围 4 个网格点,为每个检索翼型插值估计升阻力。作者报告,这种估计比代理模型约准确 3.5 倍,首次命中率提高到 58%。
作者也继续尝试让扩散模型理解物理约束。Iteration 6 使用 PIDM 风格损失,要求去噪后翼型的代理升阻力匹配目标,再用 ConFIG 合并梯度,平衡它与常规去噪损失。反向传播由 NumPy 手写,并用有限差分检查。
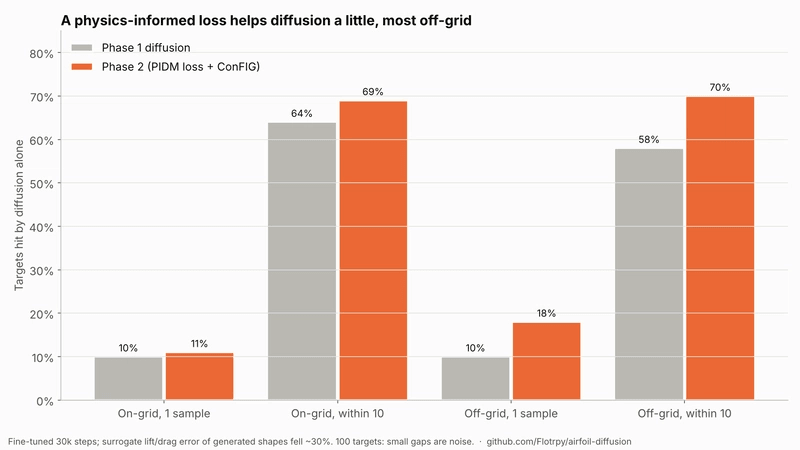
生成翼型的物理误差下降约 30%。离网格测试中,扩散模型单次采样命中率从 10% 升到 18%,10 次内从 58% 升到 70%,仍落后于直接使用代理模型优化。
下面是原文提供的复现命令,用于生成数据、训练并评估:
git clone https://github.com/Flotrpy/airfoil-diffusion
cd airfoil-diffusion
pip install -r requirements.txt
python scripts/01_make_dataset.py --n-airfoils 12000
python scripts/03_train_diffusion.py --steps 200000 --width 128
python scripts/07_refine_eval.py
要注意数据生成和训练两行中的 --n-airfoils 12000、--steps 200000 --width 128;它们给出了规模,但原文没有提供完整运行耗时。
我的判断
我认同作者保留简单基线、报告不利消融结果的做法。这个实验说明,已有候选加局部优化可以很强,也说明复杂模块需要单独证明贡献。
但它没有证明扩散模型普遍不适合逆向设计。结论受二维参数化、数据密度、代理精度和测试条件限制。网格内读取结果尤其依赖预先覆盖的条件,离开网格后就得换成估计。
还有两条边界:NeuralFoil 同时负责标注与裁判,尚缺 XFOIL 或 RANS/Navier-Stokes 求解器的独立复核;每个测试集只有 100 个目标,几个百分点的差距不足以支撑强结论。实验也没有覆盖三维机翼、结构和制造约束。
作者总结的工程方法有实测支撑;把它进一步推广成「查表总比生成好」,就超出了证据。
能拿来做什么
- 做 AI 编程工具时,先测检索已有实现或模板的效果,再评估生成模块带来的额外收益。
- 对已经通过验证的候选设置停止条件;如果判断依赖代理模型,先确认它的误差小于验收容差。
- 把测试条件从熟悉的数据点移到中间区域,并逐个关闭复杂模块,检查收益到底来自哪里。
- 复现这类优化项目时,同时保留调用预算、命中率和独立验证结果,避免只比较最好看的一组数字。