模型路由实验:模拟成本增八倍,准确率持平
作者在 30 道可程序评分的任务上比较两个本地模型,路由方案与始终使用小模型均答对 13 题。按真实 token 用量套用示例 API 价格,路由成本为后者的 8.2 倍;本地执行本身没有 API 费用。
完整中文译文
我实现了一种几乎所有人都会先尝试的 LLM 模型路由策略:先让便宜模型回答,再让它报告自己有多大把握;只要置信度低于阈值,就把问题交给更强的模型。实验包含 30 个任务、3 种策略,使用真实的本地模型,并根据实际 token 数量,按公开发布的真实价格计算费用。路由器把 30 个任务中的 14 个升级给了强模型,最终准确率却与完全不做路由一模一样:都是 43.3%,但花费达到了后者的 8.2 倍。
我看到这个数字时,第一反应是:“路由在这里毫无作用。”这个判断是错的。我之所以知道它错了,完全是因为我没有停留在表面结果,而是回头逐一检查了每个任务。实验中确实发生了两种方向相反的影响。它们几乎恰好抵消了,但这只是本次运行的巧合,并不是路由器遵循的什么规律。
先列出实验依据。在讨论任何发现之前,实验设置如下:
30 个任务,简单、中等、困难各 10 个。每个任务都通过程序规则评分,与已知答案进行精确匹配或子串匹配,不涉及主观评分。
模型:通过本地 Ollama 0.34.2 运行 llama3.2:1b(便宜档)和 llama3.1:8b(强模型档)。
每次调用:temperature 为 0,固定 seed,不重试。
示例费用:使用每次调用的实际 token 数量计算。便宜档采用 DeepSeek V4.1 Flash 公布的高峰时段、输入未命中缓存的 API 价格,输入/输出每百万 token 分别为 $0.30 / $1.20;非高峰时段降至 $0.15/$0.60。强模型档采用 GPT-5.6 Sol 公布的短上下文价格,输入/输出每百万 token 分别为 $4.00 / $20.00。本地执行本身的费用为 $0。
完整原始数据、代码及第二轮验证结果:github.com/priyansh18/confidence-router-benchmark。
先说结论。没有轻信表面结果,而是实际核对数字后,我发现:
路由策略与始终使用便宜模型的准确率完全相同,都是 43.3%,即 13/30,但费用是后者的 8.2 倍。始终使用强模型的准确率达到 66.7%,不过路由策略的费用仍只有它的约 1/3.2。
路由器的 14 次升级中,只有 3 次真正把错误答案变成了正确答案。8 次纯属浪费,因为便宜模型原本就答对了;另有 3 次升级所处理的任务,两个模型都无法解决。
16 个未升级任务中,有 14 个是路由器放行的错误答案,而模型报告的置信度都不低于 70。在这里,自报置信度与实际正确性几乎没有相关性。
还有一个我事先没有考虑到的混杂因素:在同一次调用中,让便宜模型一边完成任务、一边报告置信度,改变了这 16 个任务中 5 个任务的实际答案,其中 4 个从答对变成了答错。仅这一点,就净损失了 3 个正确答案,与是否升级的决策无关。
有效升级带来的净收益是 3 个正确答案,置信度指令的副作用则净损失了 3 个。两者叠加,最终数字又回到了便宜模型自身的基线。换一组任务,结果就会不同。
这个实验真正检验的问题是:模型自报的置信度,能否有效预测答案是否正确,足以用作路由信号?这是一个可以证伪的判断,而不是凭感觉。下面的分析还几乎意外地揭示了另一个更直接的问题:要求模型给出置信度分数,会不会改变答案本身?
LLM 模型路由:大家最先尝试的版本
LLM 模型路由,就是把每个请求交给能够处理它的最便宜模型,只有任务确实需要时,才花钱调用更强的模型。已有发表成果证明有效的方案是 RouteLLM(Ong 等,2024 年,UC Berkeley/LMSYS):使用真实偏好数据训练路由器,这些数据来自人类与 LLM 评审对不同模型回答质量的比较。它在 MT Bench 上将成本降低了 85% 以上,同时保留了 GPT-4 的 95% 质量表现;最佳情况下,只需把 14% 的流量交给强模型。这一结果来自他们表现最好的增强数据路由器,对比模型为 GPT-4 Turbo 和 Mixtral 8x7B。
但这需要标注数据集,还需要训练。大多数在某个普通工作日着手搭建 Agent 的人,手头并没有这些条件。真正能快速尝试的,就是本文这种版本:跳过训练,直接问便宜模型有多大把握,它说没把握时就升级。
这 30 个任务覆盖了生产环境 Agent 运行框架经常需要路由的几类任务:事实查询和单位换算属于简单任务;日志字段提取和多步费用计算属于中等任务;包含干扰信息的多约束推理属于困难任务。每个任务都有一个程序化的 check() 函数,与已知答案进行精确匹配或子串匹配,因此评分完全不依赖我的主观判断。
本次测试的路由规则如下:
ESCALATE_BELOW = 70

def route(task, cheap_model, strong_model):
    routed_prompt = task.prompt + (
        "\n\nAfter your answer, on a new line write exactly: "
        "CONFIDENCE: <a number 0-100 for how sure you are>."
    )
    answer = call(cheap_model, routed_prompt)
    confidence = parse_confidence(answer)

    if confidence is None or confidence < ESCALATE_BELOW:
        return call(strong_model, task.prompt)  # escalate, plain prompt
    return strip_confidence_line(answer)
升级任务的费用,是便宜模型调用费用与强模型调用费用之和。未升级任务的费用,则只有便宜模型调用的费用。我对全部 30 个任务分别运行了三种策略:始终使用便宜模型,使用普通 prompt,不附加置信度指令;始终使用强模型,使用普通 prompt;以及使用路由策略。
先看结果,再解释原因
图片由作者制作。定价:便宜档采用 DeepSeek V4.1 Flash 的价格,输入/输出每百万 token 为 $0.30/$1.20;强模型档采用 GPT-5.6 Sol 的价格,输入/输出每百万 token 为 $4/$20。费用根据本地运行的实际 token 数量计算。
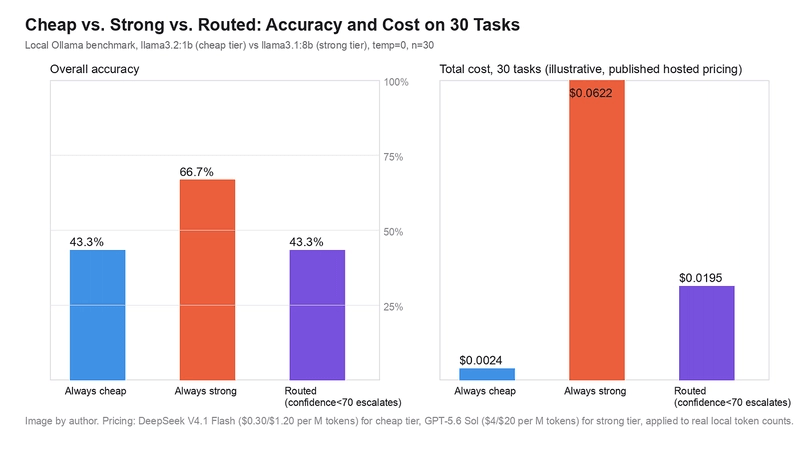
路由器将 30 个任务中的 14 个进行了升级,占 46.7%。这 14 次升级实际换来了什么?
8 次是浪费。便宜模型使用普通 prompt 时,本来就能答对。升级除了增加账单,没有改变任何结果。
3 次有帮助。便宜模型答错了,强模型纠正了答案。这正是路由器应该发挥的作用,而它实际做到了 3 次。
3 次仍然答错。两个模型都没答对。这些任务确实很难,并非路由失败。
因此,单看升级本身,它带来了一点净收益:多了 3 个正确答案,而且没有把任何原本正确的答案变成错误答案。经确认,归入浪费类别的全部 8 个任务,强模型也都答对了。如果事情到此为止,路由策略的准确率应该是 16/30,而不是 13/30。但实际并非如此。还发生了别的事。
另外 3 个正确答案去哪了
那 16 个没有升级的任务,并不是简单地“保留便宜模型使用普通 prompt 时的答案”。每个任务都使用了另一次调用:任务 prompt 加上额外的置信度指令。实验开始前,我以为第二次调用会给出与普通调用相同的任务答案:毕竟是同一个模型、相同的 temperature、相同的 seed,只不过多了一行让它顺便给自己打分的指令。但在这 16 个任务中,有 5 个证明这个假设是错的。
图片由作者制作,直接根据 raw_results.jsonl 计算得出。
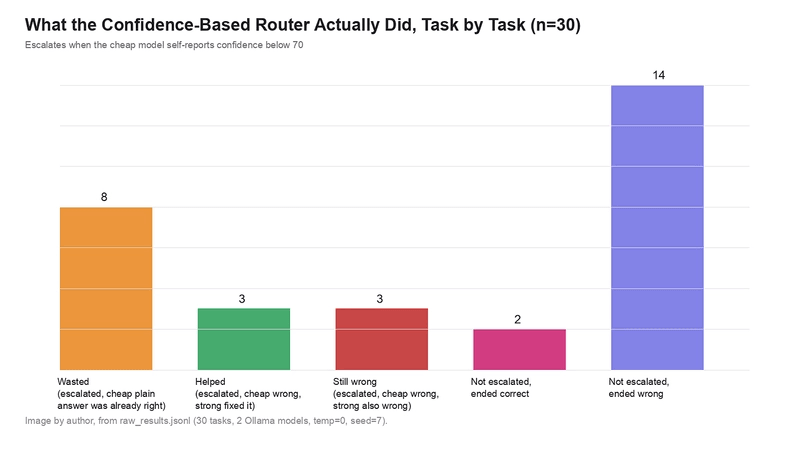
便宜模型使用普通 prompt 时答对的 4 个任务,在同一个 prompt 中附加置信度指令后,反而答错了。另有 1 个任务发生了相反变化:不加指令时答错,加上后答对。净结果是:仅仅因为多了一行要求模型评价自身把握程度的指令,未升级任务就少了 3 个正确答案。对于这完全相同的 16 个任务,使用普通 prompt 时的准确率本应是 31.3%,即 5/16;实际使用路由 prompt 后,准确率却只有 12.5%,即 2/16。
这 4 个由对变错的任务中,有一个是整组任务里最简单的:“47 + 58 等于多少?”直接问时,便宜模型回答 105,正确。同一个问题,只多附加一句话,要求它在回答后报告置信度分数,它就回答了 95,错误,而且报告了 80% 的置信度。数学题没有任何变化。两次调用唯一的区别,就是末尾多了一条指令,而模型本来要等答完题之后才需要执行它。对于一个拥有 12 亿参数的模型来说,这显然已经足以干扰算术计算本身,而不只是影响答案周围附带的元数据。
第二个代价更大的案例是任务 h5,它在更难的数学题上展示了同一种失败模式:“一个分类器在 80% 的流量上准确率为 95%,在其余 20% 的流量上准确率为 60%,总体准确率是多少?”正确答案是 88%。使用路由 prompt 时,便宜模型写出了正确公式:(0.8 x 95%) + (0.2 x 60%),随后却算错了,把 88% 写成了 76.8%,并对这个错误数字报告了 100% 的置信度。这个案例不属于答案翻转,因为便宜模型使用普通 prompt 时也答错了。但它是整组任务里最鲜明的例子,说明“自信地答错”究竟是什么样:方法正确、计算失误,却对输出结果深信不疑。
这次实验的设计并没有专门隔离这一影响,因此我还不能断言,它在不同模型规模或不同指令措辞下有多普遍。我能确定的是:它确实发生了,而且发生在一个干净、确定、可复现的实验设置中。它造成的影响,恰好与升级带来的收益方向相反,这也是表面数字看起来毫无变化的唯一原因。路由器的一项实现细节——是在任务调用中直接要求置信度分数,还是另开一次调用询问——在路由决策尚未发挥作用之前,就已经对被路由的内容造成了可测量的改变。如果你正在构建类似系统,就应该单独验证这一点,不能想当然。
如果你现在正在构建路由器,这意味着什么
不能默认把模型自报的置信度当作可用的路由信号。在这里,它同时以三种不同方式失效:花钱重问已经答对的问题;悄悄保留模型深信不疑的错误答案,16 个未升级任务中有 14 个属于这种情况;以及用于获取置信度的指令本身,产生了降低准确率的副作用。对于这样构建的路由器,其中任何一个问题都值得在上线前解决。三个问题同时出现,有力地说明了这个“一行指令版”方案的问题,但这不是放弃路由的理由。
要测试完整实现,不能只测升级逻辑。我原本预料会薄弱的部分,也就是置信度阈值的选择,确实很薄弱,但它并不是唯一问题。我没想到会产生影响的部分,也就是置信度指令的传递方式,损失的准确率恰好与升级逻辑挽回的一样多。如果我只看总体数字,就会得出“路由没有效果”的结论,错过隐藏在下面的两个真实发现。
如果路由费用对你的工作负载确实重要,就应该朝 RouteLLM 的方向构建,而不是照搬这里的方案。使用模型输出之间的真实偏好比较来训练路由器,是已经得到验证的路径。如果暂时做不到,本次实验自身的对比也提供了一个有用结论:在这组任务上,始终使用便宜模型严格优于朴素路由器,准确率完全相同,费用却只有约八分之一,具体来说低至其 1/8.2。一个什么都不做的路由器,也能胜过一个糟糕的路由器。
这里的所有内容,包括 30 个任务、完整 prompt、每一条模型原始响应、token 数量与费用计算、三个带注释的失败案例,以及图表生成器,都已公开,且可以复现:github.com/priyansh18/confidence-router-benchmark。实验从设计上就保证了确定性。我在项目中途检查时,一次干净的重新运行精确复现了所有准确率数字。也正是这一点,最初让我觉得本文中的差异值得追查,而不该被当成噪声一笔带过。
如果你正在构建 Agent 基础设施,希望在上线前找人一起审视费用或可靠性问题,我通过 Topmate 提供少量咨询通话名额。
本文部分起草工作使用了 AI 写作工具辅助;实验、数据、代码仓库和分析均由我本人完成。
最后问一个具体的问题:如果你已经在生产环境部署了基于置信度或启发式规则的路由器,你有没有检查过,用来决定“是否升级”的信号,是否真的与你自己的流量上的答案正确性相关?还是说,它只是在设计时看起来合理,就像我的方案在实际运行之前一样?
如需进一步采取措施,你可以考虑屏蔽此人和/或举报滥用行为。