leantext为编程代理过滤文档噪声
leantext将网页、PDF、截图和Office文件转为精简Markdown,并报告内容保留与Token节省情况;作者展示的NumPy页面案例从92348个Token降至755个。它提供Claude Code钩子与命令行入口,可在代理读取资料前自动转换内容。
AI 深度解读
一次关于 Python 包的简单提问,编码 Agent 读取 PyPI 页面就花了 92,348 tokens。真正需要的项目说明只有约 2,000 tokens,其余大量内容来自导航、侧栏,以及浏览器里默认隐藏的下载文件列表。
作者为此做了 leantext:在 Agent 读取资料前,先把页面和文件变成更精简的 Markdown。NumPy 页面最终压到 755 tokens,项目说明的文字全部保留。不过,这篇更有价值的部分是:哪些内容可以删,删错了如何回退,以及为什么压缩截图反而可能更贵。
为什么网页已经转成 Markdown,还是这么费 token
网页转 Markdown,不等于提取出了正文。
NumPy 的 PyPI 页面包含一个隐藏的「Download files」标签页,列出各个版本的文件和安全哈希。用户在浏览器里阅读项目介绍时不会看到它,抓取工具却可能把它一并交给 Agent。格式变干净了,无关内容仍然在。
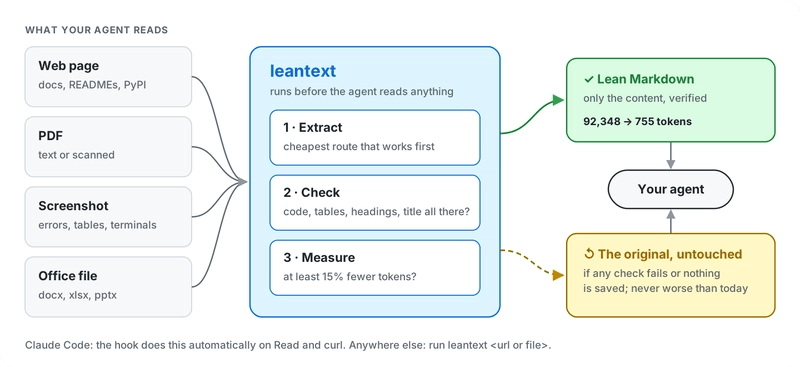
leantext 增加的是内容筛选:从网页、PDF、截图和 Office 文件中提取信息,删除噪声,再检查和计量结果。
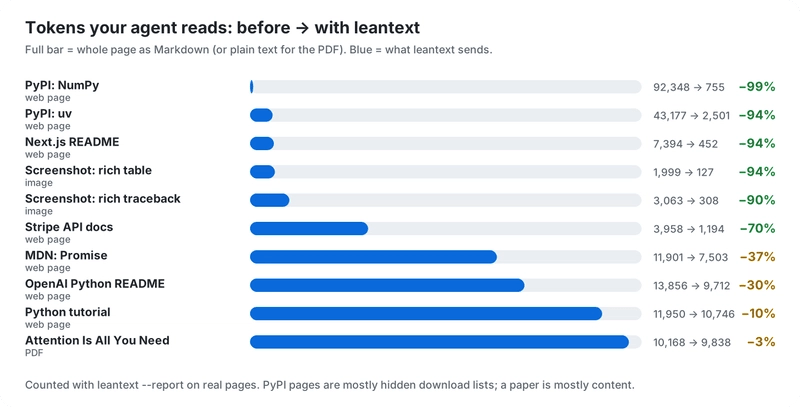
作者特意交代,实验的「压缩前」基线是整页转换后的 Markdown,大致对应 Agent 内置抓取工具的输出,并非原始 HTML。例如 uv 页面原始 HTML 有 158,141 tokens,用这个数字做分母会显得更漂亮,但参考价值有限。
不同资料的收益差别很大。PyPI 页面混入大量隐藏下载列表,可以节省 94% 到 99%;研究论文几乎都是正文,只节省约 3%。后者并不代表工具失效,而是可删的噪声很少。
自动压缩之前,先决定什么时候退回原文
leantext 的关键规则叫 fail open:转换结果没有通过检查,就把未经修改的原文交给 Agent。
检查项包括代码块、表格、标题是否保留,页面自身的标题是否位于顶部,有没有乱码、近乎空白或「请启用 JavaScript」之类的占位内容,以及 token 是否至少减少 15%。
这个设计解决了一个实际问题:压缩工具删掉一张参数表,造成的损失可能远高于省下的 token。达不到节省门槛时直接回退,也能避免低收益转换进入后续流程。
但作者所说的「最坏只是没省钱,绝不会答错」,不能当成严格保证。结构检查通过,只能说明没有发现问题,不能证明所有重要信息都在。
作者自己的测试就暴露了边界:NumPy 项目说明的 375 个单词全部保留;uv 项目说明也完整保留,包括 85 行代码示例。但 PyPI 侧栏里的发布日期、维护者和许可证被删掉了。作者已把它列入 README 的已知限制。
如果问题只是「这个包做什么」,这些字段可能无关;如果要判断许可证或维护状态,它们就是答案的一部分。正文完整与任务所需信息完整,是两种标准。
为什么截图少了九成 token,总账却更贵
作者还做了答案层面的测试:选取 7 个任务,在全新的 Claude Code 会话中分别关闭、开启 hook,每种情况重复三次,报告的结果是 21/21 个答案仍然正确。
这比只展示压缩率更有说服力,不过原文没有展开任务内容和判分标准,能支持的结论仍限于这组实验。
更有启发的是截图。截图经过 OCR(光学字符识别)转成文本,可以节省 90% 以上的图像 tokens;但一张图原本只消耗约 2k tokens。Agent 读到识别文本后,有时会多花一轮核实,而这一轮约消耗 15k tokens,最终总成本反而上升。
该衡量的是完成任务的总消耗,而不是单次输入缩短了多少。
因此,Claude Code hook 默认转换网页、扫描 PDF 和 Office 文件,截图与文本 PDF 则默认保留,需要用户主动开启转换。工具支持某种格式,不代表这种格式适合默认处理。
接入方式有两种。在 Claude Code 中,hook 会在相关 curl 或文件读取操作之前处理内容,不需要修改提示词,也不依赖 Agent 记住调用工具。其他 Agent 或流水线则可以走命令行。
下面这条命令提取 Stripe 文档,并报告转换前后的 tokens:
leantext https://docs.stripe.com/api/customers/create --report
要注意 --report:Markdown 输出到 stdout,该参数额外报告节省情况。
如果要保存 NumPy 页面的处理结果,可以直接重定向:
leantext https://pypi.org/project/numpy/ --report > numpy.md
这里的 > numpy.md 保存的是 Markdown,方便人工检查被删掉了什么。其他支持 shell 的 Agent,可以在规则文件中约定使用 leantext <url-or-file> 替代 curl;MCP server 仍在规划中。
我的判断
我认可它把转换、检查和回退放在一起的做法。相比只要求 Agent「忽略无关内容」,提前清理输入能直接减少需要读取的材料;相比全部交给 Agent 主动调用工具,hook 也更容易稳定执行。
但 21/21 的结果不足以证明所有开发任务都安全。尤其是依赖选型、许可证核查这类问题,工具眼里的侧栏噪声,恰好可能是用户要找的内容。原文也没有与其他正文提取工具做对照,无法据此判断 leantext 的提取质量更好。
工程上的取舍同样有参考价值。作者把备用 OCR 和 Office 支持拆成可选组件,Mac 安装体积从 133 MB 降到 39 MB,已有结果不变。最初一次慢速安装耗时 17 分钟;调整后,最慢连接上的全新安装为 11 分钟,对应此前约 30 分钟的估算。这些口径不能混成统一测速结论,但足以说明默认依赖也会影响工具能否被用起来。
作者还把 Stripe 参数名粘连、GitHub README 标题丢失、PyPI 隐藏面板等问题变成真实页面测试,目前共有 74 项测试。对提取工具来说,这类具体失败样本,比泛泛承诺「保留重要内容」更有用。
能拿来做什么
- 给日常编码 Agent 接入前,先挑常读的文档页、包介绍页和文件做试验,人工核对参数表、代码与许可证字段,再决定哪些输入适合自动处理。
- 在前端或 Node 项目查 API 文档时,可以先用命令行生成 Markdown;如果任务依赖维护者、发布日期等信息,要额外核对源页面。
- 评估收益时,同时记录输入 tokens、额外核实轮次和答案正确性。截图识别尤其适合单独测试,不要只看 OCR 后的文本大小。
- 需要安装时,原文命令是
git clone https://github.com/shouvik12/leantext && cd leantext && ./install.sh。安装器无需 Homebrew 包,会询问是否启用 Word/Excel/PowerPoint 支持,以及是否配置 Claude Code hook,按实际使用范围选择即可。