Kimi K3.1 Pro上线API,预告开放权重
Kimi K3.1 Pro已提供API,每百万输入、输出Token分别收费2美元和10美元;高速版宣称提速2至3倍,非缓存命中部分价格翻倍。Artificial Analysis给出55分,Moonshot承诺于2026年11月4日前发布完整权重,目前尚未开放。
AI 深度解读
Kimi K3.1 Pro 的看点,是一个承诺开放权重的模型,在第三方评测里逼近了头部闭源模型。Simon Willison 这篇发布短评把价格、榜单和一次 SVG 生成试用放到了一起:它值得加入候选名单,但目前的证据还不足以判断实际编程能力。
对程序员来说,最实用的信息有两条:可以通过 OpenAI 兼容接口接入,也可以调整推理档位。不过,「即将开放权重」仍是承诺,榜单成绩也需要和自己的任务分开看。
排名很靠前,但证据分别来自哪里
按原文,Kimi K3.1 Pro 于 2026 年 10 月 23 日上线 Kimi API。当时尚未开放权重,Moonshot 承诺在 2026 年 11 月 4 日前发布完整模型权重。
性能信息有两个来源。
Moonshot 自家的基准测试显示,它大致与 Claude Opus 5.5、GPT-6 Astra 处于同一水平,部分项目领先,另一些接近。原文没有给出具体测试项、分数和测试配置,因此只能将其视为厂商报告的结果。
第三方 Artificial Analysis 给出的分数是 55,领先同为 53 分的 Claude Fable 5.1、GPT-6 Astra 和 Gemini 4 Argon,仅落后于 58 分的 Claude Opus 5.5。
作者据此认为,这是首次有一个即将开放权重的模型,在这项评测中达到如此接近前沿模型的成绩。
榜单支持的是综合能力有竞争力,不能直接替代代码任务验收。
标准版与 Highspeed,差价买到了什么
标准版的美元价格是输入每百万 token 2.00 美元,输出每百万 token 10 美元。按原文比较,这与 GPT-6.1 Sol 相同,是 Claude Opus 5.5 的一半。
另有 Highspeed 版本,宣称速度达到标准版的 2–3 倍,价格翻倍;输入 token 的缓存命中部分维持相同价格。
这个选项提供了明确的成本取舍:等待时间敏感的任务,可以考虑支付更高费用。但原文没有说明「快 2–3 倍」具体指首 token 延迟、输出吞吐,还是整个任务完成时间,也没有提供独立测速。
对需要多轮调用的编程流程,单次响应更快能节省多少总时间,还取决于调用次数、上下文长度和返工情况,不能直接按倍数推算。
一条命令能接入,SVG 试用能说明多少
作者使用 LLM 0.32 在 8 月加入的 llm openai endpoint 命令,通过 Moonshot API 生成 SVG。下面这段命令选择 low 推理档位,并分别保存正常输出与错误输出:
llm openai endpoint \
  https://api.moonshot.ai/v1 \
  --key kimi \
  -m kimi-k3.1-pro \
  "Generate an SVG of a pelican riding a bicycle" \
  --responses \
  -o reasoning_effort low \
  > kimi-k3.1-pro-pelican-low.stdout.txt \
  2> kimi-k3.1-pro-pelican-low.stderr.txt
要留意最后两行:这个命令不会自动记录结果,所以作者用重定向保存 stdout 和 stderr,后者承载此次调用的推理轨迹。
Kimi K3.1 Pro 支持 low、medium、max 三个推理档位。作者分别生成了「骑自行车的鹈鹕」,也对 Kimi K3 重新运行了同样三个档位作为比较。原文展示的是 K3.1 Pro 的 max 结果:
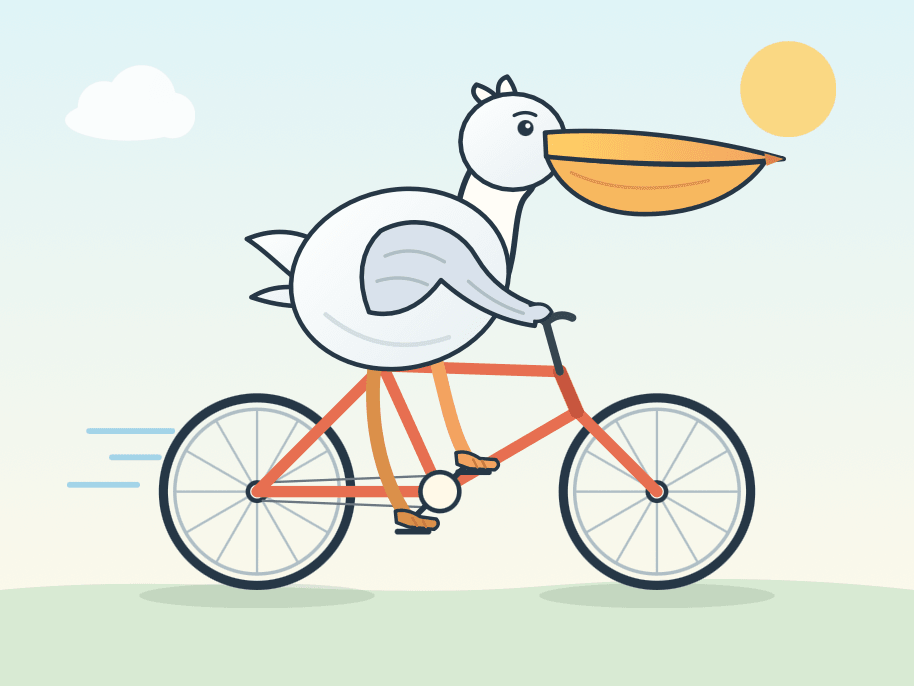
作者认为鸟喙、自行车车架和脚踩踏板的表现不错,但两条腿都画在了车架同一侧。
这个例子直观展示了模型生成 SVG 的能力,也暴露了空间关系错误。原文没有给出各档位耗时、token 消耗或系统化评分,无法据此判断 max 是否值得额外投入,更无法推断它修改项目代码的可靠性。
我的判断
我更看重第三方评分和接口可接入性:前者提供了一个独立参考,后者让现有 OpenAI 兼容调用流程更容易加入新候选模型。
但这篇短评没有代码仓库修改、工具调用或测试通过率的对照数据。鹈鹕试用属于直观观察,作者的肯定也应放在这个范围内,不能替它背书成「编程能力已经追平」。
开放权重则值得继续跟进。文章发布时,权重尚未交付,也没说明许可证、部署资源和本地运行成本。API 价格便宜与自行部署划算,是两笔不同的账。
能拿来做什么
- 已经使用 OpenAI 兼容接口的团队,可以把
kimi-k3.1-pro加入候选模型,用相同提示词和验收标准对照现有方案。 - 做 SVG 或界面图形生成时,可以比较
low、medium、max,同时检查结构关系、渲染结果和实际调用成本。 - 考虑 Highspeed 时,先测自己任务的总耗时,再判断 2 倍价格是否值得;保留输出记录,方便复查失败样例。
- 如果目标是自行部署,先跟进完整权重及许可证的实际发布情况,再评估资源需求。