Claude Code 每轮重读了哪些上下文
作者统计自己的 Claude Code 会话后发现,每次模型请求会重读约 7.4 万个固定上下文 token,缓存只能降低这部分开销。文章建议用 `/context` 和 `/usage` 定位来源,优先压缩命令输出,再清理重复技能和闲置服务。
AI 深度解读
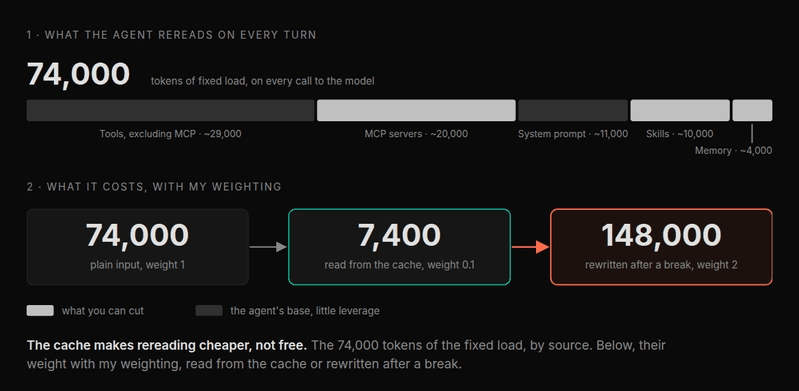
你给 Claude Code 发了一行问题,模型在动手之前,可能已经读了几万 token。作者翻查了自己从 2026 年 7 月到 10 月的会话记录,发现这套配置在每次模型调用时,光是系统指令、工具定义、技能描述和记忆等固定内容,就要带上约 74,000 token。
这个数字最有用的地方,是提醒你换个排查单位。一条提问可能触发多次模型调用,缓存命中也有成本。想知道额度花在哪,可以先用 /context 看装进了什么,再用 /usage 看实际用了多少。
一行提问为什么会带上 74,000 token
模型在两次请求之间不会自行保留上次对话。Claude Code 负责组装每次请求,把系统指令、项目上下文、聊天历史和新消息发给模型。这层负责组织上下文、执行工具并回传结果的软件,作者称为 harness。你发一条消息,模型可能先读文件,再跑测试,再根据结果改代码。每次工具结果返回后,模型都可能再被调用一次,固定内容也会跟着带上。
提示词缓存(prompt caching)能复用已经处理过的请求开头。按原文列出的公开 API 价格,以普通输入 token 的单价为 1,多数模型的缓存读取是 0.1 倍,Opus 5.5 和 Sonnet 5.5 是 0.05 倍。写入 5 分钟缓存是 1.25 倍,写入 1 小时缓存是 2 倍,输出 token 是 5 倍。原文还说,在订阅额度内,Claude Code 为主会话申请 1 小时缓存,子代理(subagent)只有 5 分钟。子代理有自己的指令和工具,首个请求会建立自己的缓存。
按作者统一采用的权重,74,000 token 命中缓存时折合 7,400 加权 token。中断超过缓存有效期,重新写入同一份固定上下文则折合 148,000。两笔都还没把对话历史算进去。一次跑测试吐出的长日志会进入历史,后续调用还会继续带着它,直到用 /clear 开新会话,或用 /compact 把历史压成摘要。
怎么区分固定开销和一条提问带来的用量
/context 是运行当下的快照,能看到各类内容占了多少上下文,以及加载了哪些记忆文件。/usage 能看会话的输入、输出、缓存读取和缓存写入,订阅用户还可以查看技能、子代理、插件和 MCP 服务器在近期用量里的占比。要查几个月的趋势,作者用 Python 汇总 ~/.claude/projects 下的 .jsonl 会话记录,用 message ID 和 request ID 去重,并把主代理和子代理分开统计。
下面的公式用来把不同类型的 token 放在同一尺度上比较。
weighted = input_tokens
         + 0.1 * cache_read_input_tokens
         + 2.0 * cache_creation_input_tokens
         + 5.0 * output_tokens
留意 2.0 * cache_creation_input_tokens 这一行。作者统一按 1 小时缓存的写入倍率折算,算到 5 分钟缓存时会偏高。缓存读取也统一乘了 0.1。这是比较口径,Claude Max 的实际额度计算可能另有规则。
作者在 10 月 25 日统计了 7 月到 10 月的记录。缓存读取占原始 token 总量的 97% 到 98%,每条提问的平均加权用量从 7 月约 12.5 万涨到 10 月约 180 万。同期,子代理的用量占比从约 5% 升至 50% 到 60%。作者把这组变化归因于委派更多、每条提问承载的工作更多。两项同时上涨,但记录没有把各自带来的增量拆开。
10 月 14 日至 20 日用了约 3.59 亿加权 token,21 日至 25 日用了约 4,200 万。按天摊开,约是 5,130 万和 840 万,前者是后者的 6.1 倍。原文没有给出同期的任务数或交付量。作者也说,从 7 月起,他没找到任何一次因触及额度而真正卡住的记录。
先减命令输出,再收拾技能和工具
作者先处理进历史的命令输出。他用 hook 把命令交给开源代理 RTK,在模型看到结果前做过滤。截至 2026 年 10 月 31 日,rtk gain 在 67,883 条命令上累计记录了约 4,310 万 token 的输出削减,约占原本输出的 27%。单看 go test ./...,过滤后的输出平均短 99.8%。原文还提到 Claude Code 文档里的做法,用 hook 只保留失败测试。两种做法都把过滤放在日志进入会话之前。
第二步是处理技能和斜杠命令。技能正文按需加载,描述却会常驻。作者当时列了约 150 个技能,10 月 25 日归档了 34 条重复或闲置的命令,剩下 21 条,同时把 14 个设计技能移到实际做前端的两个项目。把技能放进项目的 .claude/skills,就能把加载范围限定在该项目。下面这段配置让部署技能只由人手动触发。
---
name: deploy
description: "Deploy the application to production"
disable-model-invocation: true
---
起作用的是 disable-model-invocation: true,它会把描述从模型上下文里移出去,手动调用仍然可用。作者的桌面会话跑在 git worktree 里,未被 Git 跟踪的本地技能链接没有随新工作树带过去。他在其中一个项目提交了链接,再开新 worktree 验证。
最后才轮到 MCP 和记忆。作者的 MCP 服务器在统计期间约占每次调用 20,000 token。按他引用的文档,MCP 工具定义默认延迟加载,首次使用前进入上下文的是工具名和服务器指令,实际占用仍要用 /context 看。闲置的可以在 /mcp 禁用,GitHub 操作已有 gh 可用时,也可以省掉常驻工具清单。在作者的配置里,记忆约占 4,000 token,系统提示和内置工具约占 40,000。原文引用的文档建议把 CLAUDE.md 控制在 200 行以内。
我的判断
先量再减,比照着 74,000 token 给团队定预算更有参考价值。作者的技能数量、MCP 配置和子代理占比,都会影响这个数。更容易复用的是排查顺序。先看持续累积的历史,再看每次调用都会带的配置。只用 /compact 也能缩短历史,但如果下一轮测试继续吐出大量日志,精简测试输出仍能减少进上下文的内容。
原文的节省证据也有边界。RTK 的计数衡量的是命令输出少了多少。作者在 10 月 25 日清理后没有再做同口径测量,所以无法用这组记录给技能归档、MCP 精简或整套调整算出节省比例。日均用量相差 6.1 倍的两段统计也截止于清理当天。至于什么时候该少派子代理,原文没有同类任务的耗时、交付质量或调用量对照,这部分只能当作个人经验。
能拿来做什么
- 挑一个常做的任务,例如修复组件测试,先记录
/context和/usage,把你发了几条消息、代理调了几次模型、子代理用了多少分开看。调整后再用同类任务复测。 - 给前端或 Node 的测试命令加一层输出过滤,保留退出码、失败用例、断言差异和必要的堆栈。先拿一条已知会失败的用例检查过滤结果,确认代理还能定位问题。
- 把只服务特定仓库的技能移到
.claude/skills,清理长期闲置的 MCP 服务器。如果会话跑在 worktree 里,开一个新工作树确认技能链接能被加载。 - 把无关任务放到新会话里,用
/clear清掉旧历史。还在处理同一个问题、需要保留已有结论时,可以先用/compact压缩历史。