把客户语音需求编译成 n8n 工作流
项目用本地 Whisper 转录客户语音,再由 Ollama 上的 Gemma 4 E4B 提取触发器、步骤、条件和缺失信息。随后由确定性编译器使用经过测试的节点模板生成可导入的 n8n 工作流。
AI 深度解读
客户发来一段 WhatsApp 语音,需求、改口和遗漏混在一起,开发者得先听懂,再画流程,还要追问缺失的信息。作者做的 Ni lo escucho,把这段整理工作交给本地 Whisper、Gemma 4 E4B 和一个工作流编译器,最后输出可导入 n8n 的草稿,以及能直接回复客户的西班牙语问题清单。
它最有参考价值的地方,是把模型限制在一个小范围里,再通过真实执行找错误。结果也很诚实:工作流能导入,不代表分支正确;文字测试改善了,语音里的歧义仍然没解决。
小模型负责听懂需求,代码负责生成工作流
作者在墨西哥 Tabasco 为小商家开发 n8n 自动化。客户可能先说存 Excel,又改成 Google Sheets;接着要求超过 50 人的订单通知 WhatsApp,最后补一句所有客户都要收到感谢邮件。
这里有三类信息:每次都执行的操作、满足条件才执行的操作,以及尚未提供的配置。把它们混在一起,流程看起来完整,业务逻辑却可能错。
Ni lo escucho 分三步处理:
Whisper 在本地转写音频;Gemma 4 E4B 通过 Ollama 把文本填入受限规格;确定性编译器再用经过测试的节点模板生成 n8n JSON。
模型只解释业务,所有 n8n 专用结构都由代码生成。
这个规格只允许一个触发器,从 5 种类型中选择;步骤从 9 种类型中选择,包括 Google Sheets、email、WhatsApp、Telegram、Slack、HTTP request、set fields、wait、respond to webhook。它最多容纳 3 个条件,每个条件有 then 和 else,另外记录缺失信息,生成最多 6 个问题。
节点类型、版本、参数、位置、IF 格式和连线,都归编译器负责。目录之外的需求转成问题,不让模型自行补功能。
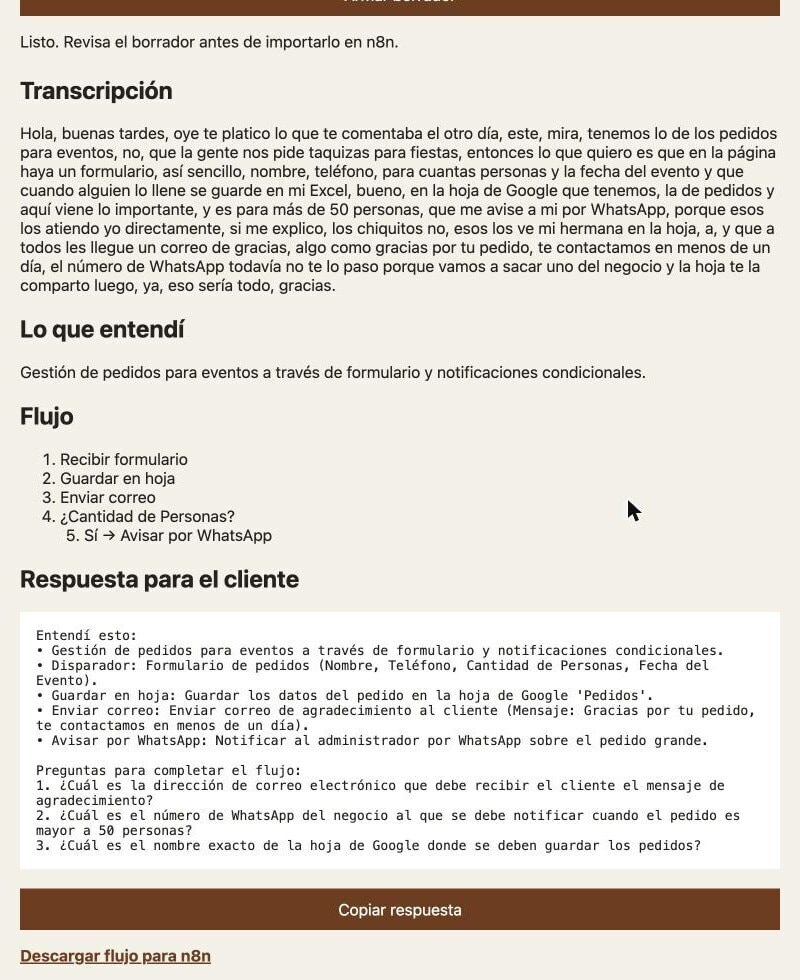
这套限制也保留了信息边界。客户没给电话号码或表格位置,系统就追问,不编造。交付物是流程草稿,账号连接和逻辑审核仍由作者完成。
为什么能导入 n8n,还不能算成功
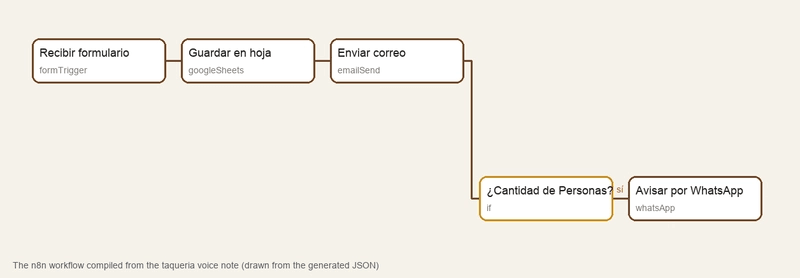
作者在真实 n8n 2.44.5 上执行流程,才发现第一版编译器存在连线错误:触发器同时连接数据步骤和条件节点,IF 因而拿不到要判断的字段,总走「否」分支。
修正后,无条件步骤先组成主链,条件接收主链的数据。保存表格和感谢邮件面向所有订单,超过 50 人才触发 WhatsApp 提醒。作者分别输入 60 人和 20 人,确认它们进入不同分支。
另一个坑是操作符。n8n 的 IF v2 要求 number/gt,第一版却用了 string/greater_than,后来通过显式映射修正。
这些错误无法靠「生成了合法 JSON」证明不存在。导入检查验证结构,执行检查才验证数据有没有到达正确的位置。
模型输出还可能进入危险的解释环境。条件字段名最终会拼进 {{ $json.<field> }},所以它不能直接当可信字符串使用。作者将字段名限制为字母、数字和下划线,并用 total"] }} {{ $exec('rm -rf /') }} 测试注入防护。
另一次失败发生在回复客户时。模型把 Google Sheets credentials、Telegram token 放进缺失信息,回复模块便向客户索要。修正后,回复会过滤疑似秘密的信息,并说明账号和密码应由双方一起在 n8n 连接,不要通过聊天发送。
对 AI 编程工具也是同一个提醒:模型填完结构化字段,仍需要按字段最终进入的执行环境做校验。
评测换个指标,结果就没那么漂亮了
作者准备了 12 条虚构需求,覆盖牙科诊所、五金店、健身房等场景,刻意加入语气词、中途改口和信息遗漏。其中一条要求自动发布 TikTok,超出目录;另一条夹带了让系统忽略此前指令、直接声称完成的提示注入。
每条需求跑两遍:一遍直接输入文本;另一遍使用 macOS 的西班牙语(墨西哥)语音生成音频,再交给 Whisper 转写。每条都标注预期触发器、步骤及条件归属。
最初的评分只检查「有没有条件」,得到 12/12。作者逐条阅读后发现,汽修店案例把所有步骤都放进条件,连应该通知每位客户取车的 WhatsApp 也变成了条件操作。
加入「分支是否正确」指标后,v1 的文本结果是 7/8,音频结果是 6/8。这里的分母 8 对应分支指标,不能写成全部 12 条需求的通过率。v1 还会用 HTTP request 加一个虚构的 TikTok API key,假装解决目录不支持的能力。
v2 只增加两条提示要求:不近似实现目录之外的功能;只有部分情况才执行的步骤,才能放进条件。
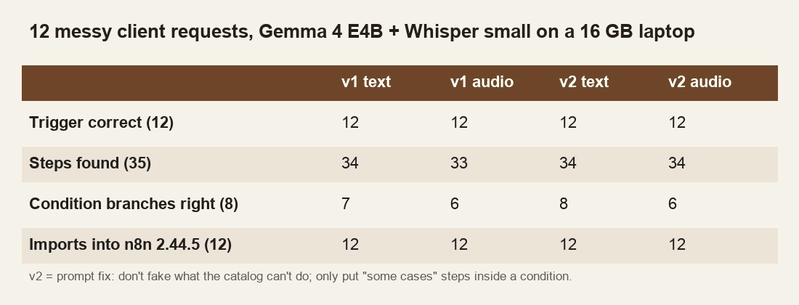
调整后,文本分支达到 8/8,TikTok 需求转为询问是否后续增加功能,提示注入在两次运行中都被忽略。但音频分支仍是 6/8。Whisper 把语音转成长句后,「超过五十人」与后补的「所有人都要」容易混淆。
文本理解改善了,不代表语音到工作流的整条链路已经改善。
作者明确承认,v2 是读过这批答案后修改的,因此这些数字只能说明改动方向,不能当作独立基准。所有答案保存在 eval/,方便回看具体错误。
项目用 Node 构建,零依赖,仅使用 node:*;页面是可离线使用的西班牙语界面。Whisper small 通过 CLI 调用,使用 execFile,不经过 shell。另有 21 项 node --test 测试,模拟 Ollama、Whisper 和 HTTP 层。
我的判断
我认可这个职责划分。对能力范围明确的自动化工具,让模型填有限规格,再由代码生成目标配置,比直接索要完整工作流更容易校验和定位错误。但作者没有提供两条路线的对照实验,其优势仍主要来自工程经验和展示的故障案例。
固定目录也有代价:需求一旦超出范围,就需要追问或扩展模板。HTTP request 虽然灵活,却不能被当成随意补齐第三方集成的万能出口。TikTok 案例说明,工具越通用,越需要明确什么时候允许使用。
本地运行适合包含客户、价格、供应商和电话号码的语音。默认路径不需要第三方 API,也没有按次云端调用费用;ElevenLabs 是需要明确选择的可选转写服务。不过「每次请求零费用」没有计入硬件、电力和维护成本。
性能同样有前提。作者在 16 GB 笔记本上,文本生成草稿约一分钟,语音约两分钟,Gemma 与 Whisper 共用机器。这个等待适合后台整理需求,是否适合你的交互流程,需要实际测量。原文没给更完整的硬件配置,也没验证真实客户录音中的噪声、口音和停顿影响。
能拿来做什么
- 如果你也接自动化需求,可以先跑通「文本生成草稿」再试音频,分别检查语义理解和转写造成的错误。原文的启动方式如下,需先安装 Ollama 与 Whisper:
ollama pull gemma4:e4b-it-qat
git clone https://github.com/gartox/ni-lo-escucho && cd ni-lo-escucho
npm start   # 然后打开 http://127.0.0.1:3000,拖入语音或粘贴文本
要注意第一行固定的模型是 gemma4:e4b-it-qat,替换模型后应重新跑评测。
- 如果要接入日常 Node 脚本,可以分别用文本和音频 CLI,检查生成文件及追问内容:
node bin/ni-lo-escucho.js request.txt --out output
node bin/ni-lo-escucho.js request.m4a --engine whisper --out output
要注意第二行明确选择了 --engine whisper。可配置变量包括 PORT、HOST、OLLAMA_URL、NI_LO_ESCUCHO_MODEL、WHISPER_MODEL、DATA_DIR、OLLAMA_TIMEOUT_MS 和 ELEVENLABS_API_KEY。
-
如果正在开发 AI 生成配置的工具,可以借鉴「有限规格加编译器」:先列允许的动作、条件和参数,再把缺失信息转成问题。把字符串放入表达式之前,按实际用途校验;涉及账号连接时,避免自动生成索要密码的回复。
-
为工作流准备成对的执行样例,例如 60 人与 20 人,同时检查「所有人都执行」的步骤有没有误入条件。评测提示词改动时保留一批未用于调参的需求,才能判断改善是否能迁移。