simem 为编程 Agent 共享记忆、压缩输出
simem 是本地运行、采用 MIT 许可证的工具,通过项目摘要和共享记忆衔接 Claude Code、Codex、Cursor 的工作会话。作者报告其可压缩测试或安装输出的 81%—99%,并保留失败信息;相关数字属于作者自测。
AI 深度解读
32 次 Claude Code 和 Codex 工作会话,累计读取约 12 亿 tokens。作者真正想解决的不是这个数字太大,而是其中大量内容早就读过:上一轮测试输出、已经打开的文件,以及上周解释过的项目约定。
作者为此做了本地工具 simem,把项目记忆和上下文瘦身放到一起。它的思路值得程序员借鉴,但「过滤掉多少文本」「减少多少重复输入」「最终省多少钱」需要分开看,不能拿一个数字替另一个背书。
为什么换个会话,项目就像重新入职
作者描述的场景很常见:周五刚确定数据库选型,弄清测试需要什么参数,约定不能从笔记本部署;周一新开会话,Agent 又开始读 README、翻 package.json、找测试入口。更麻烦的是,它可能重新提出甚至执行一个已经被否决的方案。
simem 把这些经验保存在本地,并在三个时机提供给 Agent:会话启动时注入项目摘要;用户发消息时补充明确相关的笔记;用户主动询问时搜索历史记忆。启动摘要包括近期工作、仍然有效的决策、跑通过的构建和测试命令,以及代码结构。
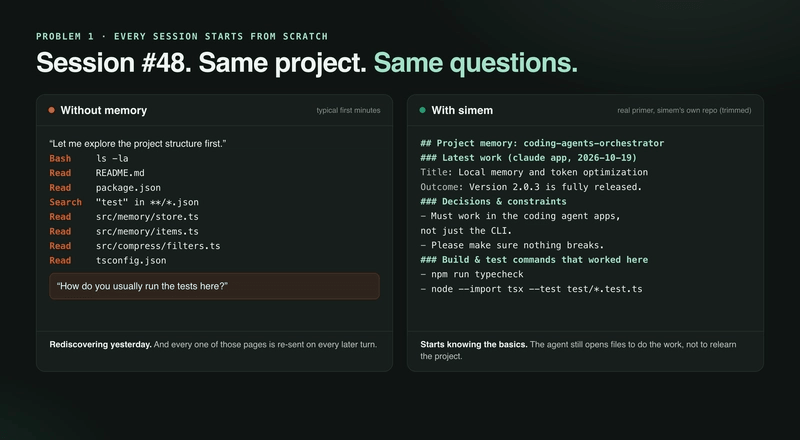
这里要区分两种阅读。修改代码前检查当前文件,是必要工作;每次都重新调查测试怎么跑,则可能是重复劳动。simem 试图减少后者。
作者称,记忆提取使用本地规则和应用已有的会话摘要,不额外调用模型;安装时也会导入项目历史会话。所谓「零 tokens 构建记忆」,指的是这个整理过程,读入摘要本身仍会占用上下文。摘要在记忆未变化时保持字节一致,是为了配合提示词缓存(prompt caching)。
记忆还要跨工具流动。simem 用仓库的首次提交标识项目,让同一台机器上的 Claude Code 不同账号、Codex、Cursor,以及不同 clone 和 worktree 共享记忆。作者给出的使用方式是:从 Claude Code 切到 Codex,输入「continue」,启动摘要就能带上另一端的近期工作。
跨机器则需要 simem memory export / import,或把存储位置指向 iCloud、Dropbox 等同步目录,并可选择加密。共享项目标识与自动同步是两件事,原文并没有把它们混为一谈。
测试输出为什么会越读越贵
作者把对话比作一摞纸:工具输出放进去后,后续轮次还可能继续携带,直到应用压缩上下文。于是,一次冗长输出的影响会延续多轮。
减少进入上下文的冗余,比等上下文塞满后再压缩更直接。
在作者最初统计的项目数据中,1,743 条命令产生约 120 万 tokens 的工具报告,文件读取约 43 万 tokens。测试里成排的通过记录、安装日志,都是过滤目标。
作者展示的 Jest 案例共有 341 个测试,其中一个失败。simem 把输出从 112 行、4,082 个字符压到 12 行、341 个字符,同时保留失败信息、预期值、实际值、堆栈位置和汇总。完整输出留在磁盘,可用 simem out <id> 找回。
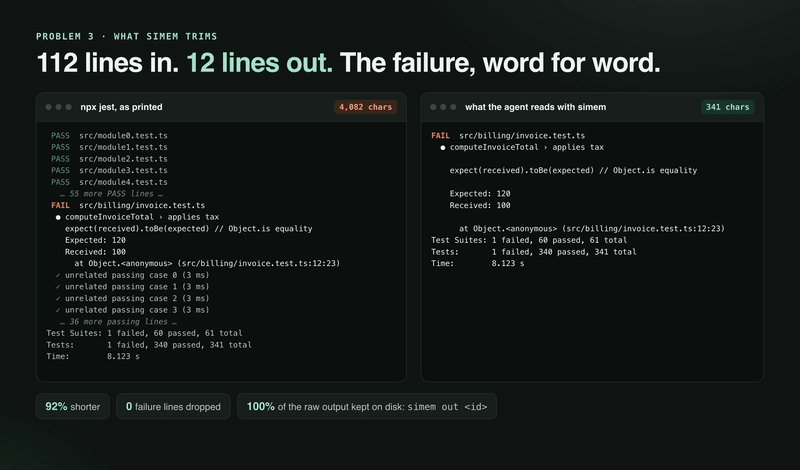
按作者的示例计算,同一份报告在后续 30 轮中反复携带,输入量会从约 34,000 tokens 降到约 2,850,少发送约 31,000 tokens。但这描述的是累计输入量,不能直接等同账单节省:缓存命中、计价方式和套餐限额都可能影响结果。
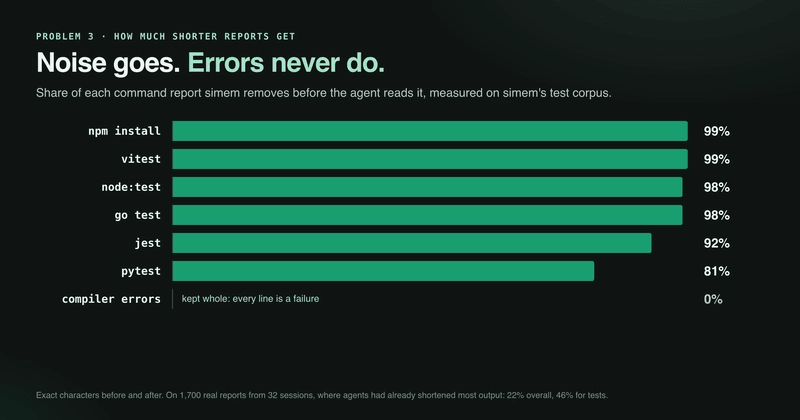
不同输出的压缩幅度也不同:npm install、Vitest 为 99%,node:test、go test 为 98%,Jest 为 92%,pytest 为 81%。编译器错误则保留完整,裁剪比例为 0%。作者宣称的规则是「不删除失败行」,这些百分比来自其展示的样例,不能当成所有项目的保证。
文件读取也有对应限制:超过 800 行的整文件读取,首次先返回结构提纲,再次请求才给全文;重复读取上下文中未修改的文件,会提醒一次。code_search 返回 path:line-range 和签名,code_read 可以只读取一个函数。
81%—99% 的宣传数字,要和真实会话分开看
作者把自己 32 次会话中的约 1,700 份真实工具报告拿来回放,整体只减少了 22%。原因是 Agent 原本就在主动截短多数输出,留给 simem 的空间有限。81%—99% 针对的是完整测试或安装报告,22% 才是这批实际报告的整体结果。
另一个项目记录显示,约 310k tokens 被实际挡在上下文之外;约 22.9M tokens 没有在后续重复发送,则属于估算。其中,仅 6 次 simem exec 就减少约 222k tokens,平均每次约 37k;一次大文件读取保护拦下约 75k tokens。
同一记录还有约 4.1M tokens 的命令输出、8,799 次调用,却只有 6 次经过 simem exec。原文没有充分解释这组记录与前面 1,743 条命令的统计范围关系,不宜直接拼起来计算整体收益。
安装方面,Claude Code 使用以下两条命令添加插件:
/plugin marketplace add thinhledev/simem
/plugin install simem@simem
要留意第二行的插件标识 simem@simem。Codex 对应的安装命令是:
codex plugin marketplace add thinhledev/simem
codex plugin add simem@simem
这里第二行使用 plugin add。随后新开会话,输入「set up simem」;按作者描述,Agent 会逐步询问、安装 CLI,并展示 simem init 将修改的内容,每台机器配置一次。
终端方式是 npm install -g @simem/cli && simem init,要求 Node.js 22.5+。不依赖 Node.js 的 Homebrew 路径依次为 brew tap thinhledev/simem、brew trust --formula thinhledev/simem/simem、brew install simem 和 simem init。
我的判断
我认可它把「记住项目约定」和「控制工具输出」一起处理。前者减少重复调查,后者减少历史包袱,对长会话、多工具切换尤其有针对性。
但这仍是作者围绕自己项目给出的经验和回放结果。原文没有提供同等任务下的完成时间、修复成功率、最终账单对照,也没有证明过滤后任务质量完全不受影响。「保留失败行」是有用原则,却不等于保留全部诊断线索,失败前的普通日志有时同样关键,必须保留找回原始输出的路径。
对只需固定测试命令和部署约束的团队,版本控制里的项目说明更容易共同审阅;对单一工具,原生记忆可能已经够用。simem 的额外价值,是跨应用汇总近期工作,并干预冗长输出。代价则是需要处理记忆过期,以及不同 worktree 工作内容混在一起的可能性。
作者称它免费、采用 MIT 许可,通过应用 hooks 和 MCP 接口工作,不做代理,不读取凭据,默认数据位于 ~/.simem,并对密钥、令牌和密码脱敏。这些是产品声明,原文未提供独立审计。simem init --remove 可恢复它修改的文件,删除 ~/.simem 则移除记忆。
能拿来做什么
- 先整理项目里反复解释的内容,把测试参数、构建命令、数据库决策和部署限制写成短小、可核对的说明,再判断是否需要自动记忆。
- 在测试输出较多的前端或 Node.js 项目里,用
node scripts/replay-filters.mjs回放自己的会话,查看真实报告还能压缩多少,不拿 99% 样例直接推算收益。 - 使用过滤输出时,保留通过
simem out <id>查看完整报告的习惯;当错误摘要解释不了问题,就回到原始日志定位。 - 如果经常在 Claude Code、Codex 和 worktree 之间切换,重点验证交接摘要是否准确,并检查旧决策是否仍适用于当前分支。