评估编程 Agent,要走完一次交付流程
文章建议用一个代表性任务串起需求、Agent 修改、人工评审与交付状态,评估工具能否覆盖完整工作流。重点包括任务边界、上下文获取、审批权限和测试结果的可见性。
AI 深度解读
AI 编程工具的选型,正在超出「哪个编辑器写代码更快」的范围。Agent 能改多个文件、运行命令、提交 PR 之后,团队还得回答:它依据什么需求行动,允许改到哪里,谁来审批,交付状态记在哪里。
原文的核心建议是:拿一项真实任务,从需求一路追到评审和交付,再判断工具是否合适。它提供的是一套工作流检查方法,没有给出编码效率的对照实验。对准备引入 Agent 的团队,这比单看演示更有参考价值。
先确定让 Agent 做到哪一步
IDE 里补全一段代码、修改多个文件、领取 GitHub issue 后提交 pull request,以及直接搭建并托管一个原型,是四种不同的工作范围。它们需要的上下文、权限和人工介入程度也不同。
因此,选型的第一步是确定任务边界。
比如,同样是「增加一个配置项」,实现代码可能只涉及几个文件,但验收条件、依赖关系、优先级和审批人可能都在仓库外。Agent 看到了代码,不代表它知道这个配置为什么要加、什么时候才能上线。
原文建议沿着一项有代表性的真实任务,检查五件事:
- 找到需求的权威来源,确认 Agent 能直接读取,还是需要开发者反复复制到提示词。
- 列清行动范围,包括建议代码、编辑文件、运行终端命令、创建分支和提交 PR。
- 找到人工控制点,确认优先级、权限、审批与评审分别由谁负责。
- 跟踪任务结束后的状态,检查需求、修改、决策和交付进度是否仍然关联。
- 检查运行条件,包括部署方式、数据处理承诺、按量收费和管理工作。
这条路径同时也是验收方法:评审者不只检查代码是否正确,还要能确认需求是否真正影响了实现、Agent 有没有越界,以及哪些事项仍待人工决定。
Agent 的行动能力,不能代替团队的审批规则。
上下文放在哪里,决定了工具怎么搭配
原文列出的产品并不处于同一层。有些负责仓库内的代码工作,有些负责需求和交付协调,不能直接用一张功能清单排出总冠军。
Cursor 适合主要工作发生在仓库里的场景。它是基于 Visual Studio Code 的独立编辑器,支持仓库导航、多文件修改和终端命令;cloud agents 可以在隔离虚拟机里使用终端、浏览器和桌面。不过,原文也指出,旧代码库可能需要较多指导或手动选择文件。
GitHub Copilot 更贴近已经围绕 GitHub issue、仓库、PR 和评审协作的团队。它的 cloud agent 可以响应 issue、创建分支、编写代码并提交 PR;Copilot Spaces 则用于汇集共享文件、项目知识和评审指导。
它支持的 IDE 包括 Visual Studio Code、Visual Studio、JetBrains products、Vim、Neovim、Eclipse、Xcode 和 Azure Data Studio。但高级代码库上下文可能受套餐限制,不能只看到功能名就假定所有成员都能使用。
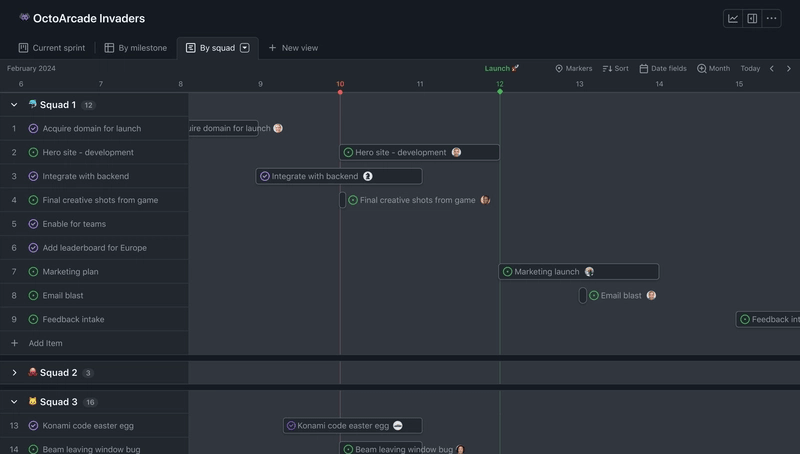
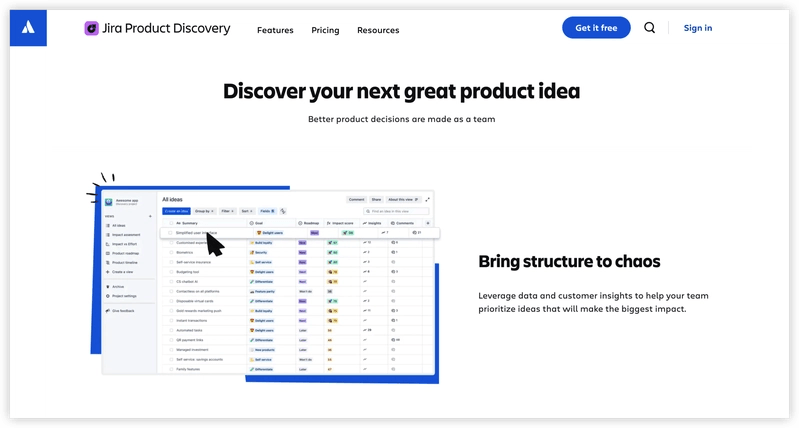
如果真正困难的是跨团队交付,单靠编辑器和仓库可能不够。原文在这里重点介绍了 ONES.com:它把需求、任务、知识、测试管理和 CI/CD 放在同一环境,支持配置字段、状态、事项类型、布局、关联类型、权限与工作流,并提供 Agile 规划、报表和自动化。
其 Workflow Agent 和 MCP 集成用于连接事项、需求、状态及流程步骤。这里的价值是让 Agent 的动作能关联项目上下文,优先级、审批和交付决策仍由人负责。它也不能替代完整 IDE。
代价是配置维护。字段越多、流程越灵活,越需要有人保证团队还能理解这些规则。
ONES.com 还报告,过去五年迁移过超过 100 家客户,涉及超过 9.5 TB 数据、超过 100 万条事项的环境。这些数字属于厂商自述,不能直接证明某个团队的迁移一定顺利。
部署和运行成本,要在试用前筛一遍
Replit 面向另一类需求:用自然语言快速构建应用,并在同一环境里获得认证、数据库、托管、监控与协作能力。它还支持并行 agents 和 checkpoints,用于保存项目状态及回滚。
这对原型有吸引力,但 Replit 是 cloud-only。已有仓库、CI/CD 流水线和内部开发规范的团队,需要检查这套应用构建环境能否接入现有流程。
部署控制是硬要求时,应当提前筛选。按原文的比较,Cursor、GitHub Copilot 和 Replit 属于云端方案;ONES.com 提供 Cloud、On-Premise、Private Cloud、Air-gapped,Augment Code 提供 On-premise、VPC 和 air-gapped 配置。Air-gapped 指与外部网络隔离的部署要求,不能用「有隐私模式」来替代。
Cursor 报告 Privacy Mode 下模型提供商零数据保留,并提到 2026 年的 SOC 2 Type II 鉴证。Augment Code 则报告 SOC 2 Type II、GDPR、CCPA、HIPAA 相关合规支持,可提供 business associate agreement,并有合同约定的不用于训练承诺。
这些表述需要核对适用范围和合同条款。原文也承认,Augment Code 的公开评测覆盖有限,部分性能数字来自自述;它同样不替代需求和交付管理。
成本也不能只算席位费。Copilot 的 chat、agent mode、code review 和 CLI 活动涉及按量计费;Cursor 超出包含额度后有 on-demand usage。高频使用时,费用预测会更困难。
此外,还有部署、管理、系统之间维护上下文的成本。统一平台可能减少重复录入,但流程配置和治理本身也要投入时间。
我的判断
我认同它把选型单位从「工具」改成「一项任务的完整路径」。代码生成只是其中一段,需求来源不清、审批责任模糊、完成状态不同步,都可能抵消局部提速。
但文章没有报告团队实测,也没有交付周期、返工率或总成本的对照数据。「统一工作区能减少上下文重复」是合理推断,实际收益仍取决于流程和配置,不能当成已经验证的结论。
它对 ONES.com 的能力与迁移经验介绍明显更充分,读者应把它视为带有产品侧重的选型文章。迁移规模说明厂商声称处理过什么,不足以说明迁移耗时、信息保真程度,以及迁移后是否更省事。
对小团队,现有 issue 模板、仓库说明、PR 评审和 CI 检查,也可能承载足够的需求与控制信息。如果这些环节已经连贯,新增项目平台未必划算。跨团队依赖、审批和报表确实难以维持时,再评估集中管理更有针对性。
先找出上下文和责任在哪里断开,再决定是否增加工具。
能拿来做什么
- 从前端或 Node 项目里选一项近期真实需求,把验收条件、依赖、代码修改、测试结果和发布状态串起来,让候选 Agent 完整走一遍,并记录人工在哪些地方补了信息。
- 试用前写清 Agent 的行动范围,例如允许修改文件和运行测试,创建分支、提交 PR、批准合并分别遵循什么规则,再检查工具是否支持这些边界。
- 已经围绕 GitHub 协作的团队,可以先检查 issue、Copilot Spaces、PR 和评审能否提供足够上下文;跨团队需求经常失联时,再比较项目平台的接入收益。
- 把部署方式、数据处理条款、包含额度、超额计费和日常管理投入放进同一份评估记录,用实际任务的使用情况估算成本。